

وانشيانغ يوشنغ منصة إنشاء محتوى صوتي شاملة بالذكاء الاصطناعي، طوّرها الفريق الأساسي السابق لمنصة «Lanren Tingshu». تدعم الإنتاج عالي الجودة بالتعاون بين ممثلين صوتيين حقيقيين والذكاء الاصطناعي، كما تدعم الإنتاج الكمي التلقائي بالكامل بتعدد الأصوات الاصطناعية، ويمكنها تقليص مدة المشاريع الكبيرة من عشرات الأيام إلى بضعة أيام.
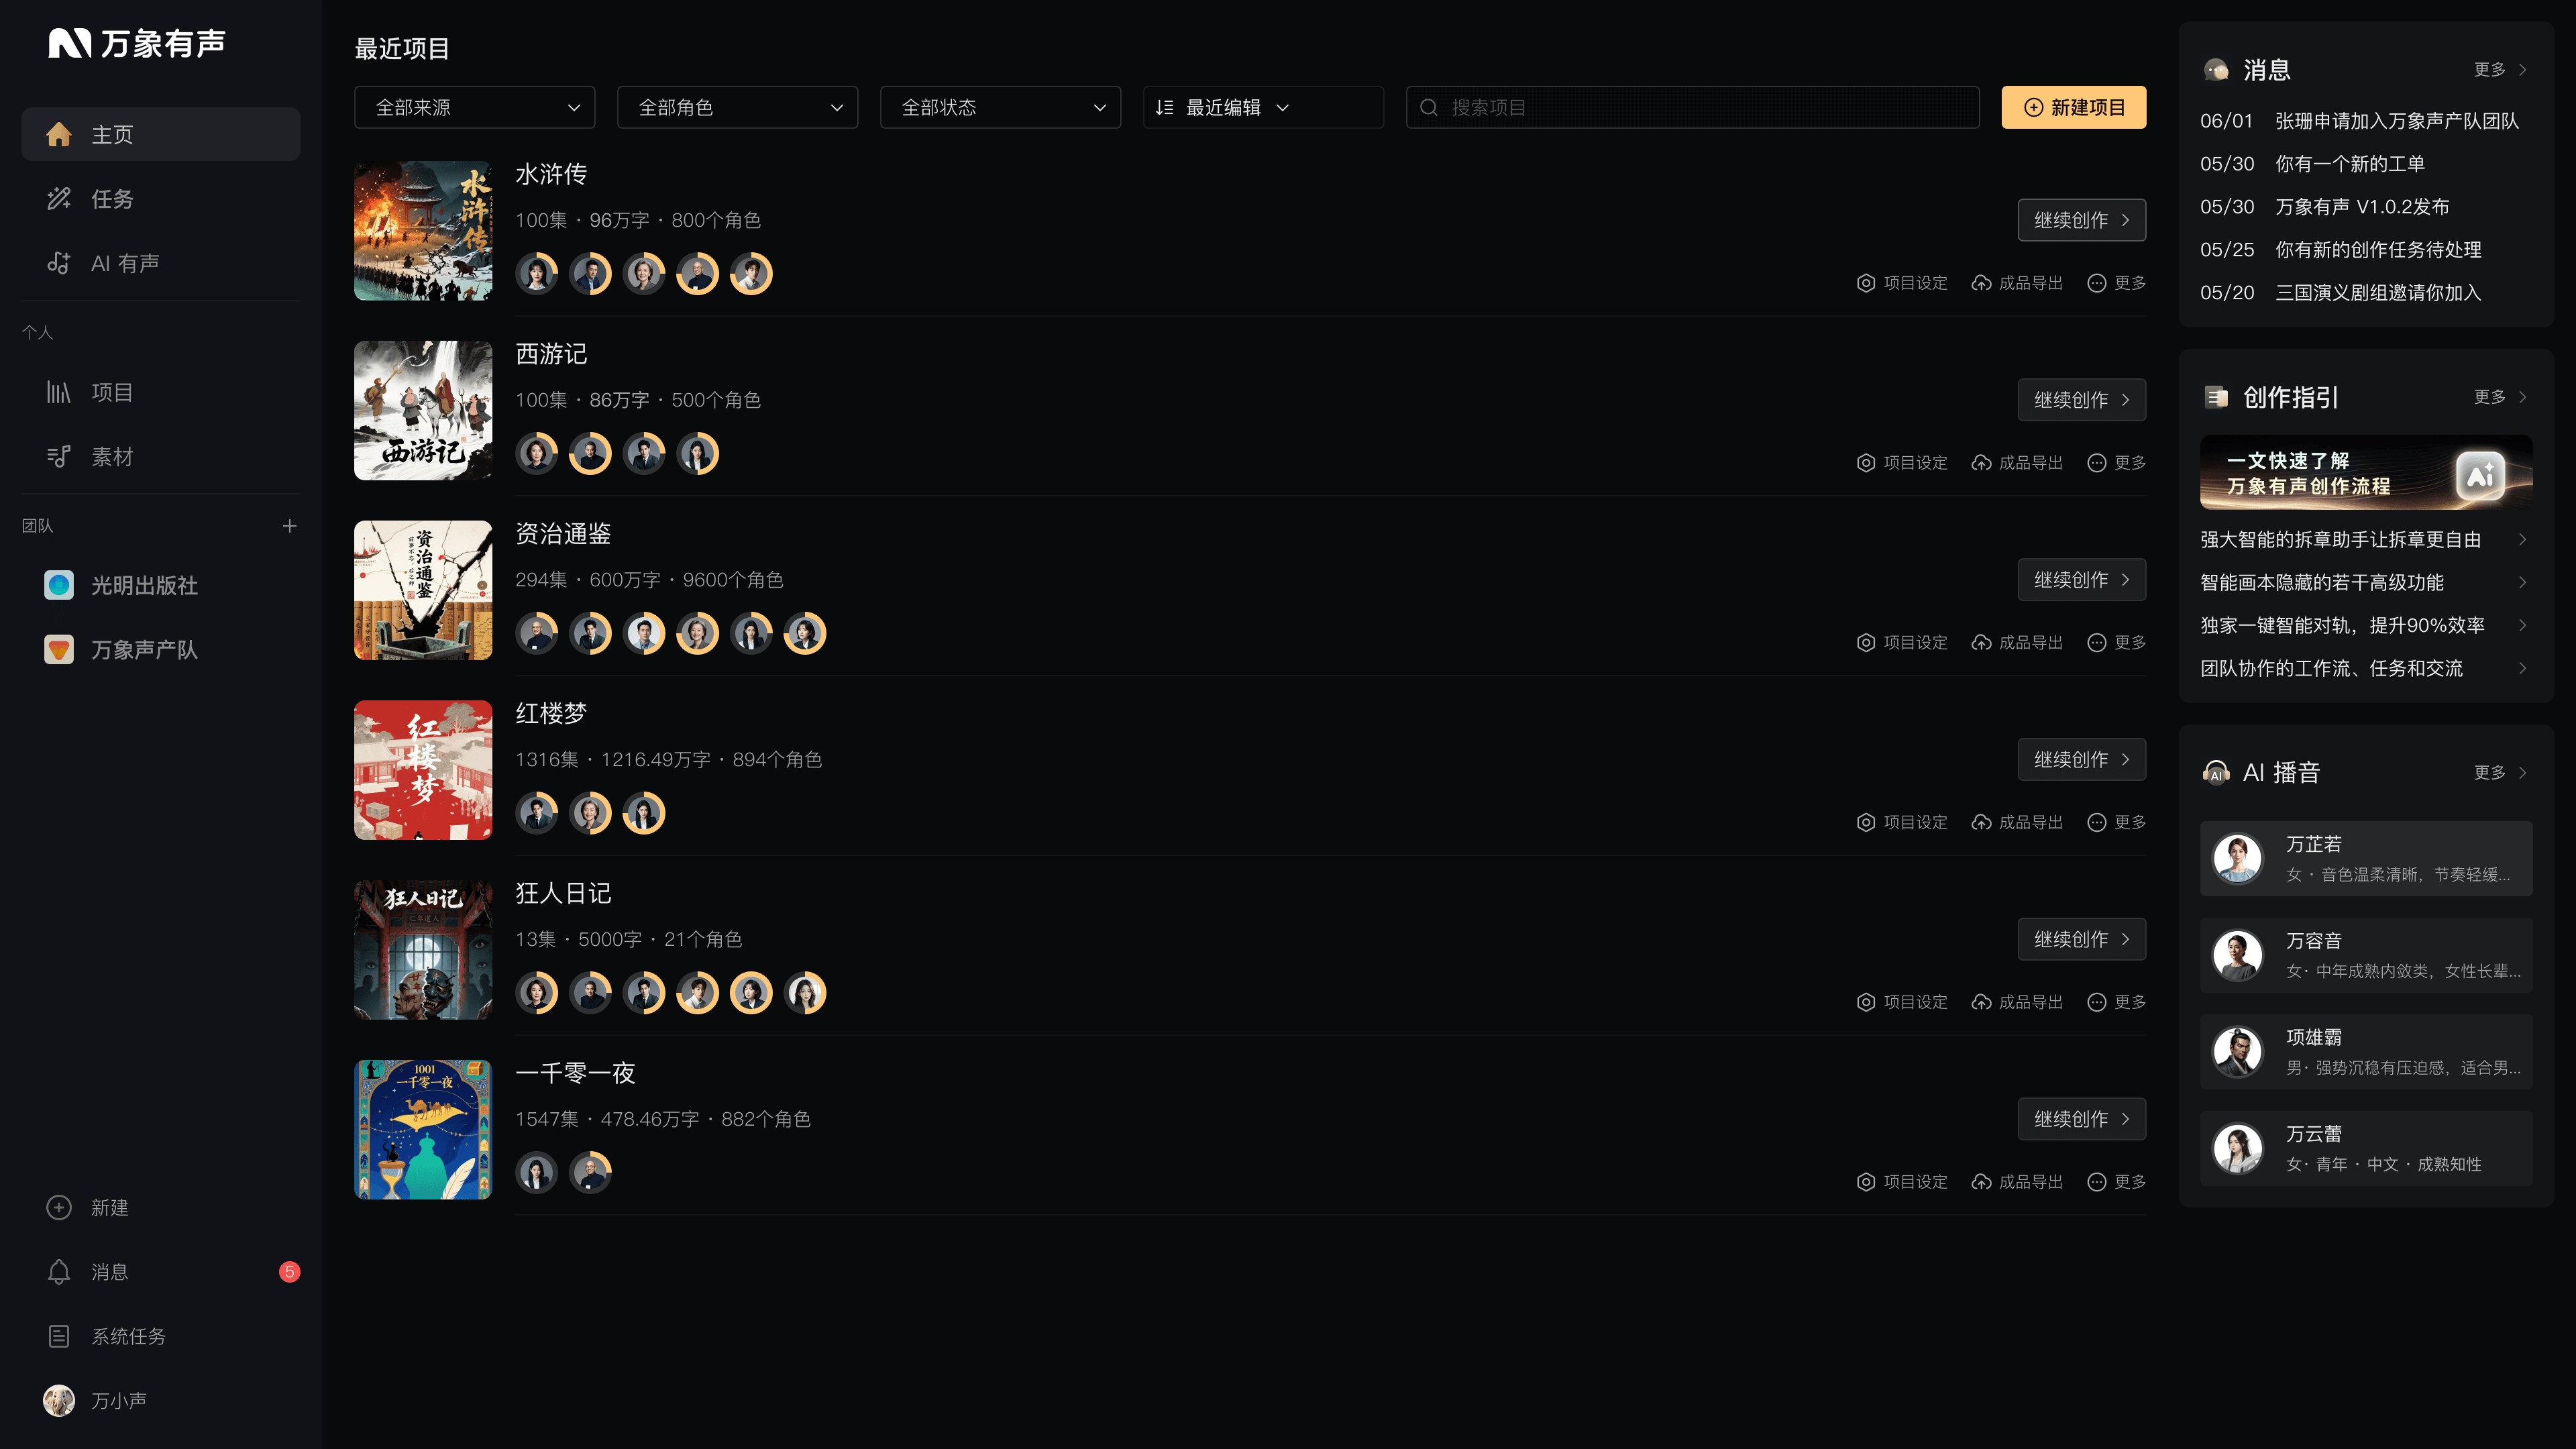
وانشيانغ يوشنغ: منصة إنشاء المحتوى الصوتي بالذكاء الاصطناعي
وانشيانغ يوشنغ (Audimind) منصة سحابية شاملة لإنتاج المحتوى الصوتي، طوّرها الفريق الأساسي السابق لمنصة «Lanren Tingshu». تغطي السلسلة الكاملة من تقسيم الفصول وإعداد السيناريو وتوليد الأصوات والمؤثرات الصوتية والمعالجة اللاحقة والمراجعة وحتى التصدير.
تعتمد المنصة على محرك «المسار المزدوج»: وضع إنتاج عالي الجودة بالتعاون بين ممثلين صوتيين حقيقيين والذكاء الاصطناعي، ووضع إنتاج كمي تلقائي بالكامل بتعدد الأصوات الاصطناعية. وتقول المنصة إن هذا التصميم يمكن أن يقلّص مدة المشاريع الكبيرة من عشرات الأيام إلى بضعة أيام.
ما هي وانشيانغ يوشنغ؟
هي أداة SaaS لإنتاج المحتوى الصوتي، تقدم نفسها تحت شعار «اجعل كل قصة تتحول إلى صوت بسهولة». ووفقًا للمعلومات الرسمية، يضم فريقها الأساسي المؤسس/الرئيس التنفيذي، ونائب الرئيس للمنتج، ونائب الرئيس للتقنية، ومدير إنتاج المحتوى من المنصة السابقة «Lanren Tingshu»، ولديهم أكثر من عشر سنوات من الخبرة في صناعة الصوت.
يعمل المحرك وفق مسارين رئيسيين:
- وضع الإنتاج عالي الجودة: تعاون بين ممثل صوتي حقيقي (CV) والذكاء الاصطناعي، ويناسب الدراما الإذاعية والأعمال متعددة الأصوات التي تتطلب أداءً أعلى.
- وضع الإنتاج الكمي التلقائي: توليد تلقائي متعدد الأصوات بالذكاء الاصطناعي، ويناسب الكتب الصوتية بكميات كبيرة وتحويل نصوص الروايات الرقمية إلى محتوى صوتي.
الوظائف الأساسية
التقسيم الذكي للفصول
يتعرف النظام تلقائيًا على بنية النص ويقسّم الفصول، ويدعم إعادة التقسيم حسب عدد الكلمات مع تسمية الفصول، لتنظيم المحتوى الطويل.
تحرير السيناريو الذكي
يتعرف النظام تلقائيًا على السرد والحوار بين الشخصيات، وينشئ سيناريو صوتيًا مرئيًا. كما يولّد ملفات تعريف للشخصيات، ويضيف وسومًا عاطفية للحوار، ويحدد نطق الحروف النادرة ومتعددة القراءات لمساعدة الممثلين على الدخول إلى أدوارهم بسرعة.
توليد الأصوات بالذكاء الاصطناعي
- مكتبة أصوات اصطناعية كبيرة: ما يقرب من ألف صوت بخصائص مختلفة حسب الجنس والعمر والأسلوب.
- استنساخ الصوت: إنشاء صوت خاص من عينة صوتية.
- تخصيص الصوت: توليد صوت بالذكاء الاصطناعي بمواصفات الأسلوب والعمر والجنس عبر الوصف النصي.
- يستطيع الذكاء الاصطناعي اقتراح أنسب الأصوات لمجموعة شخصيات بناءً على ملفاتها.
المؤثرات الصوتية والموسيقى بالذكاء الاصطناعي
يمكن توليد مؤثرات صوتية بوصف نصي، مثل «بعد ظهر صيفي، وصوت رعد قادم من بعيد»، حتى 20 ثانية. ووظيفة إنتاج الموسيقى الخلفية قيد الإطلاق المرتقب.
محطة التسجيل والمونتاج المتكاملة
تتيح القراءة من النص والتسجيل والمونتاج في الوقت نفسه، مع مخطط زمني مرئي لشكل الموجة في الأسفل لتحرير دقيق. وتدعم تحرير المسارات المتعددة وتقليل الضوضاء والتلاشي التدريجي، وتلائم المؤثرات المشهدية مثل صوت الهاتف والصدى.
المزامنة الذكية
بعد رفع تسجيل خام طويل من برنامج احترافي، يتعرف النظام تلقائيًا على الكلام، ويقسّمه ويطابقه بدقة مع كل جملة في السيناريو. وتذكر المنصة أن المزامنة والمراجعة يمكن أن تنخفض من ساعات إلى دقائق، مع رفع كفاءة المعالجة اللاحقة بنسبة 90%.
المراجعة الذكية
يقارن الذكاء الاصطناعي المحتوى الصوتي مع النص الأصلي حرفًا بحرف، ويحدد مشكلات مثل «الكلمات المقروءة الناقصة أو الزائدة»، ويتحقق تلقائيًا من تطابق الصوت مع نص السيناريو.
إدارة وتصدير المنتج النهائي
توفر إدارة موحدة للمنتجات، وتدعم التصدير المجمّع عبر API والتكامل مع أنظمة ERP.
التعاون الجماعي
تدعم التبديل بين فرق متعددة، وتوزيع المهام، والإشعارات، وإدارة صلاحيات الأعضاء، بما يناسب فرق الإنتاج الكبيرة.
أمان حقوق النشر
تتضمن أدوات مدمجة لاعتراض المحتوى الحساس وتوثيقًا عبر سلسلة الكتل للحد من مخاطر التعدي. وتحمل المنصة رخصة إنتاج البرامج الإذاعية والتلفزيونية رقم: (Yue) Zi 07504.
خطوات الاستخدام
- التسجيل وتسجيل الدخول: تفضل بزيارة الموقع الرسمي https://www.audimind.com/ وسجّل حسابًا. يمنح الإصدار المجاني 30 دقيقة يوميًا من مدة توليد الصوت بالذكاء الاصطناعي.
- إنشاء مشروع: انقر على «مشروع جديد»، واستورد نصًا أو أنشئ مشروعًا فارغًا، ثم حدد اسم المشروع والمعلومات الأساسية.
- التقسيم الذكي للفصول: استخدم مساعد تقسيم الفصول ليتعرف النظام تلقائيًا على بنية النص ويقسّم المحتوى الطويل إلى فصول وحلقات.
- الدخول إلى تحرير السيناريو: يتعرف النظام تلقائيًا على السرد والحوار، وينشئ سيناريو صوتيًا مرئيًا، ويمكن تعديل الشخصيات والحوار يدويًا.
- توزيع الأصوات: اختر صوتًا من مكتبة الأصوات الاصطناعية، أو أنشئ صوتًا خاصًا عبر استنساخ الصوت أو تخصيص الصوت، وخصص لكل شخصية صوتًا مناسبًا.
- توليد أو تسجيل الصوت: في وضع الذكاء الاصطناعي يتم توليد الصوت مباشرة؛ وفي الوضع البشري يمكن القراءة من النص والتسجيل في الوقت نفسه، وجمع التسجيل الخام عبر محطة التسجيل والمونتاج.
- المزامنة الذكية: بعد رفع التسجيل الخام، استخدم المزامنة الذكية بخطوة واحدة لمحاذاة الصوت مع الحوار بدقة.
- إضافة المؤثرات الصوتية والموسيقى: ولّد مؤثرات صوتية بالذكاء الاصطناعي لإضفاء أجواء على المشاهد؛ علمًا بأن وظيفة الموسيقى الخلفية قيد الإطلاق المرتقب.
- المراجعة الجماعية: ادعُ أعضاء الفريق للمراجعة عبر السحابة، وأضف الملاحظات والتعديلات عبر الإنترنت لإنجاز فحص الجودة.
- تصدير المنتج النهائي: بعد التأكد، صدّر الصوت النهائي بصيغ متعددة، مع إمكانية الربط المجمّع عبر API.
حالات الاستخدام المناسبة
- إنتاج الكتب الصوتية: تحويل الروايات الطويلة والأعمال الأدبية الكلاسيكية مثل «Hong Lou Meng» و«Shui Hu Zhuan» بسرعة إلى كتب صوتية عالية الجودة، مع دعم السرد الفردي والدراما الصوتية متعددة الأصوات.
- الدراما الإذاعية والأعمال متعددة الأصوات: الجمع بين الأصوات المتعددة بالذكاء الاصطناعي والممثلين الصوتيين الحقيقيين لإنتاج أعمال درامية بعلاقات شخصيات معقدة، ودعم مشاريع تضم آلاف الشخصيات.
- تحويل الروايات الرقمية إلى محتوى صوتي: مساعدة منصات الروايات وأصحاب الحقوق على تحويل نصوص متوسطة وطويلة الأمد إلى صوت بكميات كبيرة، وخفض تكلفة إنتاج العمل الواحد.
- المحتوى المدفوع والدورات التعليمية: توفير أصوات سردية هادئة وعميقة للشرح المعرفي والمحتوى التدريبي، ودعم الإنتاج الفعال للدورات الصوتية الطويلة.
- التعليق الصوتي للفيديو القصير ومنصات المحتوى: استخدام ميزة توليد الصوت القصير لإنتاج تعليقات صوتية عالية الجودة بسرعة لمقاطع الفيديو القصيرة والمحتوى الذاتي، مع دعم أنماط متعددة.
- الإعلانات والدعاية للشركات: تقديم تعليق صوتي احترافي للأفلام الدعائية والإعلانية، مع دعم تخصيص الصوت ليتوافق مع هوية العلامة التجارية.
أبرز المزايا
- سلسلة عمل مغلقة: إنجاز تقسيم الفصول، وإعداد السيناريو، وتوليد الأصوات، والمؤثرات الصوتية، والمعالجة اللاحقة، والمراجعة، والتصدير في منصة واحدة دون التنقل بين أدوات متعددة.
- رفع الكفاءة: تذكر المنصة أن المزامنة الذكية ترفع كفاءة المعالجة اللاحقة بنسبة 90%، ويمكن أن تنخفض مدة المشروع من 30 يومًا إلى 5–7 أيام.
- ميزة التكلفة: في وضع الإنتاج الكمي بالذكاء الاصطناعي فقط، يمكن أن تنخفض تكلفة إنتاج الساعة الواحدة بنحو 70%.
- إدارة أعداد كبيرة من الشخصيات: تدعم آلاف الشخصيات، كما في مشروع «Zizhi Tongjian» الذي يضم 9600 شخصية درامية مع توزيع وإدارة منهجية للحوار.
- حزمة تقنيات ذكاء اصطناعي متقدمة: قاموس نطق بمستوى ملايين المداخل لحل مشكلات الحروف النادرة، ونموذج انفعالي إيقاعي يجعل الصوت الاصطناعي أكثر إنسانية، وتقنية إعادة رسم ذكية تخفض تكلفة الحوسبة بنسبة 90%.
- منظومة أصوات غنية: مكتبة أصوات اصطناعية واسعة، واستنساخ الصوت، وتخصيص الصوت.
قيود وتنبيهات
وفقًا للمعلومات المنشورة، هناك نقاط يجب الانتباه إليها في وانشيانغ يوشنغ:
- يمنح الإصدار المجاني 30 دقيقة يوميًا فقط من مدة توليد الصوت بالذكاء الاصطناعي، ويجب مراجعة قواعد الجزء الإضافي وفقًا لما يوضحه الموقع الرسمي.
- يمكن توليد المؤثرات الصوتية بالذكاء الاصطناعي بحد أقصى 20 ثانية، وقد تكون المؤثرات الأطول أو الأكثر تعقيدًا محدودة.
- وظيفة الموسيقى الخلفية قيد الإطلاق المرتقب، وقد لا تكون متاحة للاستخدام حاليًا.
- قد تتغير إتاحة الوظائف والأسعار وقواعد الترخيص التجاري مع تحديثات الإصدار، لذا يجب الرجوع إلى أحدث توضيحات الموقع الرسمي.
ملاحظة حول التحقق من الأسعار
لا تقدم هذه المقالة أسعارًا محددة، لأن الأسعار والباقات وحصص النسخة المجانية معلومات قابلة للتغير. يُرجى زيارة الموقع الرسمي https://www.audimind.com/ للاطلاع على أحدث التسعيرات وقواعد النسخة المجانية وشروط خدمة API.
بدائل محتملة
لا تسرد المعلومات المنشورة منافسين محددين لمنصة وانشيانغ يوشنغ ضمن الفئة نفسها. وتؤكد المنصة على أن محرك «المسار المزدوج» وسلسلة العمل المغلقة هما ميزتان فارقتان. وإذا كنت بحاجة إلى مقارنة أدوات أخرى، فمن الأفضل التقييم حسب احتياجات مختلفة مثل الكتب الصوتية، والدراما الإذاعية، والتعليق الصوتي للفيديو القصير، مع النظر في عدد الأصوات، وإدارة الشخصيات، وكفاءة المزامنة، والتعاون الجماعي، وقدرات التصدير المجمّع لكل منصة.
الأسئلة الشائعة (FAQ)
ما هي وانشيانغ يوشنغ؟
وانشيانغ يوشنغ منصة إنشاء محتوى صوتي شاملة بالذكاء الاصطناعي، طوّرها الفريق الأساسي السابق لمنصة «Lanren Tingshu». تغطي السلسلة الكاملة من تقسيم الفصول وإعداد السيناريو وتوليد الأصوات والمؤثرات الصوتية والمعالجة اللاحقة والمراجعة وحتى التصدير.
هل تدعم وانشيانغ يوشنغ الجمع بين التمثيل الصوتي البشري والذكاء الاصطناعي؟
نعم. يدعم محرك «المسار المزدوج» الإنتاج عالي الجودة بالتعاون بين ممثلين صوتيين حقيقيين والذكاء الاصطناعي، كما يدعم الإنتاج الكمي التلقائي بالكامل بتعدد الأصوات الاصطناعية. وتساعد محطة التسجيل والمونتاج والمزامنة الذكية على دمج التسجيل البشري مع المعالجة اللاحقة بالذكاء الاصطناعي بكفاءة.
كم يمكن استخدام الإصدار المجاني من وانشيانغ يوشنغ؟
يمنح الإصدار المجاني 30 دقيقة يوميًا من مدة توليد الصوت بالذكاء الاصطناعي. وبعد تجاوزها يجب مراجعة قواعد الفوترة أو الحصص الرسمية، وتُعتمد التفاصيل من الموقع الرسمي.
كم عدد الشخصيات التي يمكن أن تتعامل معها وانشيانغ يوشنغ في المشاريع الكبيرة؟
تذكر المنصة أنها تدعم مشاريع معقدة تضم آلاف الشخصيات، وتستشهد بمشروع «Zizhi Tongjian» الذي يضم 9600 شخصية درامية، مع توزيع وإدارة منهجية للحوار.
ما المدة القصوى للمؤثرات الصوتية التي تولدها وانشيانغ يوشنغ بالذكاء الاصطناعي؟
يمكن توليد مؤثرات صوتية تصل إلى 20 ثانية عبر الوصف النصي، بينما وظيفة الموسيقى الخلفية قيد الإطلاق المرتقب.
الخلاصة
طوّر الفريق الأساسي السابق لمنصة Lanren Tingshu منصة وانشيانغ يوشنغ (Audimind) بوصفها منصة جيلًا جديدًا لإنشاء المحتوى الصوتي. ومن خلال سلسلة عمل مغلقة، ومحرك «المسار المزدوج»، ومكتبة أصوات اصطناعية غنية، تساعد الأفراد والمؤسسات على تحويل النصوص إلى أعمال صوتية عالية الجودة بكفاءة أكبر. ولمزيد من التفاصيل، يُنصح بزيارة الموقع الرسمي مباشرة.
الأسئلة الشائعة
ما هي وانشيانغ يوشنغ؟
وانشيانغ يوشنغ منصة إنشاء محتوى صوتي شاملة بالذكاء الاصطناعي، طوّرها الفريق الأساسي السابق لمنصة «Lanren Tingshu». تغطي السلسلة الكاملة من تقسيم الفصول وإعداد السيناريو وتوليد الأصوات والمؤثرات الصوتية والمعالجة اللاحقة والمراجعة وحتى التصدير.
هل تدعم وانشيانغ يوشنغ الجمع بين التمثيل الصوتي البشري والذكاء الاصطناعي؟
نعم. يدعم محرك «المسار المزدوج» الإنتاج عالي الجودة بالتعاون بين ممثلين صوتيين حقيقيين والذكاء الاصطناعي، كما يدعم الإنتاج الكمي التلقائي بالكامل بتعدد الأصوات الاصطناعية. وتساعد محطة التسجيل والمونتاج والمزامنة الذكية على دمج التسجيل البشري مع المعالجة اللاحقة بالذكاء الاصطناعي بكفاءة.
كم يمكن استخدام الإصدار المجاني من وانشيانغ يوشنغ؟
يمنح الإصدار المجاني 30 دقيقة يوميًا من مدة توليد الصوت بالذكاء الاصطناعي. وبعد تجاوزها يجب مراجعة قواعد الفوترة أو الحصص الرسمية، وتُعتمد التفاصيل من الموقع الرسمي.
كم عدد الشخصيات التي يمكن أن تتعامل معها وانشيانغ يوشنغ في المشاريع الكبيرة؟
تذكر المنصة أنها تدعم مشاريع معقدة تضم آلاف الشخصيات، وتستشهد بمشروع «Zizhi Tongjian» الذي يضم 9600 شخصية درامية، مع توزيع وإدارة منهجية للحوار.
ما المدة القصوى للمؤثرات الصوتية التي تولدها وانشيانغ يوشنغ بالذكاء الاصطناعي؟
يمكن توليد مؤثرات صوتية تصل إلى 20 ثانية عبر الوصف النصي، بينما وظيفة الموسيقى الخلفية قيد الإطلاق المرتقب.



