

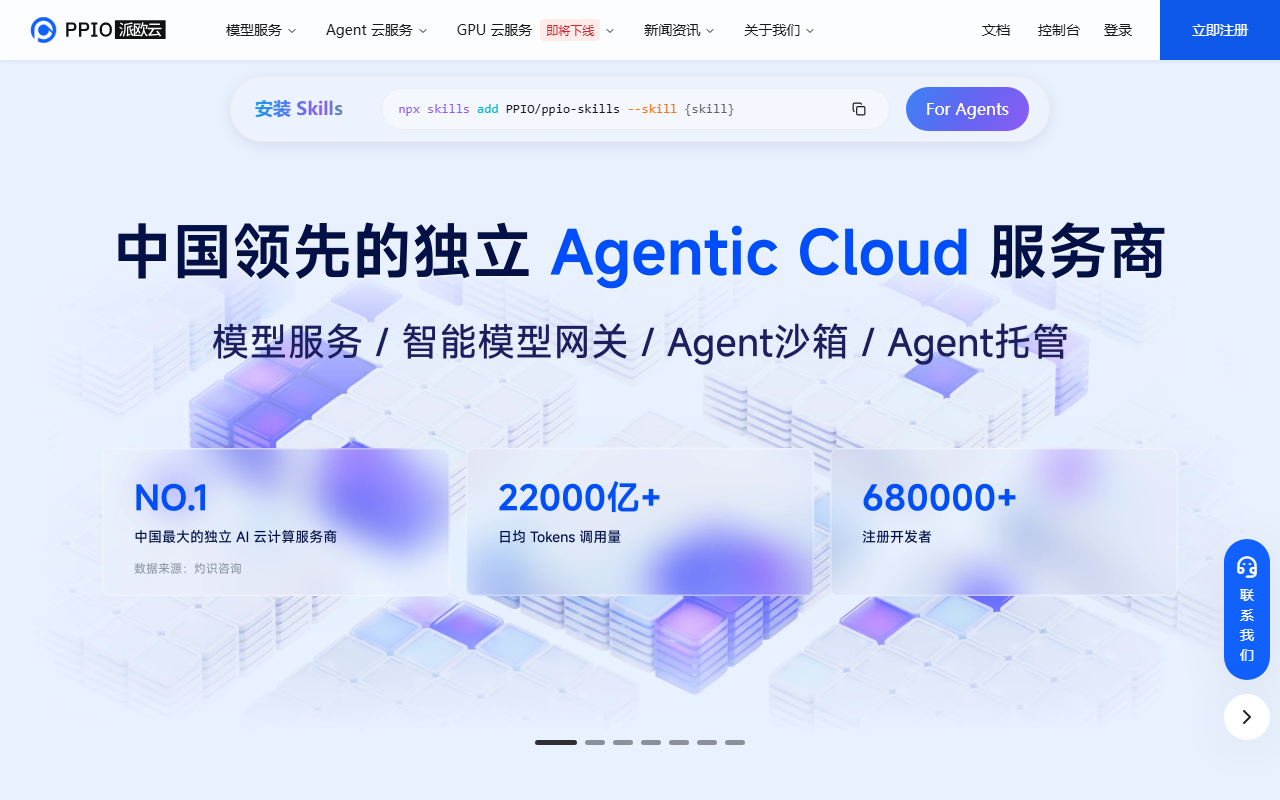
PPIO Paiouyun ist eine verteilte Cloud-Plattform, die verstreute GPU-Ressourcen zu einem Rechennetz bündelt: KI-Funktionen lassen sich über OpenAI-kompatible APIs oder bedarfsweise GPU-Instanzen umsetzen, Unternehmen können einen dedizierten privaten Cluster wählen.
Was PPIO Paiouyun ist
PPIO Paiouyun ist ein Anbieter verteilter Cloud-Computing-Leistungen, der Serverkapazitäten am Netzrand und in regionalen Rechenzentren zu einem gemeinsamen Rechennetz bündelt. Das Unternehmen verbindet ein Sharing-Economy-Modell mit Big-Data-, Cloud-Native- und verteilten Rechentechniken und liefert diese Kapazität als KI-Inferenz-APIs, GPU-Instanzen und Branchenlösungen aus. Die wichtigsten Geschäftsbereiche sind KI-Inferenz-Cloud, Audio- und Videolösungen, Cloud-Rendering für Metaverse-Anwendungen sowie private Bereitstellung für Unternehmen. Die offizielle Produktseite ist ppio.cn.
Anders als eine klassische Public Cloud, die vor allem virtuelle Maschinen aus eigenen Rechenzentren verkauft, versteht sich PPIO als Aggregator und Scheduler für Rechenleistung. Auf der einen Seite bündelt die Plattform heterogene Ressourcen – Hyperscale-Rechenzentren, regionale Rechenknoten und ungenutzte Geräte. Auf der anderen Seite stellt sie diese über eine einheitliche Konsole, eine gemeinsame API und eine eigene Inferenz-Beschleunigung bereit. Auch neuere Modelle wie DeepSeek-R1-0528 sind verfügbar und lassen sich per API aufrufen oder direkt im Modellbereich testen.
Zentrale Funktionen
Modell-API
Die Plattform bietet APIs für große Sprachmodelle sowie für Bild- und Videogenerierung. Die Endpunkte folgen dem OpenAI-API-Standard, sodass in den meisten Projekten nur Basis-URL, Schlüssel und Modellname geändert werden müssen und bestehender OpenAI-SDK-Code weiterläuft. PPIO nennt eine Stabilität von bis zu 99,9 % und unterstützt den Wechsel zwischen multimodalen Modellen in Sekunden samt Inferenzbeschleunigung – hilfreich für Teams, die mehrere Modelle vergleichen oder Text- und Bildgenerierung in einem Produkt mischen.
GPU-Cloud
GPU-Kapazität gibt es in zwei Formen. GPU-Containerinstanzen liefern containerisierte GPU-Ressourcen mit nutzungsbasierter Abrechnung, fertigen Images und Ein-Klick-Deployment; passend für Training, Fine-Tuning und Batch-Inferenz, wenn Sie die Umgebung selbst kontrollieren. Serverless-GPUs richten sich an eigene Modelle ohne Infrastrukturbetrieb und bieten automatische Skalierung, Lastverteilung und Kaltstarts in Sekunden – geeignet für Online-Inferenz mit schwankendem Traffic.
Audio- und Videolösungen
Auf Basis breit verteilter Edge-Knoten und langjähriger Medien-Erfahrung verbindet diese Linie Hardware, Netzwerk und Medientechnik für lang- und kurzes Video-on-Demand, Entertainment-Livestreaming, Videoanrufe und interaktive Livestreams. Versprochen wird ein durchgängiger Stack mit hoher Qualität, niedrigen Kosten und stabiler Auslieferung.
Cloud-Rendering und Metaverse
Mit professioneller Open-Source-Grafiksoftware auf Edge-Rechenleistung bietet die Plattform automatisch bereitgestelltes Cloud-Rendering für Metaverse-Anwendungen, die Assets oder Frames remote berechnen müssen.
Private Bereitstellung für Unternehmen
Für Organisationen, die keine Daten in eine geteilte Cloud geben dürfen, gibt es einen dedizierten GPU-Cluster mit vollständig gemanagtem Betrieb: Der Modell-Stack läuft in einer von der Firma kontrollierten Umgebung, der Tagesbetrieb bleibt beim Anbieter.
Erste Schritte
- Konto anlegen auf der offiziellen Seite per Telefonnummer oder Kontonamen.
- Identität verifizieren – die persönliche oder betriebliche Prüfung ist Voraussetzung für Rechenleistung und API.
- Guthaben aufladen auf der Kontoübersicht; Alipay, WeChat Pay und Firmenüberweisung werden unterstützt.
- API-Schlüssel erzeugen in der Schlüsselverwaltung, falls Sie die API nutzen, und niemals in Frontend-Code oder öffentliche Repositories legen.
- Modell aufrufen: Im Modellbereich eine Karte wählen, das Testpanel öffnen und mit eigenen Parametern starten. Für die Integration einen OpenAI-kompatiblen Client auf den Plattform-Endpunkt mit Schlüssel und Modellnamen zeigen lassen; Python-Code lässt sich meist unverändert weiterverwenden.
- GPU starten: Containerinstanzen oder Serverless-Deployments in der Konsole anlegen, Spezifikation, Image oder Modell und Skalierungsregeln festlegen.
Geeignete Einsatzfelder
- KI-Produkte ausliefern: Chat, Textarbeit, Bild- und Videogenerierung ohne eigenen Inferenz-Cluster.
- Video und Livestreaming: Transcoding und Auslieferung für On-Demand, Entertainment und interaktive Streams.
- Batch-Rendering: Film, Architekturvisualisierung, Metaverse-Szenen.
- Elastische Kapazität: Traffic-Spitzen oder zeitlich begrenzte Trainingsjobs zum Verbrauchspreis.
- Autonomes Fahren und Forschung: Aufgaben mit geringer Latenz, hoher Bandbreite oder massivem Parallelrechnen.
Grenzen und Prüfpunkte
- Werte wie 99,9 % Stabilität, Kaltstart in Sekunden und sofortiger Modellwechsel sind Angaben des Anbieters. Hier wurden sie nicht unabhängig gemessen; testen Sie vor der Entscheidung mit eigenem Traffic.
- Die Abrechnung kombiniert Prepaid und Nutzung; die Identitätsprüfung ist Pflicht. Preise, Freikontingente und Rabatte kommen aus Konsole und Vertrieb – dieser Artikel nennt keine Tarife.
- Der Modellkatalog ändert sich. Ob DeepSeek-R1-0528 und andere Modelle verfügbar sind, prüfen Sie im Modellbereich zum Nutzungszeitpunkt.
- Audio-/Videolösungen und private Bereitstellung sind B2B-Projekte mit Vertriebsprozess, kein sofortiges Self-Service-Angebot.
- API-Schlüssel sind sensibel: Eine geleakte Kennung kann echte Kosten verursachen, daher pro Projekt trennen und regelmäßig rotieren.
Häufige Fragen
Worin unterscheidet sich das von einer üblichen Public-Cloud-GPU? Eine übliche Public Cloud verkauft überwiegend Instanzen aus eigenen Rechenzentren. PPIO bündelt heterogene Edge- und Regionalkapazität und stellt sie über eine gemeinsame API und Scheduling-Schicht bereit: dieselbe Konsole bietet nutzungsbasierte GPUs, Serverless-Deployments und OpenAI-kompatible APIs. Das passt zu Teams, die heute eine gemanagte API wollen und später vielleicht einen eigenen Stack.
Wie aufwendig ist die Migration eines Projekts, das bereits das OpenAI-SDK nutzt? Meist ändern sich drei Einstellungen: Basis-URL, API-Schlüssel und Modellname. Die Geschäftslogik bleibt unangetastet. Führen Sie vor dem Umstellen eine Regression in der Staging-Umgebung durch, die Streaming und Tool-Aufrufe abdeckt.
Braucht ein kleiner Test schon eine GPU-Instanz? Nein. Testen Sie zuerst im Modellbereich und rufen Sie die API verbrauchsbasiert auf; das ist günstiger als eine dauerhaft laufende Instanz. Wechseln Sie zu GPU-Instanzen oder Serverless, wenn Sie eigene Modelle, spezielle Abhängigkeiten oder planbare Latenz brauchen.
Kann ein Unternehmen die Modelldaten im eigenen Umfeld halten? Ja, über die Option aus dediziertem GPU-Cluster plus vollständig gemanagtem privatem Deployment. Clustergröße, Netzisolierung und Lieferzeiten werden mit dem Vertrieb vereinbart.

Häufig gestellte Fragen
Worin unterscheidet sich das von einer üblichen Public-Cloud-GPU?
Eine Public Cloud verkauft überwiegend eigene Instanzen. PPIO bündelt heterogene Edge- und Regionalkapazität und stellt sie über eine gemeinsame API und Scheduling-Schicht bereit: nutzungsbasierte GPUs, Serverless und OpenAI-kompatible APIs in einer Konsole.
Wie aufwendig ist die Migration eines Projekts mit OpenAI-SDK?
Meist ändern sich Basis-URL, API-Schlüssel und Modellname; die Geschäftslogik bleibt. Vor dem Umstellen eine Staging-Regression mit Streaming und Tool-Aufrufen fahren.
Braucht ein kleiner Test schon eine GPU-Instanz?
Nein. Erst im Modellbereich testen, dann die API verbrauchsbasiert nutzen – günstiger als eine Dauerinstanz. GPU oder Serverless erst bei eigenen Modellen oder planbarer Latenz.
Kann ein Unternehmen die Daten im eigenen Umfeld halten?
Ja, mit dediziertem GPU-Cluster und vollständig gemanagtem privatem Deployment; Clustergröße, Netzisolierung und Lieferzeiten werden mit dem Vertrieb vereinbart.



