Teamo ist ein Multiagenten-KI-Produkt des Xixiaoyao-Teams, positioniert als Superagent im A2A-Paradigma für Wissensarbeiter. Es bearbeitet komplexe Aufgaben wie ein simuliertes Team: Ein CEO Agent führt Such-, Beratungs-, Schreib- und Designgruppen mit unterschiedlichen KI-Modellen und durchläuft Aufgabenverständnis, Zerlegung, Mehrquellensuche, Kreuzprüfung, Analyse und strukturierte Erzeugung. Man interagiert mit jeder Rolle und kann jederzeit eingreifen, während Fortschritt, Quellen und Entwürfe live sichtbar sind; Vorlagen für SWOT, Businessplan und wissenschaftliche Arbeiten legen die Ausgabe fest, und Gruppenleiter bewerten Mitglieder, sodass man aus bewerteten Kandidaten wählt.
Teamo: ein A2A-Multiagentenaufbau, der einen Bericht an ein kleines virtuelles Team gibt
Teamo ist ein Multiagenten-KI-Produkt des Xixiaoyao-Teams, vom Hersteller als Superagent im A2A-Paradigma für Wissensarbeiter beschrieben. Der Ansatz ist nicht, ein Modell stärker zu machen, sondern die Aufgabe auf ein simuliertes Team zu verteilen: Ein Kapitänsagent führt Such-, Beratungs-, Schreib- und Designgruppen, deren Mitglieder unterschiedliche Modelle sind, und die Teile werden zu einem Ergebnis zusammengesetzt. Man steuert Agenten nach Rolle und gibt ihnen Anweisungen oder Korrekturen, statt im Chatfenster denselben Text immer wieder umzuschreiben.
Der Engpass komplexer Wissensarbeit liegt selten im Schreiben. Er liegt davor: zu entscheiden, was gesucht wird, wo, welche Quellen sich widersprechen und welche Zahlen gegengeprüft werden müssen. In eine einzige Unterhaltung gepackt, überspringt ein Modell gern die Prüfung und liefert eine sichere Antwort, ohne erkennen zu lassen, wo es danebenlag. Teamo macht diese Kette explizit und führt Aufgabenverständnis, Planung und Zerlegung, Suche in mehreren Quellen, Kreuzprüfung, Analyse und strukturierte Erzeugung als getrennte Schritte aus, jeweils von passenden Agenten.
Der zweite Schwerpunkt ist der sichtbare Prozess. Fortschritt, gefundene Quellen, Analyseschritte und Entwürfe sind in Echtzeit einsehbar. Das zielt direkt auf das Halluzinationsproblem: Statt zu verlangen, dass das Modell nie irrt, entstehen Gelegenheiten, einen Fehler mitten im Ablauf zu bemerken. Zugleich kann man eingreifen, umlenken, Material ergänzen oder einen Schritt verwerfen, bevor das Endergebnis zusammengesetzt wird.
Der dritte Schwerpunkt ist die Heterogenität der Modelle. Die Gruppen bestehen aus unterschiedlichen Modellen, die Text-, Daten-, Bild- und Codefähigkeiten szenariobezogen verteilen, und Gruppenleiter bewerten die Arbeit ihrer Mitglieder, sodass konkurrierende Kandidaten verglichen und der beste gewählt wird. Ob das die Qualität wirklich hebt, hängt von der Routingstrategie ab, strukturell bietet es aber etwas, was ein einzelner Chat nicht kann: mehrere vergleichbare Kandidaten und eine Hierarchie, die einen schwachen Schritt benennen kann.
Was Teamo leistet
Multiagenten-Zusammenarbeit
Simulierte Teamstruktur: Ein Kapitänsagent (CEO Agent) führt Such-, Beratungs-, Schreib- und Designgruppen, deren Mitglieder unterschiedliche KI-Modelle sind und eine Aufgabe aufteilen.
Such- und Schreibpipeline
Ein durchgehender Weg von Aufgabenverständnis und Zerlegung über Mehrquellensuche und Kreuzprüfung bis Analyse und strukturierter Erzeugung, gedacht für Berichte, Marktanalysen und wissenschaftliche Entwürfe, die Belege brauchen.
Rollenbasierte Interaktion
Man spricht mit einer konkreten Funktion statt mit einem Allzweckassistenten und gibt der zuständigen Rolle Anweisungen oder Feinjustierung, was näher an Teamführung als an Parameterabstimmung liegt.
Transparenter, nachvollziehbarer Ablauf
Fortschritt, gefundene Quellen, Analyseschritte und Entwürfe sind live sichtbar, sodass die Frage, wie eine Schlussfolgerung entstand, während des Laufs beantwortet wird.
Szenariobezogenes Modellrouting
Text-, Daten-, Bild- und Codemodelle werden je nach Szenario kombiniert und mehrere Aufgaben zugleich ausgelöst, was den Wechsel zwischen getrennten Werkzeugen reduziert.
Strukturierte Ausgabevorlagen
Vorlagen für SWOT-Analyse, Businessplan und wissenschaftliche Arbeit legen Format und Felder fest, damit die Struktur nicht jedes Mal neu beschrieben werden muss.
Iteration und automatische Bewertung
Man kann jederzeit eingreifen, um die Richtung zu ändern oder Informationen zu ergänzen, und Agenten treten gegeneinander an, während Gruppenleiter bewerten, sodass man aus bewerteten Kandidaten wählt.
So wird es benutzt
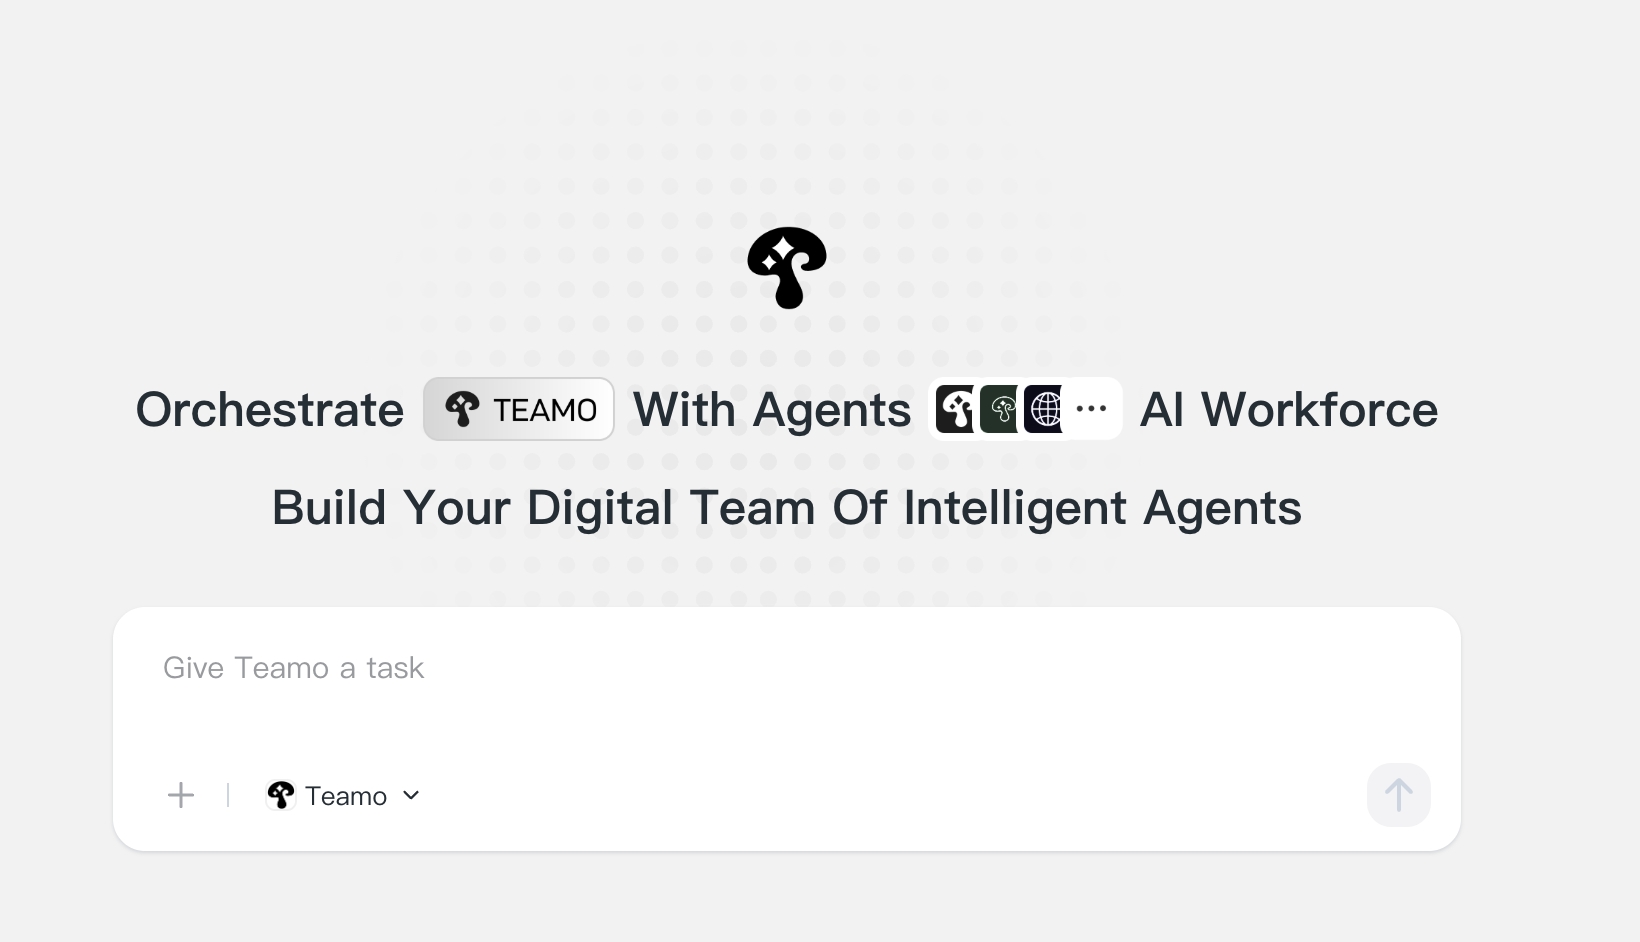
- Offizielle Seite öffnen, registrieren und anmelden, um zum Eingabefeld für Aufgaben zu gelangen.
- Die Aufgabe so beschreiben, wie man sie einer Kollegin erklären würde, und relevante Dateien oder Bilder für multimodale Verarbeitung anhängen. Je klarer das Briefing, desto besser die Zerlegung.
- Die passende Agentengruppe wählen: Suche für Material, Beratung für Urteile, Schreiben für den Entwurf, Design für die Darstellung.
- Während des Laufs das Prozessfenster beobachten, ob Quellen vertrauenswürdig wirken und ob die Kreuzprüfung tatsächlich stattfand, und dort eingreifen, wo nicht.
- Das Ergebnis nachschärfen oder den Gruppenleiter um eine weitere Bewertungsrunde bitten. Die Vorlage hat die Struktur bereits fixiert, also geht die restliche Kraft in die Faktenprüfung.
Preis und Zugang
- Die Quellseite nennt weder Abonnementpreis noch kostenloses Kontingent oder Guthabenabrechnung und sagt nicht, ob Routing zu verschiedenen Modellen die Kosten ändert.
- Der bestätigte Einstieg ist die offizielle Seite, die Registrierung und Anmeldung verlangt; ob es eine Testphase gibt, steht nicht in der Quelle.
- Dieser Artikel spekuliert nicht über Preise oder Tarifstufen.
Für wen es passt
- Wissensarbeiter, die lange Dokumente mit Belegkette erstellen, etwa Rechercheberichte, Marktanalysen oder Wettbewerbsvergleiche, weil solche Aufgaben von Natur aus mehrere Rollen haben.
- Autorinnen und Redakteure, die Themenwahl, Quellensammlung und Entwurf in einem Ablauf erledigen und dennoch sehen wollen, woher das Material stammt.
- Entscheidungsunterstützung und Forschung, die strukturierte Vorlagen und einen nachvollziehbaren Prozess brauchen statt einer nicht prüfbaren Schlussfolgerung.
Grenzen, die man kennen sollte
- Die Behauptung, der weltweit erste Superagent im A2A-Paradigma zu sein, ist Positionierung des Herstellers, und die Quelle liefert keinen überprüfbaren Vergleich.
- Dass Agenten sich gegenseitig bewerten, kann Probleme sichtbar machen, garantiert aber keine Korrektheit; zentrale Zahlen bleiben prüfungspflichtig am Original.
- Preis, Nebenläufigkeitsgrenzen, Datenspeicherung und Datenschutzregeln werden nicht offengelegt, Unternehmen müssen Konformität selbst klären.
- Je aufwendiger der Ablauf, desto höher Zeit und Kosten; eine einfache Frage ist in einem einzelnen Chat meist schneller.
Häufige Fragen
Worin unterscheidet sich A2A von üblichen Multiagentenaufbauten?
Der Schwerpunkt liegt auf Agent-zu-Agent-Zusammenarbeit, bei der Agenten Arbeit teilen, übergeben und sich wie Teammitglieder bewerten, statt dass ein Hauptmodell einige Werkzeuge aufruft. Praktisch sieht man, was jede Rolle getan hat und welche Bewertung übernommen wurde.
Reduziert ein sichtbarer Prozess wirklich Halluzinationen?
Er verwandelt eine Halluzination von einem falschen Satz im Ergebnis in einen sichtbaren Schritt im Lauf: welche Quellen geholt wurden, ob eine Kreuzprüfung stattfand, worauf der Entwurf beruht. Es gibt mehr Gelegenheiten, ein Problem zu bemerken, aber beurteilen muss es weiterhin ein Mensch.
Für welche Komplexität ist es gedacht?
Nach den Beispielen des Herstellers für Aufgaben mit Mehrquellensuche und strukturierter Ausgabe: ein Dashboard mit Diagrammen, eine Wettbewerbsanalyse in fünf Dimensionen, ein Businessplan. Für eine einzelne Faktenfrage ist es Verschwendung.
Gibt es eine kostenlose Nutzung?
Die Quelle nennt nur die offizielle Adresse und die Anmeldeschritte; kostenloses Kontingent oder Testregelung werden nicht beschrieben, Preise sind offiziell zu klären.
Häufig gestellte Fragen
Worin unterscheidet sich A2A von üblichen Multiagentenaufbauten?
Der Schwerpunkt liegt auf Agent-zu-Agent-Zusammenarbeit, bei der Agenten Arbeit teilen, übergeben und sich wie Teammitglieder bewerten, statt dass ein Hauptmodell einige Werkzeuge aufruft. Praktisch sieht man, was jede Rolle getan hat und welche Bewertung übernommen wurde.
Reduziert ein sichtbarer Prozess wirklich Halluzinationen?
Er verwandelt eine Halluzination von einem falschen Satz im Ergebnis in einen sichtbaren Schritt im Lauf: welche Quellen geholt wurden, ob eine Kreuzprüfung stattfand, worauf der Entwurf beruht. Es gibt mehr Gelegenheiten, ein Problem zu bemerken, aber beurteilen muss es weiterhin ein Mensch.
Für welche Komplexität ist es gedacht?
Nach den Beispielen des Herstellers für Aufgaben mit Mehrquellensuche und strukturierter Ausgabe: ein Dashboard mit Diagrammen, eine Wettbewerbsanalyse in fünf Dimensionen, ein Businessplan. Für eine einzelne Faktenfrage ist es Verschwendung.
Gibt es eine kostenlose Nutzung?
Die Quelle nennt nur die offizielle Adresse und die Anmeldeschritte; kostenloses Kontingent oder Testregelung werden nicht beschrieben, Preise sind offiziell zu klären.