
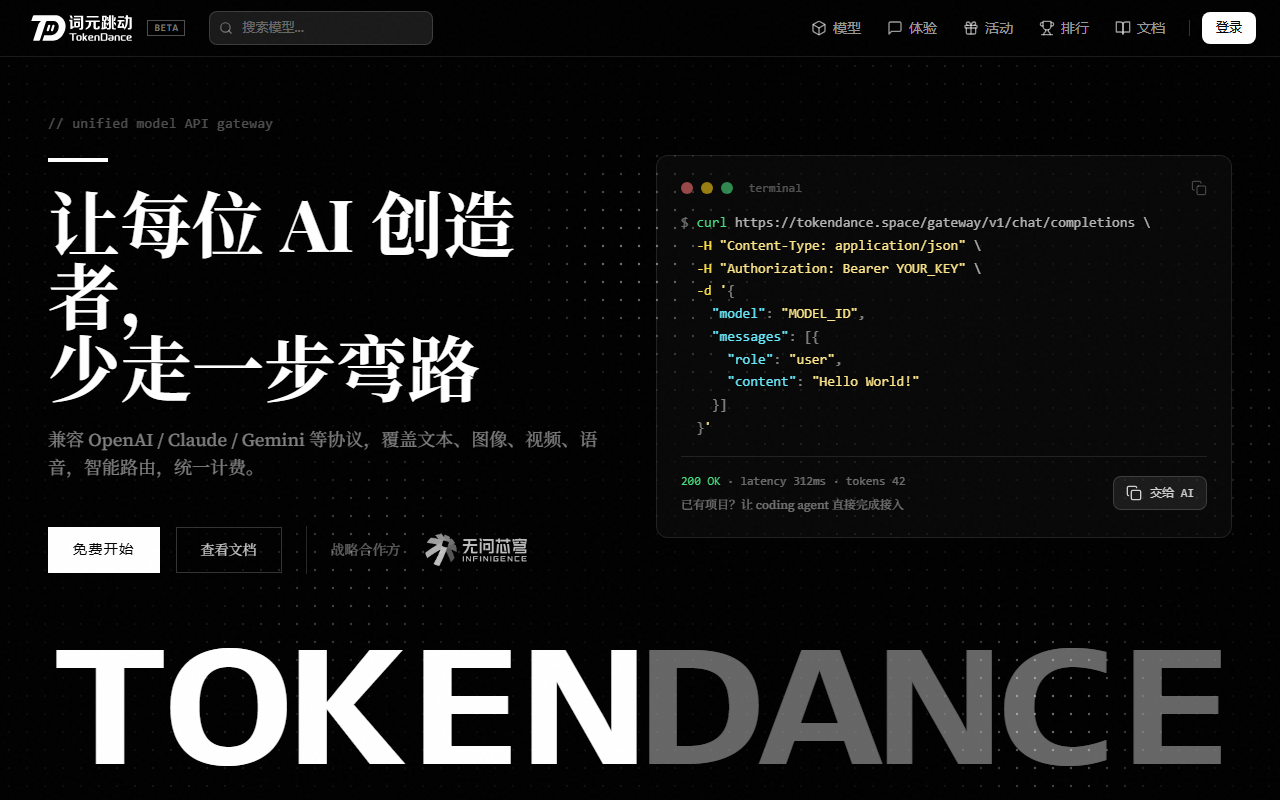
TokenDance ist ein Aggregations-Gateway für Sprachmodell-APIs. Es unterstützt die Protokolle OpenAI, Claude und Gemini nativ: Base URL durch die Gateway-Adresse ersetzen, API-Schlüssel und Modell-ID eintragen, und bestehende SDK-Aufrufe erreichen MiniMax, Qwen, Kimi, Zhipu, DeepSeek und weitere chinesische Modelle. Smartes Routing, anbieterübergreifende Abrechnung und automatischer Endpunkt-Failover sind enthalten, ohne Eingriff in den Geschäftscode.
TokenDance: eine Base URL für mehrere chinesische Sprachmodelle
Wer ein KI-Produkt baut, durchläuft dieselbe Phase: ein Anbieter für den Funktionsnachweis, dann ein zweiter und dritter wegen Qualität oder Kosten. Bald trägt der Code eine Anpassungsschicht, Schlüssel liegen in mehreren Konsolen, Rechnungen in getrennten Konten, und wenn ein Anbieter schwankt, schaltet jemand den Endpunkt von Hand um. Genau diese Reibung adressiert TokenDance: eine Base URL vor mehreren Anbietern, während die Anwendung nur einen Einstiegspunkt sieht.
Der Mechanismus ist nicht exotisch. Nach außen werden drei gängige Protokollformen angeboten — OpenAI, Claude, Gemini —, nach innen wird über den Modellnamen an den passenden Anbieter-Endpunkt geroutet. Entwickler ändern Konfiguration statt Code, und das macht das Versprechen der migrationsfreien Integration glaubwürdig. In einem Projekt, das bereits das OpenAI-SDK nutzt, genügt eine Zeile Base URL, um ein chinesisches Modell zu testen; die Kosten des Ausprobierens sinken deutlich.
Der übrige Wert liegt im Betrieb. Sind für dasselbe Modell mehrere Endpunkte hinterlegt, kann bei einem Ausfall automatisch umgeschaltet werden; eine Anfrage kann außerdem Kandidatenmodelle nennen und bei Ausfall des Hauptmodells stufenweise zurückfallen. Die einheitliche Abrechnung bündelt den Token-Verbrauch über Anbieter hinweg in einer Rechnung und erspart getrennte Aufladungen und Abstimmungen. Tarife, Ratenlimits, Service-Level und Datenaufbewahrung nennt die Quelle nicht; das ist vor der Integration zu klären.
Hauptfunktionen
Protokollkompatibilität
Native Unterstützung für OpenAI, Claude und Gemini bedeutet: Base URL tauschen genügt, der Geschäftscode bleibt unverändert. Bei Bestandsprojekten ist das der pragmatischste Punkt, denn ein neues Modell zu testen erfordert keinen Umbau der Aufrufschicht.
Smartes Routing
Anfragen gehen über den Modellnamen an den richtigen Endpunkt, die Steuerungsdetails bleiben hinter einem Einstieg verborgen. Aufrufende müssen sich keine Hostnamen und Parameter-Eigenheiten je Anbieter merken.
Einheitliche Abrechnung
Der Token-Verbrauch wird anbieterübergreifend gezählt und an einer Stelle abgerechnet, ohne fünf Konsolen aufzuladen. Bei der Kostenzuordnung erklärt sich eine Rechnung leichter als fünf.
Failover und Rückfall
Dasselbe Modell kann mehrere Anbieter-Endpunkte mit automatischer Umschaltung haben, und eine Anfrage kann Kandidatenmodelle benennen, um der Reihe nach zurückzufallen. Das ist der konkreteste Vorteil eines Gateways gegenüber der Direktanbindung.
Modellabdeckung
Mehr als acht chinesische Hauptmodelle sind angebunden, darunter MiniMax, Qwen, Kimi, Zhipu und DeepSeek, weitere folgen. Abgedeckt sind chinesische Hauptmodelle, kein globaler Katalog.
Schneller Start
Registrierung und Prüfung laufen über Watcha-Ein-Klick-Login, bestehende SDKs funktionieren weiter, der Einstieg dauert Minuten. Dieser Login bindet das Konto an ein bestimmtes System, was zu akzeptieren ist.
Förderprogramm
Ein Formular erlaubt es, Token-Förderung nach Produktphase zu beantragen. Für frühe Projekte nützlich, doch Höhe und Kriterien sind nicht veröffentlicht.
Erste Schritte
- Die TokenDance-Seite öffnen und sich per Watcha-Ein-Klick-Login registrieren und verifizieren.
- In der Konsole einen persönlichen API-Schlüssel erzeugen und wie jede andere Zugangsdaten sicher verwahren.
- Die Base URL im Projekt durch die Gateway-Adresse https://tokendance.space/gateway/v1/ ersetzen.
- Die Ziel-Modell-ID in die Anfrage eintragen, etwa DeepSeek oder Kimi.
- Die Anfrage mit dem vorhandenen OpenAI-SDK oder curl senden und prüfen, ob die Antwort passt.
- Bei großem Token-Bedarf das Förderformular ausfüllen und Unterstützung nach Produktphase beantragen.
Für wen geeignet
- Junge Teams, die mehrere chinesische Modelle günstig über ein Gateway vergleichen wollen.
- Produkte, die im Betrieb nach Aufgabentyp routen und Denken, Schreiben und Code an verschiedene Modelle geben.
- Agenten-Systeme, die eine hochverfügbare, rückfallfähige Modellschicht brauchen.
- Kostenempfindliche Bildung, Forschung und Einzelentwickler, die einheitliche Abrechnung nutzen.
Grenzen
- Tarife, Freikontingent, Ratenlimits und Service-Level sind nicht veröffentlicht; vor der Integration beim Anbieter klären.
- Konten erfordern den Watcha-Ein-Klick-Login, das System muss akzeptiert werden; die Anbindung an Unternehmens-Identitäten ist nicht beschrieben.
- Das Gateway sieht Anfrageinhalte, Aufbewahrung und Logging sind nicht genannt; bei sensiblen Daten ist Compliance zu prüfen.
- Der Katalog konzentriert sich auf chinesische Hauptmodelle; globale oder Nischen-Open-Modelle können fehlen.
- Ein zusätzlicher Sprung bedeutet Latenz und einen weiteren Fehlerpunkt. Failover hilft, eigene Überwachung bleibt nötig.
- Höhe, Kriterien und Dauer der Förderung sind unveröffentlicht und taugen nicht als Grundlage langfristiger Kostenplanung.
Häufige Fragen
Muss Code geändert werden?
Nicht der Geschäftscode. Base URL durch die Gateway-Adresse ersetzen, Schlüssel und Modell-ID eintragen, OpenAI-SDK wie gewohnt weiterverwenden.
Welche Modelle gibt es?
Die Quelle nennt über acht chinesische Hauptmodelle, darunter MiniMax, Qwen, Kimi, Zhipu und DeepSeek, mit laufender Erweiterung. Die verbindliche Liste steht in der Konsole.
Wie funktioniert der Failover?
Zweistufig: mehrere Endpunkte je Modell mit automatischer Umschaltung sowie Kandidatenmodelle pro Anfrage, die bei Ausfall in Reihenfolge zurückfallen.
Was ist der Unterschied zur Direktanbindung?
Direkt bedeutet Schlüssel, Aufladung, Limits und Umschaltung je Anbieter zu verwalten. Ein Gateway bündelt das in einem Einstieg und einer Rechnung — um den Preis eines zusätzlichen Sprungs und der Abhängigkeit vom Gateway selbst.
Gibt es ein kostenloses Kontingent?
Die Quelle erwähnt nur ein Förderprogramm nach Produktphase, kein reguläres Freikontingent. Beim Anbieter nachfragen.
Häufig gestellte Fragen
Muss Code geändert werden?
Nicht der Geschäftscode. Base URL durch die Gateway-Adresse ersetzen, Schlüssel und Modell-ID eintragen, OpenAI-SDK wie gewohnt weiterverwenden.
Welche Modelle gibt es?
Die Quelle nennt über acht chinesische Hauptmodelle, darunter MiniMax, Qwen, Kimi, Zhipu und DeepSeek, mit laufender Erweiterung. Die verbindliche Liste steht in der Konsole.
Wie funktioniert der Failover?
Zweistufig: mehrere Endpunkte je Modell mit automatischer Umschaltung sowie Kandidatenmodelle pro Anfrage, die bei Ausfall in Reihenfolge zurückfallen.
Was ist der Unterschied zur Direktanbindung?
Direkt bedeutet Schlüssel, Aufladung, Limits und Umschaltung je Anbieter zu verwalten. Ein Gateway bündelt das in einem Einstieg und einer Rechnung — um den Preis eines zusätzlichen Sprungs und der Abhängigkeit vom Gateway selbst.



