

TokenPony eignet sich für einzelne Entwickler, kleine Teams, Unternehmen und Forschende, die mehrere große Modelle parallel nutzen möchten, keinen eigenen GPU-Server betreiben wollen und die Anbindung über eine einheitliche Schnittstelle vereinfachen möchten.
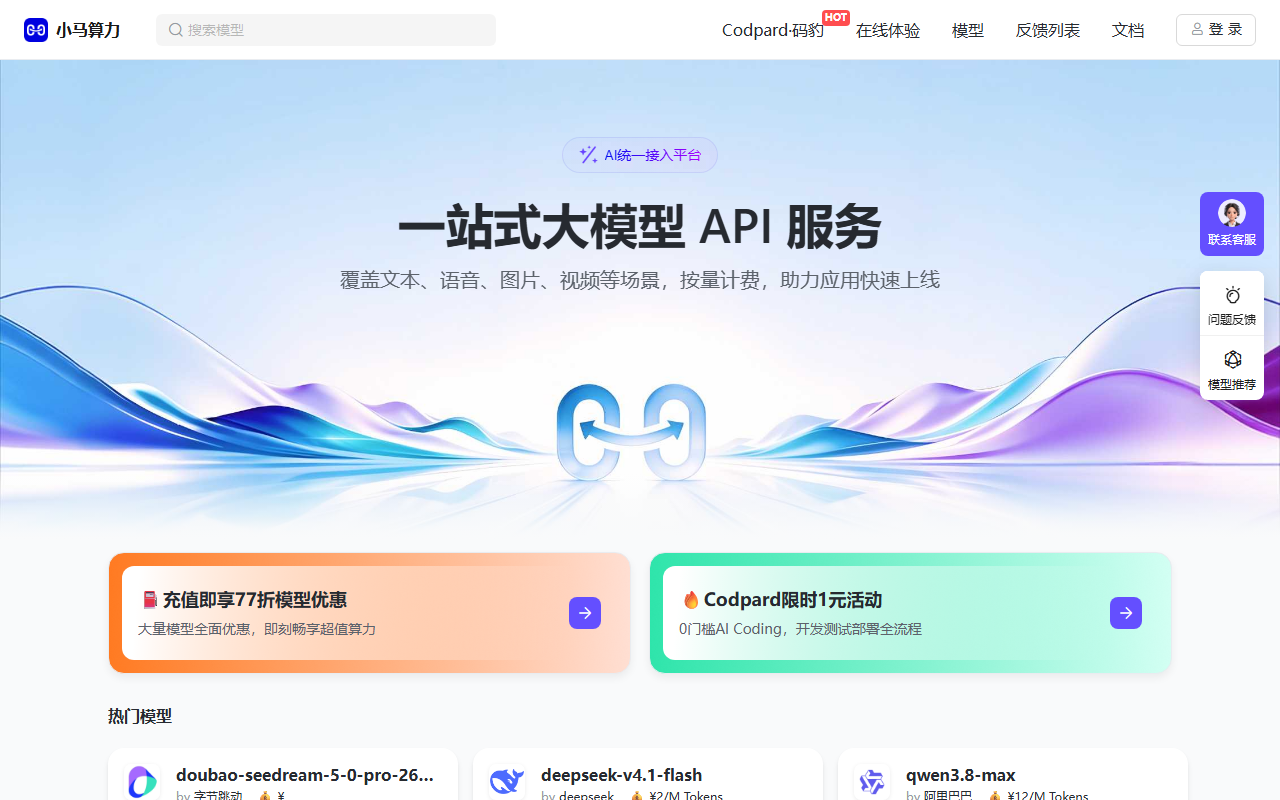
TokenPony: KI-Modell-Aufrufe über eine einheitliche API
TokenPony ist eine KI-Modell-API-Aggregationsplattform für einzelne Entwickler und kleine Teams. Ihre Positionierung lässt sich als dünne Orchestrierungsschicht beschreiben: DeepSeek, Kimi, Qwen, GLM und weitere gängige große Modelle werden unter einer einzigen Schnittstelle gebündelt, sodass Nutzer nicht mehr ständig zwischen mehreren Plattformen wechseln müssen. Was Entwickler tatsächlich Zeit kostet, ist nicht das einzelne Modellsms, sondern der Aufwand für Anbindung, Authentifizierung, Abrechnung und Wartung, wenn mehrere Modelle parallel genutzt werden. TokenPony bündelt all diese Punkte und bietet gleichzeitig einen Kontextumfang von 1024K für lange Dokumente, mehrstufige Unterhaltungen und komplexe Agenten-Aufgaben. Ein eigener GPU-Server ist nicht nötig.
Hauptfunktionen
Anbindung aller Modelle Gängige große Modelle wie DeepSeek, Kimi, Qwen und GLM sind integriert, sodass kein Wechsel zwischen Plattformen nötig ist. Innerhalb einer Plattform lassen sich verschiedene Modelle frei aufrufen. Bei Anwendungen, die mehrere Modelle gleichzeitig nutzen, entfällt das wiederholte Einrichten derselben Anbindung.
Unterstützung für sehr lange Kontexte Die Verarbeitungskapazität von 1024K Kontext eignet sich für lange Dokumente, mehrstufige Unterhaltungen und komplexe Agenten-Aufgaben. Die Kontextlänge bestimmt, wie viele Materialien in einem Durchgang verarbeitet werden können, und ist damit Voraussetzung für Aufgaben mit langen Texten.
API-Aufruf per Klick Ohne Konfiguration und ohne Deployment sofort einsatzbereit. Entwickler müssen weder ein Deployment noch die Einrichtung der Laufzeitumgebung übernehmen und können nach Erhalt des Schlüssels direkt mit Aufrufen beginnen.
Kein GPU-Server erforderlich Die Nutzung erfolgt über die API vortrainierter Modelle, sodass kein eigener GPU-Server aufgebaut werden muss und Hardwarekostenungen entfallen. Für einzelne Entwickler und kleine Teams ist das häufig der entscheidende Abwägungspunkt.
Kostenoptimierung Eine transparente Preisgestaltung erleichtert den Kompromiss zwischen Leistung und Kosten. Die Stückkosten unterscheiden sich je Modell deutlich, eine klare Preisübersicht hilft daher, die Gesamtausgaben zu steuern.
Nutzungsschritte
- Registrieren und anmelden: Die offizielle Seite öffnen und die Registrierung über den Login-Einstieg oben rechts auf der Seite abschließen.
- Modelle ansehen: Auf der Modellseite die unterstützten Modelle einsehen und über die Filterfunktion Details zu einem bestimmten Modell nachschlagen.
- Aufladen: Unter „Benutzerinformationen“ aufladen. Derzeit wird WeChat Pay unterstützt, der Mindestbetrag beträgt 10 Yuan und dient den nachfolgenden Modellaufrufen.
- API-Schlüssel erstellen: Auf der Modellseite das gewünschte Modell auswählen und dafür einen API-Schlüssel erstellen.
- Schnittstelle aufrufen: Mit dem erstellten API-Schlüssel das benötigte Modell über die Schnittstelle der Plattform aufrufen und mit der Entwicklung beginnen.
- Nutzung verwalten: Den Aufrufumfang je Projekt schätzen und zusammen mit der Preisgestaltung der Modelle das passende Modell wählen, um unnötige Kosten zu vermeiden.
Zielgruppen
- Einzelne Entwickler: Mehrere große Modelle schnell anbinden, den Entwicklungsprozess vereinfachen und Kosten senken
- Kleine Teams: Begrenzte Ressourcen effizient nutzen und Anwendungen auf Basis großer Modelle schnell aufbauen und bereitstellen
- Kreative Fachleute: Etwa Textersteller und Content-Ersteller, die mit KI Effizienz und Qualität ihrer Arbeit steigern möchten
- Unternehmen: KI-Funktionen in Geschäftsprozesse integrieren wollen, ohne große Investitionen in eigene Modelle und Infrastruktur zu tätigen
- Forschende: Flexibel verschiedene Modelle für Forschung und Experimente aufrufen und neue Anwendungsfelder von KI erkunden
- Studierende und Lehrende: Lernen und Lehren sowie die Anwendung von KI im Bildungsbereich erkunden
Einschränkungen und Hinweise
- Fähigkeiten und Parameter der Modelle richten sich nach den tatsächlich bereitgestellten Versionen; Modelle unterscheiden sich in Qualität, Geschwindigkeit und Kontextgrenzen.
- Die Aggregation verändert die Ausgabequalität der Modelle selbst nicht. Die Genauigkeit wichtiger Aufgaben muss weiterhin selbst bewertet und geprüft werden.
- Aufrufe werden nutzungsabhängig abgerechnet. Lange Kontexte und häufige Aufrufe erhöhen die Kosten deutlich, eine Schätzung nach tatsächlicher Nutzung ist daher nötig.
- API-Schlüssel sind Zugangsdaten. Bewahren Sie sie sicher auf und nehmen Sie sie nicht in öffentliche Code-Repositorien auf.
- Eine Netzwerkverbindung und die Verfügbarkeit der Plattform sind erforderlich; Änderungen oder Störungen des Dienstes wirken sich auf die Aufrufkette aus.
- Für Aufladung, Zahlungsarten, Preise und Bedingungen sind die tatsächlichen Seiten der Plattform maßgeblich. Prüfen Sie die aktuellen Regeln vor der Nutzung.
Häufig gestellte Fragen
Welches Problem löst TokenPony?
TokenPony bündelt gängige große Modelle wie DeepSeek, Kimi, Qwen und GLM unter einer einzigen Schnittstelle. Damit entfallen das ständige Wechseln zwischen Plattformen und das wiederholte Einrichten derselben Anbindung. Zusätzlich stehen 1024K Kontext für lange Dokumente, mehrstufige Unterhaltungen und komplexe Agenten-Aufgaben bereit. Ein eigener GPU-Server ist nicht nötig, wodurch Hardwarekostenungen entfallen.
Wie rufe ich Modelle über TokenPony auf?
Der Ablauf lautet: registrieren und anmelden, unterstützte Modelle auf der Modellseite einsehen, unter den Benutzerinformationen aufladen, für das gewünschte Modell einen API-Schlüssel erstellen und mit diesem Schlüssel über die Schnittstelle der Plattform aufrufen. Für das Aufladen wird derzeit WeChat Pay unterstützt, der Mindestbetrag beträgt 10 Yuan.
Worauf sollte ich bei einer solchen API-Plattform achten?
Modelle unterscheiden sich in Qualität, Geschwindigkeit und Kontextgrenzen, und die Aggregation verändert die Ausgabequalität der Modelle selbst nicht. Aufrufe werden nutzungsabhängig abgerechnet, lange Kontexte und häufige Aufrufe erhöhen die Kosten deutlich. API-Schlüssel sind Zugangsdaten und dürfen nicht in öffentlichen Repositorien landen. Zudem sind eine Netzwerkverbindung und die Verfügbarkeit der Plattform nötig; Preise und Regeln sollten Sie auf der aktuellen Seite prüfen.



