Mofa Xingyun es una plataforma de desarrollo de humanos digitales 3D con control en tiempo real, generación de vídeo, síntesis de voz e integración SDK o API.
Mofa Xingyun: plataforma de humanos digitales 3D
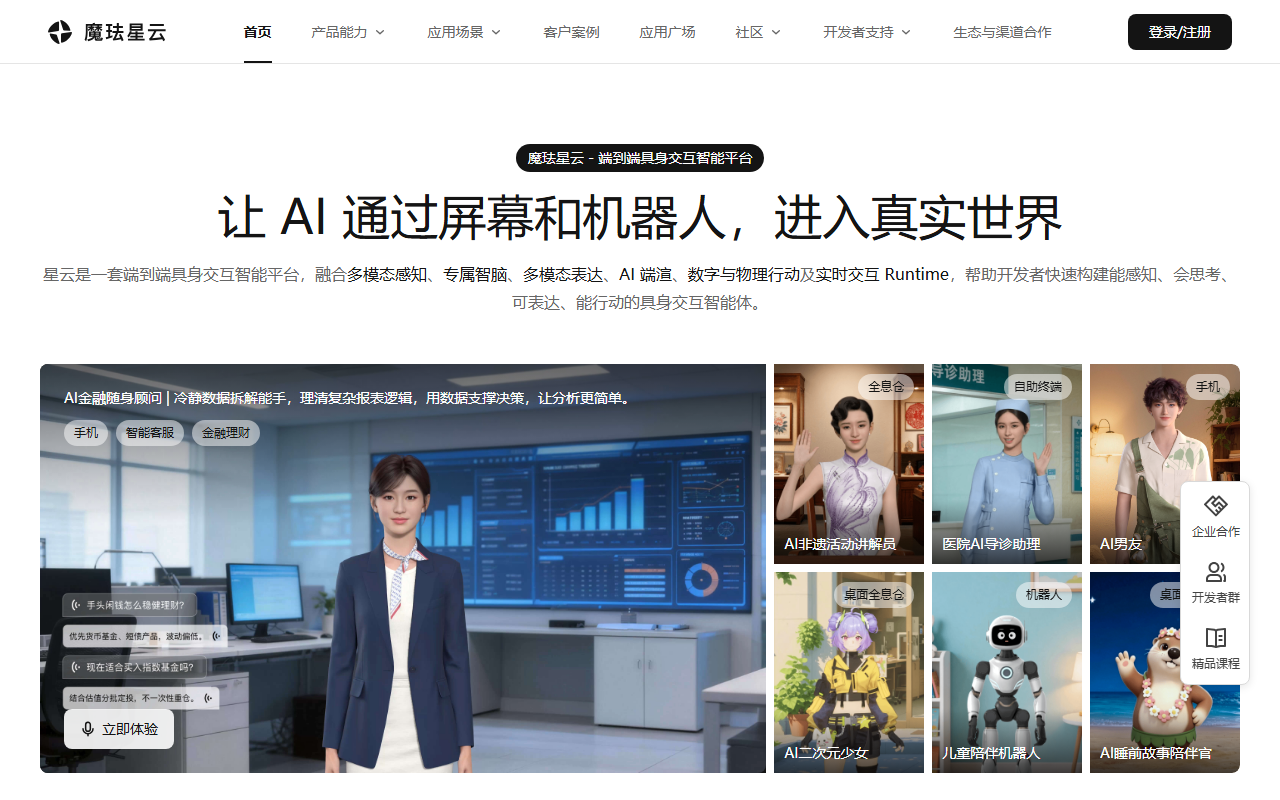
Mofa Xingyun es una plataforma abierta para desarrolladores que crean humanos digitales 3D. La información del producto describe voz, expresiones y movimientos en tiempo real controlados por texto, además de generación de vídeo, síntesis de voz e interacción multimodal. Los equipos pueden integrar estas capacidades mediante SDK o API según las necesidades del proyecto. Las funciones disponibles, los requisitos de despliegue y las capacidades del modelo deben confirmarse en la documentación oficial vigente.
Capacidades principales
- Control en tiempo real: genera voz, expresiones, mirada, gestos y movimientos corporales desde texto para experiencias interactivas.
- Vídeo con avatar: el material describe vídeos de presentadores 3D creados desde texto o PPT, con configuración automática de escena, iluminación y cámara.
- Síntesis de voz: se mencionan voces multilingües, distintos estilos y expresión emocional. También se cita la clonación de voz; obtén autorización explícita de la persona antes de utilizar una voz clonada.
- Interacción multimodal: combina el significado y la emoción del texto con voz y movimiento generados.
- Integración para desarrolladores: las opciones descritas incluyen un SDK de control corporal, una API de generación de vídeo y una API de voz.
Cómo empezar
- Visita el sitio oficial de Mofa Xingyun para revisar el producto, la documentación, la privacidad y los precios actuales.
- Regístrate y crea una aplicación; elige control en tiempo real, generación de vídeo o síntesis de voz según el caso.
- Integra el SDK o la API y prueba latencia, imagen, voz y dispositivos antes del lanzamiento.
- Antes de desplegar, confirma el tratamiento de datos, el aviso al usuario, los derechos de imagen y voz, la revisión de contenido y el presupuesto.
Facturación y usos
La plataforma se describe como basada en créditos. El consumo varía según la función; en vídeo puede depender de la resolución, la complejidad de la escena, la frecuencia de cuadros y la duración. Los ejemplos de crédito pueden cambiar, así que consulta el coste vigente antes de generar.
Entre los posibles usos figuran atención al cliente virtual, docentes digitales, empleados virtuales, terminales interactivos y formación comercial. El rendimiento real depende del contenido, la configuración, la conexión y el dispositivo. Confirma la compatibilidad, la concurrencia, la latencia y los permisos comerciales mediante la documentación y pruebas del proyecto. Para utilizar rostros o voces reales, obtén autorización y respeta la privacidad y las leyes aplicables.
Preguntas frecuentes
¿Qué puede generar?
La descripción incluye voz, expresiones y movimientos en tiempo real, vídeos desde texto o PPT y síntesis de voz multilingüe.
¿Hay API para desarrolladores?
Se mencionan un SDK de control corporal y API de vídeo y voz. Consulta la documentación oficial para conocer el acceso actual.
¿Cómo se calcula el coste?
Se usan créditos y el consumo depende de la función y de los parámetros del vídeo. Confirma las tarifas antes de ejecutar una tarea.
Preguntas frecuentes
¿Qué funciones ofrece?
La información describe voz, expresiones y movimientos en tiempo real, vídeos desde texto o PPT y síntesis de voz multilingüe.
¿Cómo se integra para desarrolladores?
Se mencionan un SDK de control corporal, una API de vídeo y otra de síntesis de voz. Consulta la documentación oficial para los requisitos actuales.
¿Cómo se factura?
La plataforma usa créditos y el consumo depende de la función y la configuración del vídeo. Confirma las tarifas actuales antes de generar.