
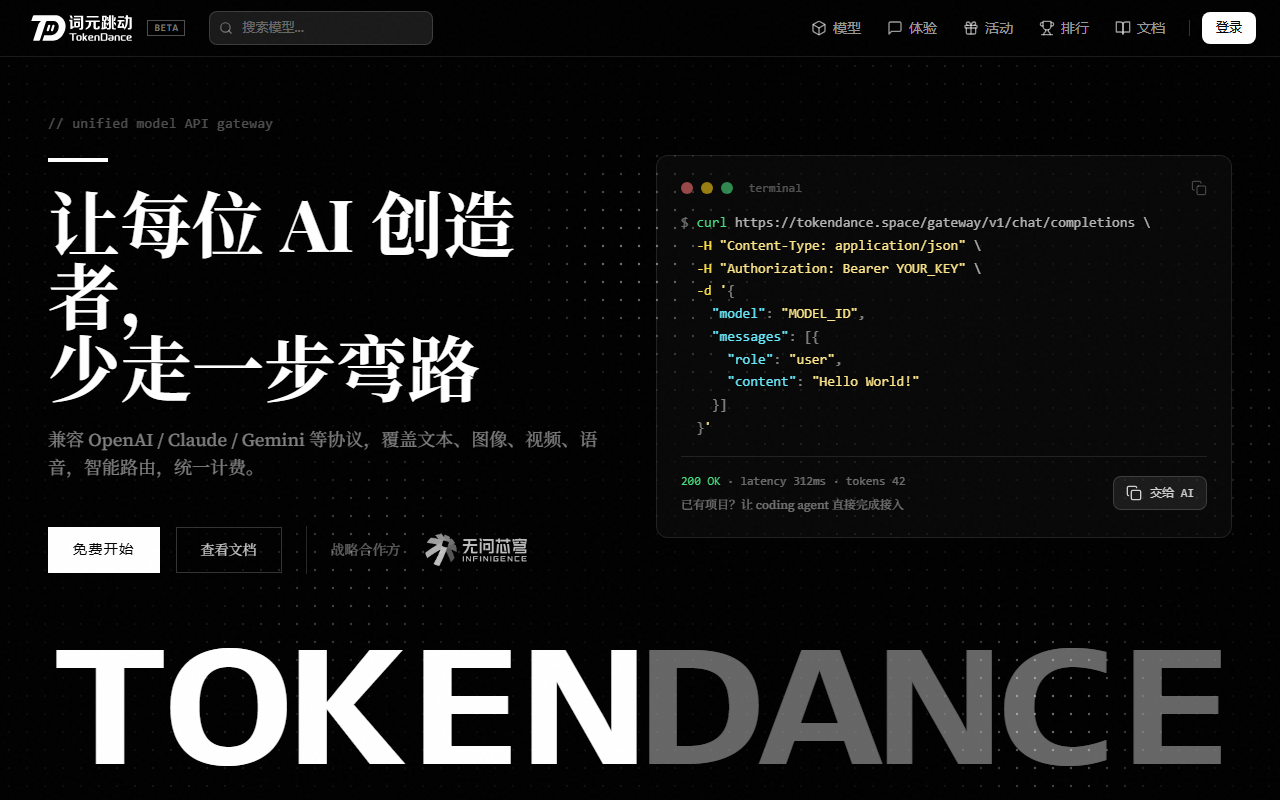
TokenDance es una pasarela de agregación de API para modelos de lenguaje. Es compatible de forma nativa con los protocolos OpenAI, Claude y Gemini: se sustituye la Base URL por la dirección de la pasarela, se añaden la clave de API y el identificador del modelo, y las llamadas del SDK existente llegan a MiniMax, Qwen, Kimi, Zhipu, DeepSeek y otros modelos chinos. Incluye enrutado inteligente, facturación unificada y conmutación por error entre puntos de acceso, sin modificar el código de negocio.
TokenDance: una sola Base URL para varios proveedores de modelos chinos
Quien construye un producto de IA atraviesa la misma fase: conecta un proveedor para validar el flujo y luego un segundo y un tercero por calidad o coste. Pronto el código carga una capa de adaptación, las claves se reparten entre paneles, las facturas viven en cuentas distintas y, cuando un proveedor falla, alguien cambia el endpoint a mano. TokenDance apunta a esa fricción: una Base URL delante de varios proveedores, con la aplicación viendo un único punto de entrada.
El mecanismo no es exótico. Expone tres formas de protocolo mayoritarias —OpenAI, Claude y Gemini— y enruta internamente por nombre de modelo al endpoint correspondiente. El desarrollador cambia configuración, no código, y eso es lo que hace creíble la promesa de migración nula. En un proyecto que ya usa el SDK de OpenAI, una línea de Base URL basta para probar un modelo chino, así que el coste de experimentar baja mucho.
El resto del valor está en la operación. Con varios endpoints configurados para un mismo modelo, una caída de un proveedor puede conmutar de forma automática; una petición también puede listar modelos candidatos y degradar paso a paso si el principal no responde. La facturación unificada reúne el consumo de tokens de todos los proveedores en una sola factura y elimina recargas y conciliaciones separadas. La fuente no detalla tarifas, límites de peticiones, compromisos de nivel de servicio ni retención de datos, así que conviene confirmarlo antes de integrar.
Funciones principales
Compatibilidad de protocolos
El soporte nativo de OpenAI, Claude y Gemini hace que cambiar la Base URL sea suficiente y el código de negocio no se toque. En proyectos heredados es la parte más práctica: probar un modelo nuevo no obliga a reconstruir la capa de llamadas.
Enrutado inteligente
Las peticiones se dirigen por nombre de modelo al endpoint adecuado y los detalles de programación quedan ocultos tras una sola entrada. Ya no hay que recordar dominios y rarezas de parámetros de cada proveedor.
Facturación unificada
El consumo de tokens se contabiliza entre proveedores y se factura en un solo lugar, sin recargar cinco paneles. Al atribuir costes, una factura se explica mejor que cinco.
Conmutación y degradación
Un mismo modelo puede tener varios endpoints con cambio automático, y una petición puede nombrar varios modelos candidatos para retroceder por orden. Es la ventaja más concreta de una pasarela frente a la integración directa.
Cobertura de modelos
Hay más de ocho modelos chinos de referencia conectados, entre ellos MiniMax, Qwen, Kimi, Zhipu y DeepSeek, y se siguen añadiendo. La cobertura es de modelos chinos mayoritarios, no un catálogo global.
Puesta en marcha rápida
El registro y la verificación se hacen con el inicio de sesión en un clic de Watcha, y los SDK existentes siguen funcionando, así que la integración lleva minutos. Ese acceso vincula la cuenta a un sistema concreto, condición que hay que aceptar.
Programa de subvención
Un formulario permite solicitar patrocinio de tokens según la fase del producto. Útil en proyectos tempranos, aunque el importe y los criterios de aprobación no se publican.
Primeros pasos
- Entrar en el sitio de TokenDance y registrarse con el inicio de sesión en un clic de Watcha para verificar la cuenta.
- Generar una clave de API personal en la consola y guardarla como cualquier credencial.
- Sustituir la Base URL del proyecto por la dirección de la pasarela https://tokendance.space/gateway/v1/.
- Indicar el identificador del modelo objetivo en la petición, por ejemplo DeepSeek o Kimi.
- Enviar la petición con el SDK de OpenAI existente o con curl y comprobar que la respuesta es la esperada.
- Si se necesita mucho volumen de tokens, enviar el formulario de subvención y solicitar patrocinio según la fase del producto.
Para quién es
- Equipos emergentes que comparan varios modelos chinos con bajo coste a través de una pasarela antes de decidir.
- Productos que enrutan por tipo de tarea en producción, enviando razonamiento, redacción y código a modelos distintos.
- Sistemas de agentes que necesitan una capa de modelos con alta disponibilidad y degradación.
- Educación, investigación y desarrolladores individuales sensibles al coste que aprovechan la facturación unificada.
Limitaciones
- No se detallan tarifas, cuota gratuita, límites de peticiones ni compromisos de servicio; hay que confirmarlo con el proveedor antes de integrar.
- Las cuentas exigen el inicio de sesión en un clic de Watcha, así que se acepta ese sistema; la integración con identidad corporativa no se describe.
- La pasarela ve el contenido de las peticiones y no se indica la política de retención o registros, así que evalúa el cumplimiento con datos sensibles.
- El catálogo se centra en modelos chinos mayoritarios; los modelos globales o abiertos de nicho pueden no estar cubiertos.
- Un salto extra añade latencia y un punto de fallo más. La conmutación ayuda, pero hace falta monitorización propia.
- Los importes, criterios y continuidad de la subvención no se publican; no conviene basar en ellos un modelo de costes a largo plazo.
Preguntas frecuentes
¿Hay que cambiar código?
No el de negocio. Se sustituye la Base URL por la de la pasarela, se añaden clave y modelo, y se sigue usando el SDK de OpenAI igual que antes.
¿Qué modelos hay?
La fuente cita más de ocho modelos chinos de referencia, entre ellos MiniMax, Qwen, Kimi, Zhipu y DeepSeek, con ampliaciones continuas. La lista definitiva está en la consola.
¿Cómo funciona la conmutación?
Dos niveles: varios endpoints por modelo con cambio automático, y modelos candidatos por petición que degradan en orden si el principal falla.
¿En qué se diferencia de llamar a cada proveedor?
La integración directa obliga a gestionar claves, recargas, límites y conmutación por proveedor. Una pasarela lo centraliza en una entrada y una factura, a cambio de un salto más y de depender de la propia pasarela.
¿Hay nivel gratuito?
La fuente solo menciona un programa de patrocinio que se solicita según la fase del producto, sin cuota gratuita habitual. Conviene preguntar al proveedor.
Preguntas frecuentes
¿Hay que cambiar código?
No el de negocio. Se sustituye la Base URL por la de la pasarela, se añaden clave y modelo, y se sigue usando el SDK de OpenAI igual que antes.
¿Qué modelos hay?
La fuente cita más de ocho modelos chinos de referencia, entre ellos MiniMax, Qwen, Kimi, Zhipu y DeepSeek, con ampliaciones continuas. La lista definitiva está en la consola.
¿Cómo funciona la conmutación?
Dos niveles: varios endpoints por modelo con cambio automático, y modelos candidatos por petición que degradan en orden si el principal falla.
¿En qué se diferencia de llamar a cada proveedor?
La integración directa obliga a gestionar claves, recargas, límites y conmutación por proveedor. Una pasarela lo centraliza en una entrada y una factura, a cambio de un salto más y de depender de la propia pasarela.



