Lingguang est une application d'assistant IA multimodal d'Ant Group couvrant langage, images, voix et données. Le mode conversation répond avec voix, modèles 3D, illustrations générées, graphiques et cartes interactives, et propose interprétation et traçabilité des sources. Le mode vision comprend les scènes en temps réel, accepte les questions sur une photo et permet de retoucher ou de générer des images et des vidéos ; une seule photo peut aussi devenir un monde 3D explorable sur le téléphone.
Lingguang : l'assistant multimodal d'Ant Group qui répond en 3D, graphiques et cartes
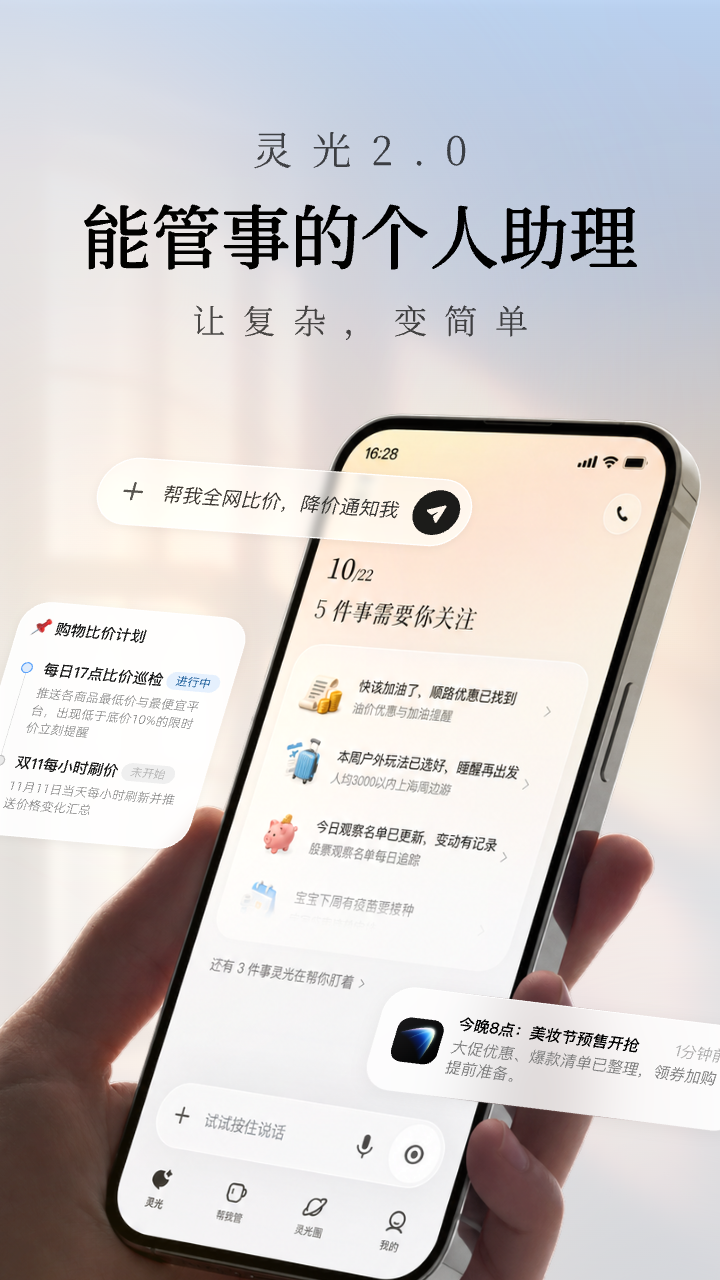
Lingguang est une application d'assistant IA multimodal d'Ant Group qui place la compréhension du langage, de l'image, de la voix et des données dans une seule entrée, et les réponses ne sont plus de simples paragraphes. Elles peuvent être un texte lu à voix haute, un modèle 3D que l'on fait tourner dans la main, une illustration qui dessine une idée abstraite, un graphique que l'on peut interroger ou une carte avec laquelle interagir. Deux fonctions portent le produit : Lingguang Chat, qui explique correctement les choses, et Lingguang Vision, qui transforme le téléphone en entrée vers la scène qui vous fait face.
Le problème visé est celui où une réponse textuelle ne suffit pas. Demander à quoi ressemble une pyramide se comprend mieux avec un modèle que l'on fait tourner qu'avec un paragraphe ; demander ce qu'est l'intrication quantique s'éclaire plus vite avec un schéma qu'avec trois explications ; demander quoi manger dans une rue se règle mieux avec une carte cliquable qu'avec une liste d'enseignes. Lingguang aligne la forme de la réponse sur la nature de la question et confie au visuel, à l'espace et au son ce que le texte porte mal.
Le second axe est la présence, grâce à Lingguang Vision : pointer la caméra vers une plante ou un tableau de musée et interroger, envoyer une photo puis continuer à demander ce que c'est, pourquoi cela fonctionne, comment l'utiliser, avant de faire retoucher l'image ou générer une vidéo dans la même conversation. L'assistant passe ainsi du question-réponse au fait de regarder et refaire ensemble. Une réserve : la page d'origine ne précise ni tarifs, ni pays disponibles, ni quotas de compte, et toute conclusion professionnelle ou donnée chiffrée doit encore être vérifiée ligne par ligne.
Fonctions principales
Lecture à voix haute
Transforme les réponses écrites en voix naturelle, utile pour la prononciation de mots anglais, les caractères rares ou les histoires du soir. En marchant, en cuisinant ou les yeux fatigués, écouter une longue réponse est plus réaliste que la lire à l'écran.
Modèles 3D
Génère des modèles interactifs comme une pyramide ou un tyrannosaure par numérisation tridimensionnelle. Tourner, zoomer et changer d'angle dépasse la lecture d'une description, et cela fonctionne particulièrement bien pour expliquer des structures spatiales aux enfants.
Illustrations générées
Convertit un savoir abstrait en images ou en animation. Pour l'intrication quantique ou les principes économiques, créez d'abord l'intuition par une image, puis revenez à la définition : le coût de compréhension baisse nettement.
Graphiques et données
Présente rapidement des données complexes issues de rapports financiers ou d'articles, avec des questions d'approfondissement. L'intérêt est de pouvoir insister sur un chiffre, même si toute citation formelle doit revenir à la source pour vérifier définitions et périodes.
Cartes interactives
Produit des cartes de parcours gourmands ou d'itinéraires pour organiser le trajet. Utile pour une préparation sommaire ; horaires réels et règles de réservation méritent une vérification sur les canaux officiels.
Interprétation et traçabilité
Les réponses peuvent être approfondies et rattachées à leurs sources. C'est la principale porte d'entrée de la crédibilité : une source ne rend pas une conclusion correcte, mais elle offre un chemin de retour que l'on peut parcourir soi-même.
Lingguang Vision
Comprend en temps réel des scènes complexes et des images animées, avec des questions à la voix, par exemple identifier une plante ou expliquer un tableau. Elle accepte aussi des questions libres sur une photo envoyée et permet retouche, édition, génération d'images et de vidéos dans la même conversation.
Mondes 3D à partir d'une photo
Après l'envoi d'une seule image, l'application construit sur le téléphone un monde 3D interactif que l'on parcourt à la première personne avec un joystick. À considérer comme une démonstration de génération spatiale plutôt qu'un outil de mesure.
Mode d'emploi
- Installez Lingguang sur iPhone, iPad ou Mac et connectez-vous.
- Saisissez une question ou un mot-clé dans Lingguang Chat et observez la forme de réponse choisie.
- Continuez à poser des questions, ou basculez l'affichage en voix, modèle 3D, illustration, graphique ou carte.
- Quand la crédibilité compte, ouvrez l'interprétation et comparez les sources au document d'origine.
- Ouvrez Lingguang Vision, filmez une scène ou envoyez une photo puis interrogez, avant de demander retouche, édition ou génération d'images et de vidéos.
- Pour tester la génération spatiale, envoyez une photo, créez le monde 3D et explorez-le à la première personne.
Tarif et disponibilité
- La page d'origine décrit uniquement les fonctions et les appareils compatibles ; elle ne précise ni tarifs, ni quota gratuit, ni abonnement, ni avantages membres.
- Savoir si les fonctions sont déployées par étapes et si la génération 3D ou vidéo a des limites d'usage se vérifie dans l'application, sur votre compte.
Quand l'utiliser
- Apprentissage et vulgarisation : remplacer les concepts abstraits par des illustrations, des modèles 3D ou des animations, et construire l'intuition avant les définitions.
- Travail et recherche : organiser les données de rapports et d'articles en graphiques, insister sur les chiffres, puis vérifier à la source.
- Préparation de voyage : répartir haltes gourmandes et itinéraires sur une carte interactive et confirmer les horaires avant le départ.
- Apprentissage des langues : écouter la prononciation de mots et de caractères rares, ou transformer de longs textes en audio pour le trajet.
- Exploration sur place : interroger des objets dans un musée ou un jardin botanique et laisser le téléphone expliquer ce qui est devant vous.
- Création de contenu : retoucher, éditer et générer images ou vidéos avec le mode vision pour obtenir rapidement une version utilisable.
Limites et précautions
- Les modèles 3D, les mondes 3D à partir d'une photo et la génération vidéo dépendent des performances de l'appareil ; la source ne décrit pas les écarts entre modèles.
- L'interprétation et la traçabilité offrent une voie de vérification, mais les conclusions demandent votre propre contrôle, surtout pour les contenus financiers, médicaux ou juridiques.
- Les illustrations et contenus 3D générés peuvent déformer des détails : relisez à la main les éléments clés avant un usage pédagogique, éditorial ou promotionnel.
- La source ne précise ni tarifs, ni pays disponibles, ni conditions d'usage commercial ; confirmez l'étendue de la licence avant toute publication externe.
- La reconnaissance par caméra dépend de la lumière, de l'angle et des occultations : traitez le résultat comme une piste et non comme l'unique base d'une décision.
Questions fréquentes
Qu'est-ce que Lingguang ?
Une application d'assistant IA multimodal d'Ant Group qui combine compréhension et génération du langage, de l'image, de la voix et des données. Elle répond en voix, modèles 3D, illustrations, graphiques, animations et cartes, avec Lingguang Chat et Lingguang Vision comme fonctions principales.
En quoi diffère-t-elle d'un assistant classique ?
Surtout par la forme de la réponse. Un assistant classique répond en texte ; Lingguang peut présenter la même réponse en voix, modèle 3D, illustration générée, graphique ou carte interactive, avec interprétation et vérification des sources. Cela convient quand il faut voir plutôt que lire.
Quels appareils sont pris en charge ?
La source mentionne iPhone, iPad, Mac et d'autres appareils. Les versions système requises et les différences de fonctions selon le modèle ne sont pas détaillées ; consultez la page de téléchargement.
Reconnaît-il les objets sur une photo ?
Oui. Lingguang Vision comprend en temps réel les scènes et les images animées et accepte des questions libres sur une photo envoyée : ce que c'est, pourquoi, comment l'utiliser. Le résultat dépend des conditions de prise de vue, alors recoupez ce qui compte.
Qu'est-ce que le monde 3D à partir d'une photo ?
Après l'envoi d'une image, l'application construit sur le téléphone un monde 3D interactif que l'on explore à la première personne avec un joystick. Mieux vaut le voir comme une démonstration de génération spatiale que comme une cartographie précise.
Questions fréquentes
Qu'est-ce que Lingguang ?
Une application d'assistant IA multimodal d'Ant Group qui combine compréhension et génération du langage, de l'image, de la voix et des données. Elle répond en voix, modèles 3D, illustrations, graphiques, animations et cartes, avec Lingguang Chat et Lingguang Vision comme fonctions principales.
En quoi diffère-t-elle d'un assistant classique ?
Surtout par la forme de la réponse. Un assistant classique répond en texte ; Lingguang peut présenter la même réponse en voix, modèle 3D, illustration générée, graphique ou carte interactive, avec interprétation et vérification des sources. Cela convient quand il faut voir plutôt que lire.
Quels appareils sont pris en charge ?
La source mentionne iPhone, iPad, Mac et d'autres appareils. Les versions système requises et les différences de fonctions selon le modèle ne sont pas détaillées ; consultez la page de téléchargement.
Reconnaît-il les objets sur une photo ?
Oui. Lingguang Vision comprend en temps réel les scènes et les images animées et accepte des questions libres sur une photo envoyée : ce que c'est, pourquoi, comment l'utiliser. Le résultat dépend des conditions de prise de vue, alors recoupez ce qui compte.