Mofa Xingyun est une plateforme de développement 3D proposant pilotage en temps réel, génération vidéo, synthèse vocale et intégration SDK ou API.
Mofa Xingyun : plateforme d’humains numériques 3D
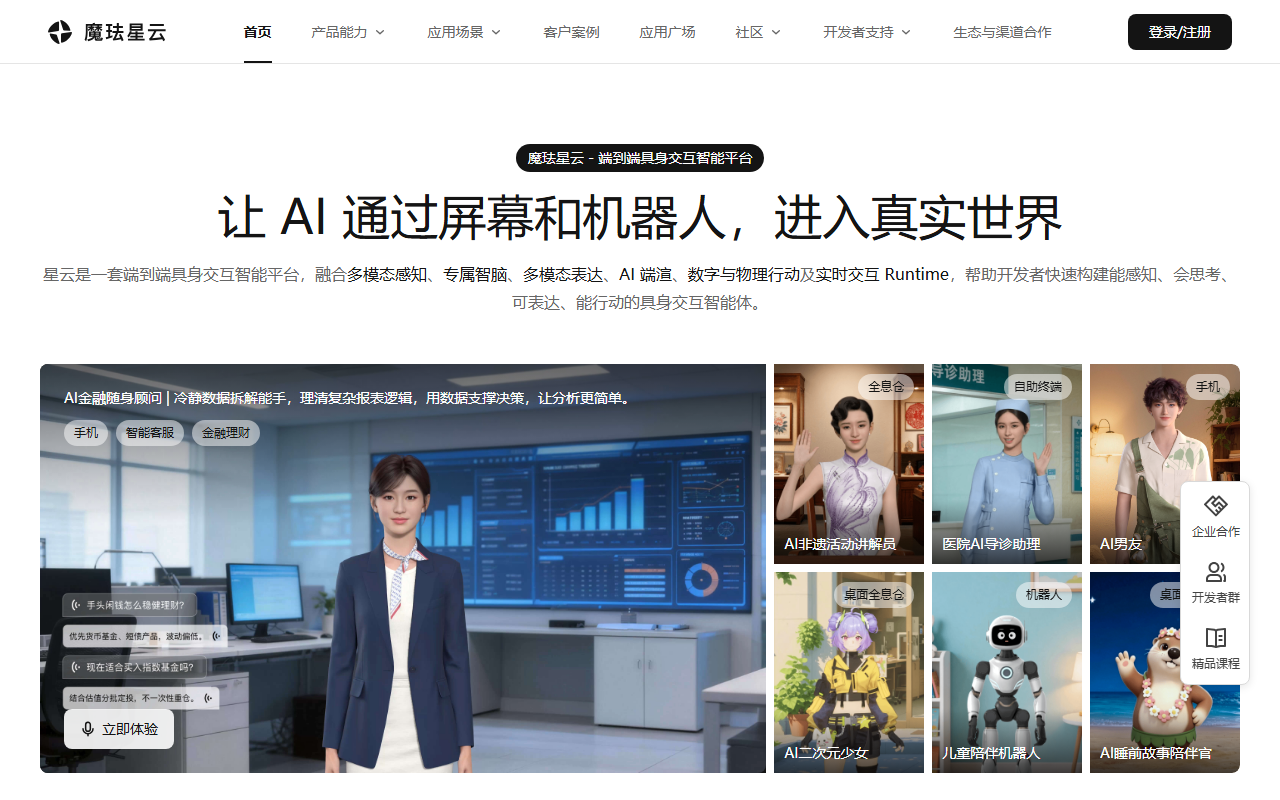
Mofa Xingyun est une plateforme ouverte destinée aux développeurs qui créent des humains numériques en 3D. La documentation décrit la génération en temps réel de voix, d’expressions et de mouvements à partir de texte, ainsi que la création vidéo, la synthèse vocale et l’interaction multimodale. Selon le projet, ces fonctions peuvent être intégrées par SDK ou API. Vérifiez dans la documentation officielle les fonctions disponibles, les conditions de déploiement et les capacités actuelles.
Fonctions principales
- Pilotage en temps réel : génère voix, expressions, regard, gestes et mouvements corporels à partir de texte pour des expériences interactives.
- Vidéo avec avatar : la documentation présente la création de vidéos de présentateurs 3D depuis un texte ou un PPT, avec préparation de la scène, éclairage et mouvement de caméra.
- Synthèse vocale : plusieurs langues, styles et expressions émotionnelles sont mentionnés. Le clonage vocal est aussi cité ; obtenez une autorisation explicite de la personne avant d’utiliser une voix clonée.
- Interaction multimodale : associe le sens et l’émotion du texte à la voix et aux mouvements générés.
- Intégration développeur : les options citées comprennent un SDK de pilotage, une API vidéo et une API vocale.
Premiers pas
- Consultez le site officiel de Mofa Xingyun pour les informations produit, la documentation, la confidentialité et les tarifs actuels.
- Inscrivez-vous, créez une application et choisissez pilotage en temps réel, vidéo ou synthèse vocale.
- Intégrez le SDK ou l’API selon les documents et testez latence, rendu, voix et appareils avant le lancement.
- Avant le déploiement, vérifiez traitement des données, information des utilisateurs, droits à l’image et à la voix, contrôle des contenus et budget.
Facturation et usages
La plateforme est décrite comme fonctionnant avec des crédits. La consommation dépend de la fonction ; pour la vidéo, elle peut varier selon la résolution, la complexité de la scène, la fréquence d’images et la durée. Les exemples évoluent : confirmez le coût actuel avant la génération.
Les usages possibles incluent service client virtuel, enseignement numérique, employés virtuels, bornes interactives et formation commerciale. Les résultats réels dépendent du contenu, de la configuration, du réseau et de l’appareil. Confirmez la compatibilité, la concurrence, les objectifs de latence et les droits commerciaux dans la documentation et par des essais. Pour les visages ou voix réels, obtenez les autorisations et respectez la confidentialité et la loi.
Questions fréquentes
Que peut générer la plateforme ?
La documentation cite voix, expressions et mouvements en temps réel, vidéos depuis texte ou PPT et synthèse vocale multilingue.
Existe-t-il des API développeur ?
Un SDK de pilotage et des API vidéo et vocales sont mentionnés. Consultez la documentation officielle pour l’accès actuel.
Comment les coûts sont-ils calculés ?
Le système utilise des crédits, avec une consommation variable selon la fonction et les paramètres vidéo. Vérifiez les tarifs avant usage.
Questions fréquentes
Quelles fonctions sont proposées ?
La documentation décrit voix, expressions et mouvements en temps réel, vidéos à partir de texte ou PPT et synthèse vocale multilingue.
Comment les développeurs peuvent-ils intégrer la plateforme ?
Elle mentionne un SDK de pilotage, une API vidéo et une API vocale. Consultez les documents officiels pour les exigences à jour.
Comment la facturation fonctionne-t-elle ?
La plateforme utilise des crédits et la consommation varie selon la fonction et les paramètres vidéo. Vérifiez les tarifs avant génération.