Seedance convient aux équipes et aux créateurs qui produisent en série de courtes vidéos pour la publicité, le cinéma, le commerce en ligne, le jeu ou l'éducation, qui exigent une sortie image et son synchronisées et qui doivent préserver la cohérence des personnages entre plusieurs plans.
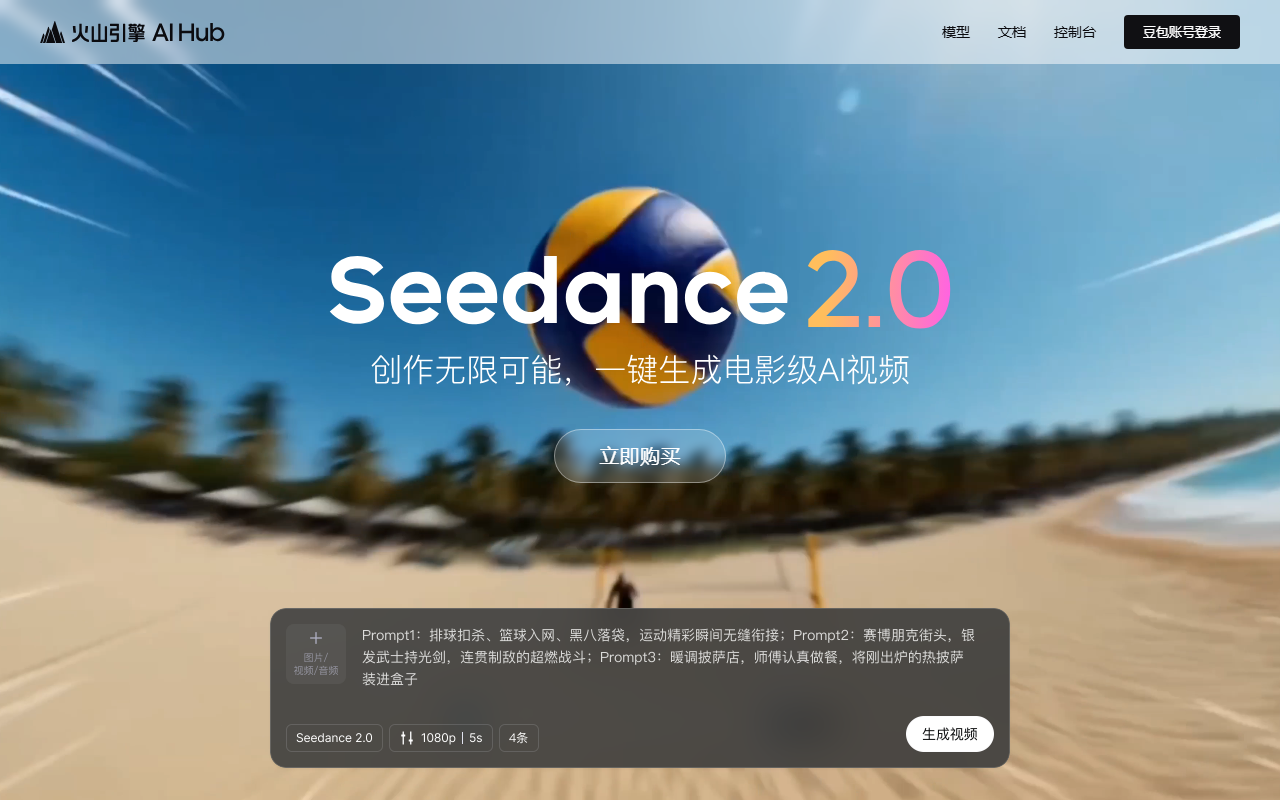
Seedance : un modèle multimodal de génération vidéo avec synchronisation image et son
Seedance est un modèle multimodal de génération vidéo fondé sur une architecture unifiée de production conjointe image-audio multimodal. Sa plus grande différence avec les outils habituels de génération vidéo tient au fait que le texte, l'image, l'audio et la vidéo sont pris en charge nativement, et que l'image et le son sont produits de façon synchrone lors d'une même génération. La démarche en deux étapes, consistant à produire d'abord une image muette puis à ajouter ensuite l'audio, disparaît ainsi. La musique, les effets sonores et les dialogues synchronisés avec les lèvres de plusieurs langues sont obtenus en une seule inférence, ce qui évite les décalages de lèvres et les effets sonores mal placés, fréquents dans ce processus en deux temps. Le modèle vise principalement les scénarios de production de contenu à haute fréquence dans la publicité, le cinéma, le commerce en ligne, le jeu et l'éducation.
Fonctionnalités principales
Entrée multimodale combinée
Il est possible de fournir simultanément du texte, neuf images, trois vidéos et trois fichiers audio, et la syntaxe « @mention » permet de désigner précisément la cible de contrôle de chaque élément. Les matériaux ne sont donc pas simplement juxtaposés, mais affectés un par un à leur usage.
Génération native et synchrone image-son
Fondé sur un transformeur de diffusion à deux branches, l'image et le son évoluent en parallèle au sein d'une même chaîne de génération. La musique, les effets sonores et les dialogues à lip synchronisation multilingue sont produits automatiquement. La synchronisation entre le dialogue et le mouvement des lèvres aboutit en une seule génération, sans étape de doublage séparée.
Extension intelligente et montage vidéo
Les plans sont étendus sans rupture par unités de cinq secondes, tout en préservant la cohérence des personnages, de l'éclairage et du contexte de la scène. La narration en plusieurs plans et le contrôle du mouvement de caméra sont pris en charge. Cette cohérence lors de l'extension détermine si le montage final reste visionnable d'un bout à l'autre.
Cohérence des personnages et de la physique
Le visage et la morphologie d'un personnage restent cohérents d'un plan à l'autre, et un entraînement par pénalité physique simule les lois de la pesanteur, des fluides et des collisions. Ce sont précisément ces deux points qui se dégradent le plus souvent dans une narration multi-plans.
Sortie en plusieurs résolutions
Les résolutions 480p, 720p et 1080p ainsi qu'une sortie directe en 2K et 4K sont prises en charge, la durée vidéo couvrant les plans standard de 4 à 15 secondes, avec un maximum de 60 secondes.
Conçu pour les scénarios industriels
Le modèle s'adresse principalement à la publicité, au cinéma, au commerce en ligne, au jeu et à l'éducation, des environnements où la production de contenu est fréquente, et propose aux entreprises comme aux créateurs une solution de génération vidéo.
Utilisation
- Accéder au service et se connecter : se rendre sur le point d'entrée et finaliser la connexion du compte.
- Choisir un forfait de ressources : acheter le forfait adapté. Les forfaits sont calculés en tokens, valables 90 jours pour les particuliers comme pour les entreprises, et décomptés proportionnellement au prix unitaire du token. Une fois épuisé, le forfait bascule automatiquement vers une facturation à l'usage.
- Téléverser les documents de référence : saisir l'invite textuelle dans l'espace de création, téléverser les images, vidéos ou audios de référence et signaler avec la syntaxe « @ » la cible de contrôle de chaque élément.
- Configurer les paramètres de génération : choisir la résolution (480p à 1080p) et la durée (4 à 15 secondes), lancer la génération et attendre la sortie du modèle.
- Montage et export : effectuer l'extension, les transitions et les ajustements fins de l'image et du son avec les outils de montage intégrés, puis exporter le résultat final. Pour une production en série, le processus peut être raccordé au système de production via une API.
Informations clés et conditions d'utilisation
- Version du modèle : Seedance 2.0
- Règles des forfaits : validité de 90 jours pour les particuliers comme pour les entreprises, décompte proportionnel au prix unitaire du token, basculement automatique vers la facturation à l'usage une fois épuisé
- Modes d'intégration : utilisation visuelle depuis la console, appels API et collaboration sur l'ensemble du processus
- Seuil d'entrée : les particuliers comme les entreprises peuvent acheter directement un forfait, sans avoir à fournir leur propre grappe de calcul
- Spécifications de sortie : résolution au choix entre 480p / 720p / 1080p, durée vidéo de 4 à 15 secondes, sortie directe jusqu'en 2K/4K
Palettes de forfaits
La différenciation s'effectue selon le volume de tokens, avec une validité de 90 jours commune aux particuliers et aux entreprises. Toutes les palettes proposent une sortie en 480p / 720p / 1080p et un réglage de durée de 4 à 15 secondes, avec un décompte proportionnel au prix unitaire du token. Selon la résolution et le mode d'entrée, le ratio maximal de décompte atteint environ 1:1,8.
- Forfait léger : 196 yuans, 7 millions de tokens, environ 28 vidéos en 480p
- Forfait complet : 280 yuans, 10 millions de tokens, environ 40 vidéos en 480p
- Forfait haute cadence : 364 yuans, 13 millions de tokens, environ 52 vidéos en 480p
Ces éléments reprennent les prix et volumes enregistrés dans les documents. Les palettes et prix effectifs font foi sur la page d'achat réelle.
Avantages clés
- Image et son produits en une seule passe : l'image et le son sortent de manière synchrone lors d'une même inférence, supprimant les décalages de lèvres et les effets sonores mal placés
- Précision de contrôle de niveau industriel : jusqu'à quinze références sont analysées simultanément, ce qui permet de diriger personnages, mouvement de caméra, action et style au même titre qu'un réalisateur
- Taux d'exploitation élevé : la part de résultats directement exploitables détermine directement le volume de retouches manuelles en aval
- Boucle de retour par les données : fondée sur une pratique à grande échelle des contenus vidéo courts et sur les retours des données, la compréhension des contenus visuels à forte propagation ne cesse de s'accumuler
- Structure de coûts souple : puissance de calcul cloud facturée à l'usage et forfaits gradués, permettant aux PME d'accéder au service sans investissement lourd
Différences avec les outils comparables
Les outils comparables de génération vidéo ne sont pas globalement plus faibles en précision de contrôle des références, ils utilisent chacun leurs propres mécanismes, comme le contrôle multimodal, le pinceau de mouvement ou le contrôle de scène. La véritable ligne de partage se situe sur deux points.
Premièrement, le son est-il généré nativement. Certains outils produisent une vidéo muette, ce qui impose un doublage ultérieur et un alignement du son sur l'image assuré à la main. Seedance intègre l'audio à la même chaîne de génération.
Deuxièmement, la durée de sortie et la simulation physique. Chez les outils comparables, les plans standard se situent généralement entre 10 et 30 secondes et nécessitent plusieurs assemblages et extensions. Seedance étend par unités de cinq secondes en conservant la cohérence du contexte, jusqu'à 60 secondes au maximum. Sur la simulation des lois physiques, certains outils se limitent à des effets simples de mouvement et de déformation, tandis que Seedance ajoute un entraînement par pénalité physique pour traiter la pesanteur, les fluides et les collisions.
Pour la compréhension du sens en chinois et de l'articulation labiale, les modèles optimisés pour les scénarios de vidéos courtes en chinois obtiennent généralement de bons résultats. Le seuil de coût dépend de la combinaison entre quota gratuit, abonnement et forfait.
Scénarios d'application
- Production en série de vidéos courtes et de contenus sociaux : les équipes marketing peuvent, à partir d'une bibliothèque de matériaux de marque, générer plusieurs versions de films publicitaires de 15 secondes via des descriptions textuelles et des vidéos de référence
- Marketing visuel en commerce en ligne : grâce à la génération vidéo à partir d'images et à la cohérence des personnages entre plusieurs plans, des visuels produits statiques deviennent de courts extraits montrant le produit en mouvement, en conservant l'uniformité des traits du visage et du style de scène
- Localization multilingue : la lip synchronisation multilingue permet de remplacer le mouvement des lèvres et le doublage d'un même matériau vidéo pour l'adapter à différents marchés régionaux
- Prévisualisation cinématographique et storyboards : des brouillons de storyboard sont générés à partir d'instructions textuelles et de vidéos de référence pour le mouvement de caméra, ce qui permet de valider le langage visuel avant le tournage
Limites et précautions
- Les contenus générés par IA ne garantissent pas l'exactitude des faits et des détails ; les images comportant des logos de marque, l'apparence des produits ou des données chiffrées doivent être vérifiées manuellement.
- La génération synchrone image-son réduit le travail de doublage, mais le contenu vocal produit doit encore être vérifié pour s'assurer qu'il correspond à la formulation réellement utilisée par l'entreprise.
- Le plafond de matériaux (neuf images, trois vidéos, trois audios) limite la complexité treatable en une seule saisie ; au-delà, il faut traiter le matériau en plusieurs lots.
- L'équivalence « environ 28 vidéos en 480p » repose sur une résolution et un mode d'entrée déterminés ; les résolutions élevées et les entrées complexes consomment davantage de tokens.
- Les prix, les volumes et les règles des forfaits peuvent être modifiés ; la page d'achat réelle fait foi.
- L'usage commercial est soumis aux conditions d'utilisation de la plateforme ; lors de l'enregistrement de matériaux tiers, il faut s'assurer d'en détenir les autorisations.
Questions fréquentes
En quoi Seedance se distingue-t-il des outils habituels de génération vidéo ?
La différence essentielle tient à la génération native du son. Seedance prend en charge nativement le texte, l'image, l'audio et la vidéo, et produit image et son de façon synchrone lors d'une même génération, d'où une musique, des effets sonores et des dialogues à lip synchronisation multilingue obtenus automatiquement. Les outils qui produisent une vidéo muette imposent au contraire un doublage ultérieur, avec un alignement du son sur l'image assuré à la main.
Quels types d'entrées et quelles spécifications de sortie Seedance prend-il en charge ?
En entrée, il est possible de fournir simultanément du texte, neuf images, trois vidéos et trois fichiers audio, la syntaxe « @mention » permettant d'indiquer la cible de contrôle de chaque élément. En sortie, la résolution se choisit entre 480p, 720p et 1080p, avec en plus une sortie directe en 2K et 4K. La durée vidéo couvre les plans standard de 4 à 15 secondes, extensibles sans rupture par unités de cinq secondes, jusqu'à 60 secondes au maximum.
À quoi faut-il faire attention lors de la génération de vidéos avec Seedance ?
Les contenus produits par IA ne garantissent pas l'exactitude des faits et des détails : les images comportant des logos de marque, l'apparence des produits ou des données chiffrées doivent être vérifiées à la main. Le contenu vocal produit doit être contrôlé pour correspondre à la formulation réellement utilisée. Les documents de référence sont limités à neuf images, trois vidéos et trois audios, les scènes complexes se traitant donc par lots. L'équivalence « environ 28 vidéos en 480p » vaut pour une résolution et un mode d'entrée précis, les résolutions élevées consommant davantage de tokens. Les prix, les volumes et les règles des forfaits font foi sur la page d'achat réelle.