

Shuyan AI est un fournisseur d'API pour les équipes dont le modèle ne voit pas le web. Trois interfaces centrales : le parsing web qui reçoit une URL et renvoie du Markdown ou du JSON structuré, une recherche en direct couvrant presse, encyclopédies et sources académiques, et un OCR qui convertit PDF et scans en texte hiérarchisé. Une place de marché ajoute des appels agrégés à des LLM tiers et une intégration MCP. Les nouveaux comptes disposent de 500 appels gratuits, l'API est REST et un déploiement privé existe. Les chiffres de latence et de prix proviennent de l'éditeur.
Shuyan AI : parsing web, recherche en direct et OCR documentaire en API
Quiconque construit des agents finit par heurter le même mur : le modèle est assez intelligent, mais il ne voit pas la page qu'on lui demande de lire. Soit sa connaissance s'arrête à la date d'entraînement, soit le HTML arrive enseveli sous les menus et les publicités, soit le document décisif n'existe qu'en PDF scanné. C'est précisément cet interstice que vise Shuyan AI. L'entreprise n'entraîne pas de modèles, elle vend la conduite qui remet le monde extérieur dans une forme assimilable par un modèle. Trois questions décident de l'intérêt d'une intégration : la sortie est-elle réellement propre et structurée, un résultat de recherche peut-il être rattaché à une source vérifiable, et la latence tient-elle à la concurrence requise.
L'entreprise se présente comme une infrastructure de données pour l'ère des grands modèles et décrit son approche comme bimodale, combinant vision et code. Une voie interprète la page telle qu'elle est rendue ; l'autre extrait la structure par une logique de code, et les deux se contrôlent mutuellement. Cela répond à deux faiblesses classiques du scraping : les pages rendues côté client qu'une simple requête HTTP ne voit jamais, et les sélecteurs fragiles qui cèdent au moindre changement de mise en page. L'éditeur affirme que son index couvre plus de 300 domaines et des centaines de millions d'enregistrements structurés, bruit publicitaire filtré.
L'offre se répartit en trois couches. En bas, les trois interfaces de données : parsing, recherche et OCR. Au-dessus, une place de marché qui regroupe les appels à plusieurs fournisseurs, des agents conversationnels, un mode de recherche approfondie et une intégration aux flux MCP. En périphérie figurent des services de jeux de données et une plateforme d'analyse BI. La plupart des équipes n'appelleront que deux ou trois points de la couche basse ; le reste relève de capacités adjacentes du même fournisseur et mérite une évaluation séparée.
Comment fonctionnent les capacités centrales
Parsing web : reconstruire la page rendue en texte lisible
On envoie une URL, on reçoit du Markdown ou du JSON structuré. L'intérêt n'est pas de pouvoir récupérer la page, mais de ne plus avoir à écrire de règles de nettoyage ensuite : corps du texte, hiérarchie des titres et tableaux sont conservés autant que possible, publicités et navigation écartées. Dans un pipeline de recherche documentaire, cette étape fixe le plafond de qualité des fragments, et cette qualité fixe le plafond du rappel. Une entrée sale produit des fragments proches dans l'espace vectoriel et inutiles en pratique. La prise en charge annoncée des pages à rendu dynamique et des mises en page complexes est exactement ce qu'apporte une voie visuelle face à un simple analyseur DOM.
Recherche en direct : une couche de récupération citable
Le point d'entrée de recherche est conçu pour la consommation par un modèle et renvoie des extraits notés et structurés, non une simple liste de liens. Les sources annoncées couvrent presse, encyclopédies, littérature académique et plateformes médias, actualisées en continu à partir d'un crawl large et d'une archive de sites propriétaire. Pour les applications de recherche, la différence visible tient à l'ampleur des références : l'éditeur affirme que son mode approfondi consulte sept fois plus de pages qu'une recherche ordinaire, donc un contexte plus long et plus de marge pour recouper les affirmations.
OCR documentaire : préserver la hiérarchie, pas seulement les caractères
On téléverse un PDF ou un scan et le moteur extrait texte, tableaux et formules en Markdown et JSON qui conservent la structure du document. La difficulté n'a jamais été de reconnaître des glyphes isolés, mais de reconstruire l'organisation : quelle ligne est un titre, quel tableau court sur trois pages, quel symbole d'une formule est un indice. La hiérarchie compte en aval, car une base de connaissances découpe selon les titres. Perdue, il ne reste que la découpe à nombre fixe de caractères, qui coupe phrases et tableaux en deux.
Place de marché et MCP : appels de modèles et données sur une même couche
La place de marché agrège plusieurs fournisseurs de LLM derrière un point d'entrée unique, avec facturation et formats unifiés, ce qui évite de maintenir plusieurs déploiements. L'intégration MCP injecte recherche et parsing dans les flux d'IA via une interface standard, épargnant à ceux qui utilisent déjà ce protocole une réécriture de la logique d'appel d'outils. Le bénéfice conjoint est de configurer au même endroit : le côté données et le côté modèles cessent d'être des intégrations distinctes avec des défaillances distinctes.
Mise en route
- S'inscrire sur le site officiel et créer une clé d'API. Les nouveaux comptes incluent 500 appels gratuits, de quoi éprouver les trois interfaces avant d'engager un budget.
- Valider le parsing sur les pages qui comptent vraiment. Choisir dix à vingt URL réelles, dont des pages à rendu dynamique, des tableaux complexes et des articles longs paginés, puis vérifier si le Markdown renvoyé conserve la structure nécessaire. Ne pas juger sur la page d'exemple de l'éditeur.
- Pour l'OCR, constituer d'abord des échantillons limites : mises en page à deux colonnes, tableaux à cheval sur des sauts de page, scans contenant des formules. Les erreurs de structure se concentrent précisément là, et les repérer avant la mise en production coûte bien moins cher.
- Si vous utilisez déjà Dify ou Coze, montez la capacité dans un flux d'agent plutôt que d'écrire un backend. Pour une intégration directe, appelez les points REST et choisissez Markdown quand un humain relira la sortie, JSON quand un programme l'analysera.
- Pour les charges publiques ou financières, l'éditeur propose un déploiement privé à forte concurrence, mais forme de livraison, délai et coût ne sont pas publiés : cela passe par un échange commercial.
Prix et quotas
- Le seul chiffre publié est celui des 500 appels gratuits par nouveau compte. Suffisant pour une preuve de concept, très loin du volume de production.
- La facturation se fait au token, et l'éditeur situe le prix autour du tiers de services comparables, en ne facturant que les appels réussis. Ne facturer que le succès pèse davantage ici que sur une API de texte, car les échecs de parsing sont par nature plus fréquents.
- Prix unitaire par interface, paliers de volume, devis de déploiement privé et règles de règlement au-delà du quota gratuit ne sont pas publiés. À confirmer dans la console ou auprès du commercial avant de projeter un coût.
Pour qui c'est adapté
- Développeurs construisant des agents sur Dify ou Coze, qui ont besoin de lecture de pages et de recherche en direct sans maintenir crawlers ni pools de proxys.
- Équipes de recherche documentaire et de bases de connaissances dont le matériel interne vit dans des PDF et des scans et doit d'abord devenir un texte découpable et hiérarchisé.
- Produits d'agrégation de contenu et de comparaison de prix qui collectent et nettoient en continu données produits et actualités et sont sensibles au bruit publicitaire.
- Équipes techniques de la finance ou du secteur public qui exigent un déploiement privé et la résidence des données sans renoncer à la recherche en direct.
Limites et réserves
- Tous les chiffres de performance viennent de l'éditeur. Latence moyenne sous la seconde, quarante pour cent plus rapide que le marché, taux d'erreur sous 0,01 pour cent et prix au tiers n'ont aucune référence indépendante, et le corpus de test comme le type de pages ne sont pas précisés. Mesurez sur vos propres sites cibles.
- La transparence tarifaire est limitée. Au-delà des 500 appels, les documents publics ne indiquent ni prix unitaire, ni plafond de concurrence, ni politique de limitation de débit, ni si les nouvelles tentatives échouées sont facturées.
- Les détails de conformité manquent. Parsing et recherche touchent à des contenus tiers : limites du droit d'auteur, traitement des règles robots et durée de conservation des contenus récupérés doivent être confirmés par écrit, surtout en cas de rediffusion.
- La qualité multilingue n'est pas précisée. L'éditeur insiste sur la précision sur des pages chinoises complexes, un avantage pour les sites chinois qui ne dit rien des autres langues.
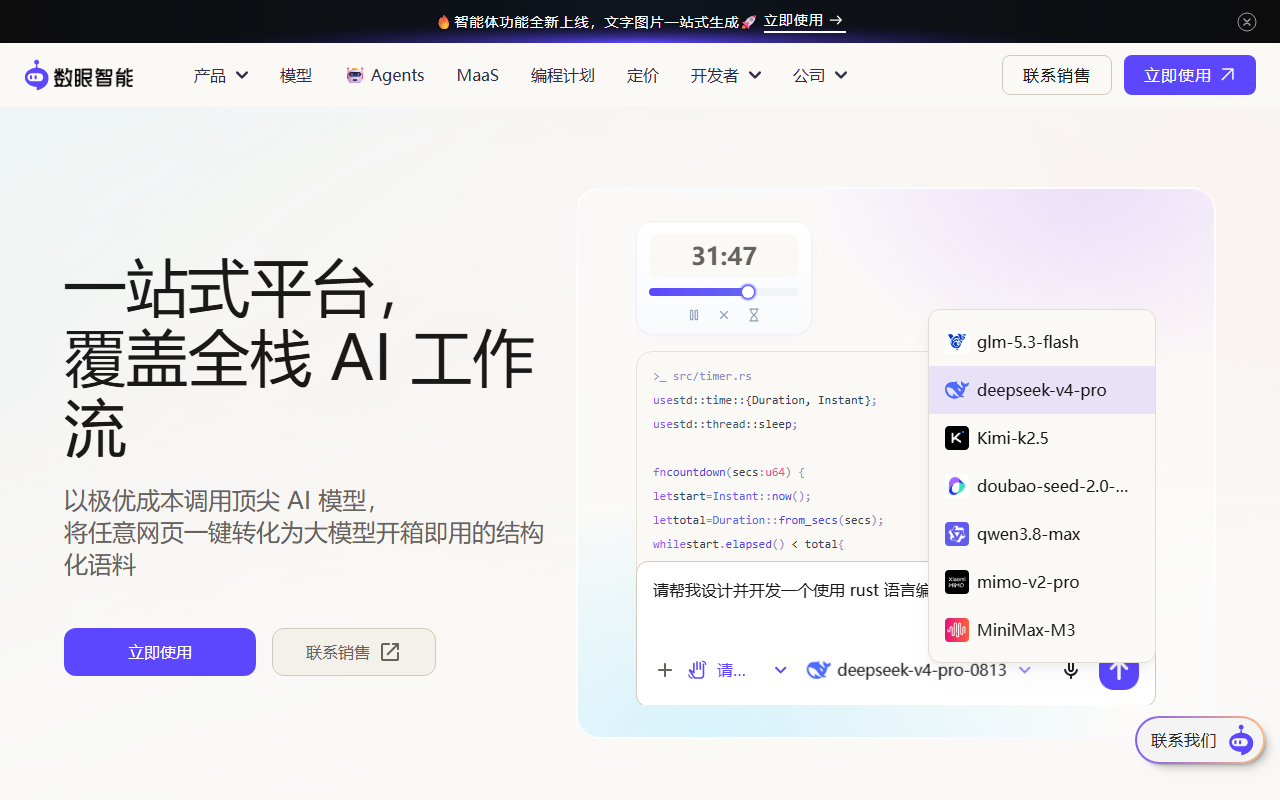
- Le seul média confirmable est une capture officielle avec ancre de remplacement, donc cet article n'inclut aucune image. Vérifiez l'interface et les exemples de sortie dans la console.
Questions fréquentes
Shuyan AI est-il un modèle en soi ?
Non. C'est une couche de données et d'agrégation. L'entreprise n'entraîne pas de modèles de base : elle vend des points d'entrée de parsing, de recherche et d'OCR, plus une place de marché qui route vers des modèles tiers. Le modèle sous-jacent reste votre choix.
Quel avantage face à un crawler maison ?
Surtout le coût de maintenance. Un crawler maison doit gérer le rendu dynamique, les défenses anti-robots, l'obsolescence des sélecteurs et le nettoyage du texte, et une seule refonte peut tout casser. Une API hébergée déplace cette charge vers le fournisseur, au prix du coût unitaire et du contrôle : la maîtrise des règles d'extraction diminue, ce qui gêne sur des pages atypiques.
Se branche-t-il directement sur Dify ou Coze ?
L'éditeur indique que les deux plateformes sont prises en charge et configurables dans un flux d'agent. Vérifiez le nom du plugin et les étapes dans la liste réelle de chaque plateforme, cet article ne les authentifie pas.
Que se passe-t-il après le quota gratuit ?
Les règles de règlement et le prix unitaire au-delà du palier gratuit ne sont pas publics. Terminez la validation dans les 500 appels, puis demandez un devis en confirmant que seule la réussite est facturée, afin que le modèle de coût ne dérive pas.
Questions fréquentes
Shuyan AI est-il un modèle en soi ?
Non. C'est une couche de données et d'agrégation. L'entreprise n'entraîne pas de modèles de base : elle vend des points d'entrée de parsing, de recherche et d'OCR, plus une place de marché qui route vers des modèles tiers. Le modèle sous-jacent reste votre choix.
Quel avantage face à un crawler maison ?
Surtout le coût de maintenance. Un crawler maison doit gérer le rendu dynamique, les défenses anti-robots, l'obsolescence des sélecteurs et le nettoyage du texte, et une seule refonte peut tout casser. Une API hébergée déplace cette charge vers le fournisseur, au prix du coût unitaire et du contrôle : la maîtrise des règles d'extraction diminue, ce qui gêne sur des pages atypiques.
Se branche-t-il directement sur Dify ou Coze ?
L'éditeur indique que les deux plateformes sont prises en charge et configurables dans un flux d'agent. Vérifiez le nom du plugin et les étapes dans la liste réelle de chaque plateforme, cet article ne les authentifie pas.
Que se passe-t-il après le quota gratuit ?
Les règles de règlement et le prix unitaire au-delà du palier gratuit ne sont pas publics. Terminez la validation dans les 500 appels, puis demandez un devis en confirmant que seule la réussite est facturée, afin que le modèle de coût ne dérive pas.



