
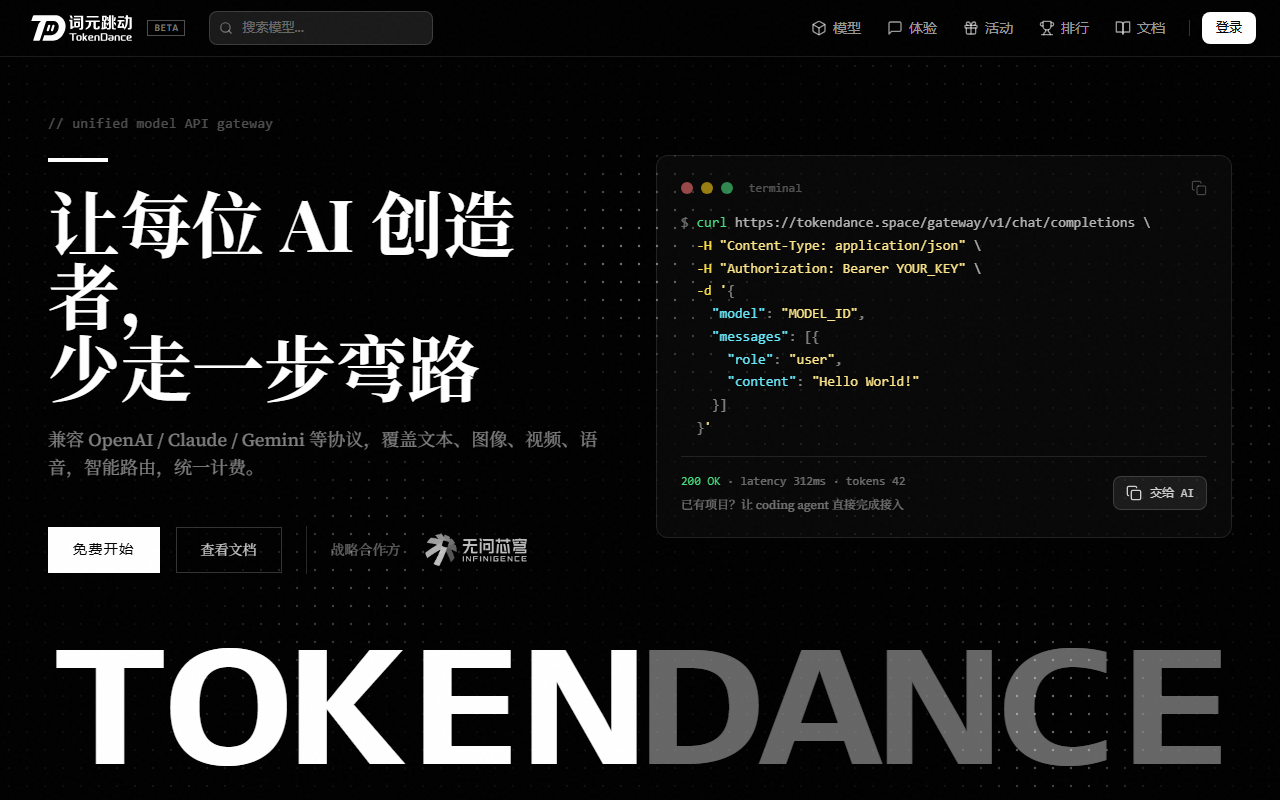
TokenDance est une passerelle d'agrégation d'API pour modèles de langage. Elle prend en charge nativement les protocoles OpenAI, Claude et Gemini : on remplace la Base URL par l'adresse de la passerelle, on renseigne la clé d'API et l'identifiant du modèle, et les appels du SDK existant atteignent MiniMax, Qwen, Kimi, Zhipu, DeepSeek et d'autres modèles chinois. Routage intelligent, facturation unifiée et bascule entre points d'accès sont inclus, sans modification du code métier.
TokenDance : une seule Base URL pour plusieurs modèles chinois
Qui construit un produit d'IA traverse la même phase : brancher un fournisseur pour valider le flux, puis un deuxième et un troisième pour la qualité ou le coût. Bientôt le code porte une couche d'adaptation, les clés se dispersent dans plusieurs consoles, les factures vivent dans des comptes séparés et, quand un fournisseur vacille, quelqu'un bascule le point d'accès à la main. TokenDance vise cette friction : une Base URL devant plusieurs fournisseurs, l'application ne voyant qu'un seul point d'entrée.
Le mécanisme n'a rien d'exotique. Il expose trois formes de protocole majoritaires — OpenAI, Claude, Gemini — et route en interne selon le nom du modèle vers le point d'accès correspondant. Le développeur change de la configuration, pas du code, et c'est ce qui rend crédible la promesse de migration nulle. Sur un projet déjà basé sur le SDK OpenAI, une ligne de Base URL suffit pour tester un modèle chinois : le coût de l'expérimentation chute nettement.
Le reste de la valeur est côté exploitation. Avec plusieurs points d'accès pour un même modèle, la panne d'un fournisseur peut déclencher une bascule automatique ; une requête peut aussi lister des modèles candidats et dégrader pas à pas si le principal ne répond pas. La facturation unifiée regroupe la consommation de jetons de tous les fournisseurs sur une seule facture et supprime les recharges et rapprochements séparés. La source ne détaille ni tarifs, ni limites de requêtes, ni engagements de service, ni conservation des données : à vérifier avant d'intégrer.
Fonctions principales
Compatibilité des protocoles
La prise en charge native d'OpenAI, Claude et Gemini rend le simple changement de Base URL suffisant, sans toucher au code métier. Sur un projet existant, c'est l'aspect le plus concret : tester un nouveau modèle n'impose pas de reconstruire la couche d'appels.
Routage intelligent
Les requêtes sont dirigées selon le nom du modèle vers le bon point d'accès, les détails d'ordonnancement restant cachés derrière une entrée unique. Plus besoin de mémoriser les domaines et les particularités de paramètres de chaque fournisseur.
Facturation unifiée
La consommation de jetons est comptabilisée entre fournisseurs et facturée à un seul endroit, sans recharger cinq consoles. Pour imputer les coûts, une facture s'explique mieux que cinq.
Bascule et dégradation
Un même modèle peut avoir plusieurs points d'accès avec bascule automatique, et une requête peut nommer des modèles candidats pour reculer dans l'ordre. C'est l'avantage le plus tangible d'une passerelle face à l'intégration directe.
Couverture de modèles
Plus de huit modèles chinois majeurs sont connectés, dont MiniMax, Qwen, Kimi, Zhipu et DeepSeek, avec des ajouts réguliers. La couverture concerne les modèles chinois majeurs, pas un catalogue mondial.
Mise en route rapide
L'inscription et la vérification passent par la connexion en un clic de Watcha, et les SDK existants continuent de fonctionner : l'intégration prend quelques minutes. Cette connexion lie le compte à un système précis, condition à accepter.
Programme de subvention
Un formulaire permet de demander un parrainage de jetons selon la phase du produit. Utile pour les projets jeunes, même si le montant et les critères ne sont pas publiés.
Premiers pas
- Ouvrir le site de TokenDance et s'inscrire via la connexion en un clic de Watcha pour vérifier le compte.
- Générer une clé d'API personnelle dans la console et la conserver comme tout identifiant.
- Remplacer la Base URL du projet par l'adresse de la passerelle https://tokendance.space/gateway/v1/.
- Indiquer l'identifiant du modèle visé dans la requête, par exemple DeepSeek ou Kimi.
- Envoyer la requête avec le SDK OpenAI existant ou curl et vérifier que la réponse correspond.
- En cas de fort volume de jetons, remplir le formulaire de subvention selon la phase du produit.
Pour qui
- Jeunes équipes qui comparent plusieurs modèles chinois à faible coût via une passerelle avant de choisir.
- Produits qui routent en production selon le type de tâche : raisonnement, rédaction, code.
- Systèmes d'agents qui ont besoin d'une couche de modèles hautement disponible et dégradable.
- Éducation, recherche et développeurs indépendants sensibles au coût, grâce à la facturation unifiée.
Limites
- Tarifs, quota gratuit, limites de requêtes et engagements de service ne sont pas publiés ; à confirmer avec le fournisseur avant d'intégrer.
- Les comptes exigent la connexion en un clic de Watcha, donc l'acceptation de ce système ; l'intégration à une identité d'entreprise n'est pas décrite.
- La passerelle voit le contenu des requêtes et la politique de conservation ou de journalisation n'est pas indiquée : évaluer la conformité pour les données sensibles.
- Le catalogue se concentre sur les modèles chinois majeurs ; les modèles mondiaux ou ouverts de niche peuvent manquer.
- Un saut supplémentaire ajoute de la latence et un point de défaillance. La bascule aide, mais une supervision propre reste nécessaire.
- Montants, critères et continuité de la subvention ne sont pas publiés ; ne pas fonder dessus un modèle de coûts à long terme.
Questions fréquentes
Faut-il modifier du code ?
Pas le code métier. On remplace la Base URL par celle de la passerelle, on renseigne la clé et le modèle, et on garde le SDK OpenAI comme avant.
Quels modèles sont disponibles ?
La source cite plus de huit modèles chinois majeurs, dont MiniMax, Qwen, Kimi, Zhipu et DeepSeek, avec des ajouts continus. La liste de référence est dans la console.
Comment fonctionne la bascule ?
À deux niveaux : plusieurs points d'accès par modèle avec bascule automatique, et des modèles candidats par requête qui reculent dans l'ordre si le principal échoue.
Quelle différence avec un appel direct à chaque fournisseur ?
L'intégration directe impose de gérer clés, recharges, limites et bascule fournisseur par fournisseur. Une passerelle centralise cela en une entrée et une facture, au prix d'un saut supplémentaire et d'une dépendance à la passerelle.
Existe-t-il un niveau gratuit ?
La source ne mentionne qu'un programme de parrainage demandé selon la phase du produit, sans quota gratuit régulier. À demander au fournisseur.
Questions fréquentes
Faut-il modifier du code ?
Pas le code métier. On remplace la Base URL par celle de la passerelle, on renseigne la clé et le modèle, et on garde le SDK OpenAI comme avant.
Quels modèles sont disponibles ?
La source cite plus de huit modèles chinois majeurs, dont MiniMax, Qwen, Kimi, Zhipu et DeepSeek, avec des ajouts continus. La liste de référence est dans la console.
Comment fonctionne la bascule ?
À deux niveaux : plusieurs points d'accès par modèle avec bascule automatique, et des modèles candidats par requête qui reculent dans l'ordre si le principal échoue.
Quelle différence avec un appel direct à chaque fournisseur ?
L'intégration directe impose de gérer clés, recharges, limites et bascule fournisseur par fournisseur. Une passerelle centralise cela en une entrée et une facture, au prix d'un saut supplémentaire et d'une dépendance à la passerelle.



