

TokenPony convient aux développeurs indépendants, aux petites équipes, aux entreprises et aux chercheurs qui veulent utiliser plusieurs grands modèles en parallèle sans gérer leur propre serveur GPU et qui souhaitent simplifier l'intégration grâce à une interface unique.
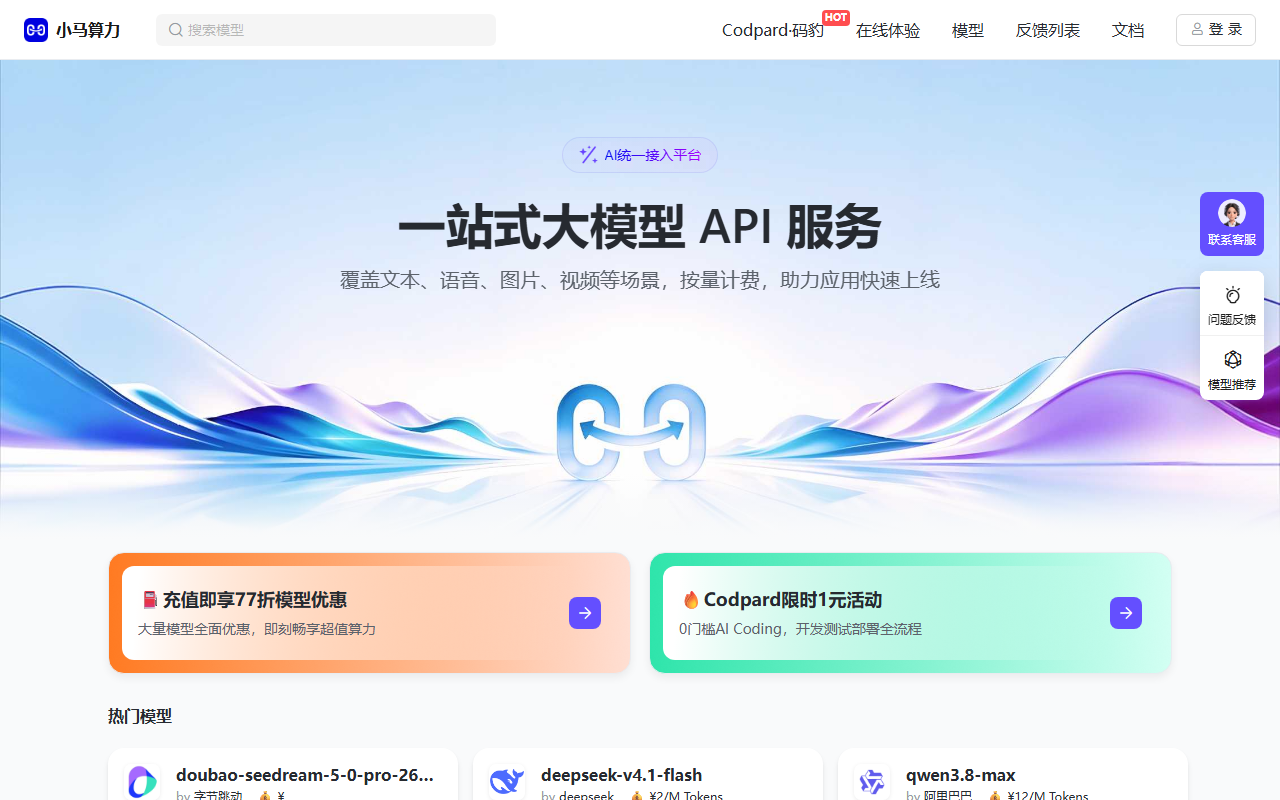
TokenPony : une API unique pour les appels aux grands modèles
TokenPony est une plateforme d'agrégation d'API de modèles d'IA conçue pour les développeurs indépendants et les petites équipes. Son positionnement s'apparente à une fine couche d'orchestration : DeepSeek, Kimi, Qwen, GLM et d'autres grands modèles répandus sont réunis sous une même interface, ce qui évite d'alterner sans cesse entre plusieurs plateformes. Ce qui coûte réellement du temps aux développeurs n'est pas l'appel ponctuel à un modèle, mais le travail d'intégration, d'authentification, de facturation et de maintenance lorsque plusieurs modèles sont utilisés en parallèle. TokenPony regroupe ces aspects en un seul point et propose en plus une fenêtre de contexte de 1024K pour les documents longs, les conversations à plusieurs tours et les tâches d'agent complexes. Il n'est pas nécessaire de mettre en place son propre serveur GPU.
Fonctions principales
Accès à tous les modèles Les grands modèles répandus tels que DeepSeek, Kimi, Qwen et GLM sont intégrés, sans changement de plateforme. Il est possible d'appeler librement différents modèles depuis une même plateforme. Pour les applications qui utilisent plusieurs modèles à la fois, cela évite de répéter la même procédure d'intégration.
Prise en charge des contextes très longs La capacité de traitement de 1024K de contexte convient aux documents longs, aux conversations à plusieurs tours et aux tâches d'agent complexes. La longueur du contexte détermine la quantité de matériaux traitables en une seule fois et constitue la condition préalable pour les tâches sur le texte long.
Appel d'API en un clic Aucune configuration ni déploiement n'est nécessaire : la connexion suffit pour commencer. Les développeurs n'ont pas à gérer le déploiement du service ni la configuration de l'environnement d'exécution ; une fois la clé obtenue, les appels peuvent commencer.
Aucun serveur GPU requis L'utilisation passe par l'API de modèles préentraînés, sans avoir à construire son propre serveur GPU, ce qui évite les coûts matériels. Pour les développeurs indépendants et les petites équipes, c'est souvent le point de décision le plus important.
Optimisation des coûts Une tarification transparente facilite l'arbitrage entre performance et coût. Le coût unitaire varie fortement d'un modèle à l'autre ; une grille tarifaire claire aide donc à maîtriser la dépense globale.
Étapes d'utilisation
- S'inscrire et se connecter : accédez au site officiel du produit, puis terminez l'inscription via l'entrée de connexion en haut à droite de la page.
- Consulter les modèles : sur la page des modèles, consultez la liste des modèles pris en charge et utilisez le filtrage pour retrouver les détails d'un modèle précis.
- Recharger le compte : effectuez le rechargement depuis les « informations utilisateur ». Le moyen de paiement pris en charge est WeChat Pay et le montant minimum est de 10 yuans, destiné aux appels de modèles ultérieurs.
- Créer une clé API : sur la page des modèles, choisissez le modèle à configurer et créez une clé API pour ce modèle.
- Appeler l'interface : à l'aide de la clé créée, appelez le modèle souhaité via l'interface de la plateforme et commencez le développement.
- Gérer la consommation : estimez le volume d'appels par projet et, en tenant compte de la tarification de chaque modèle, choisissez le modèle adapté afin d'éviter une consommation inutile.
Public visé
- Développeurs indépendants : celles et ceux qui souhaitent connecter rapidement plusieurs grands modèles, simplifier le processus de développement et réduire les coûts
- Petites équipes : celles qui veulent exploiter efficacement des ressources limitées et construire puis déployer rapidement des applications fondées sur de grands modèles
- Professionnels créatifs : rédacteurs, créateurs de contenu et métiers voisins, qui souhaitent améliorer leur efficacité et leur qualité grâce à l'IA
- Entreprises : structures qui souhaitent intégrer l'IA à leurs activités sans investir massivement dans leurs propres modèles et infrastructures
- Chercheurs : personnes qui appellent plusieurs modèles avec souplesse pour la recherche et l'expérimentation afin d'explorer de nouveaux usages de l'IA
- Étudiants et enseignants : personnes qui utilisent la plateforme pour l'apprentissage et l'enseignement, afin d'explorer les applications de l'IA dans l'éducation
Limites et précautions
- Les capacités et les paramètres des modèles dépendent des versions effectivement proposées par la plateforme ; les modèles diffèrent par la qualité des réponses, la vitesse et les limites de contexte.
- L'interface d'agrégation ne modifie pas la qualité des réponses du modèle lui-même ; l'exactitude des tâches importantes reste à évaluer et à vérifier de votre côté.
- Les appels sont facturés à l'usage : les contextes longs et les appels fréquents augmentent fortement la facture, une estimation basée sur la consommation réelle est donc nécessaire.
- Une clé API est un identifiant d'accès : conservez-la en lieu sûr et ne la versionnez jamais dans un dépôt de code public.
- Une connexion réseau et la disponibilité de la plateforme sont nécessaires ; les modifications du service ou les pannes affectent la chaîne des appels.
- Pour le rechargement, les moyens de paiement, les prix et les conditions, les pages réelles de la plateforme font foi. Vérifiez les règles en vigueur avant utilisation.
Questions fréquentes
Quel problème TokenPony résout-il ?
TokenPony réunit des grands modèles répandus comme DeepSeek, Kimi, Qwen et GLM sous une seule interface, ce qui évite les allers-retours entre plateformes et la répétition de la même procédure d'intégration. Il propose en plus 1024K de contexte pour les documents longs, les conversations à plusieurs tours et les tâches d'agent complexes. Aucun serveur GPU n'est nécessaire, ce qui supprime les coûts matériels.
Comment appeler un modèle via TokenPony ?
Le parcours est le suivant : s'inscrire et se connecter, consulter les modèles pris en charge sur la page des modèles, effectuer un rechargement depuis les informations utilisateur, choisir le modèle souhaité pour lui créer une clé API, puis appeler le modèle avec cette clé via l'interface de la plateforme. Le rechargement est pris en charge via WeChat Pay, avec un montant minimum de 10 yuans.
À quoi faire attention avec une telle plateforme d'API ?
Les modèles diffèrent par la qualité des réponses, la vitesse et les limites de contexte, et l'agrégation ne modifie pas la qualité des réponses du modèle lui-même. Les appels sont facturés à l'usage : les contextes longs et les appels fréquents augmentent fortement la facture. Une clé API est un identifiant d'accès, à conserver prudemment et à ne jamais versionner dans un dépôt public. Il faut aussi une connexion réseau et la disponibilité de la plateforme ; vérifiez les prix et les règles sur les pages actuelles.



