Wanneng Xiaoin est un second cerveau numérique : il transforme vos documents en base de connaissances personnelle et l'utilise pour des questions web, des brouillons à partir de modèles et des articles longs en un clic, avec un résumé quotidien. Il convient à la recherche, à la création de contenu et aux propositions.
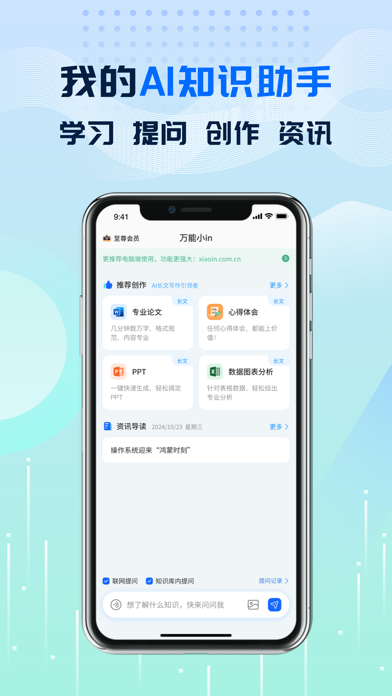
Wanneng Xiaoin : base de connaissances personnelle, modèles de rédaction et réponses web dans un second cerveau IA
Wanneng Xiaoin est un outil de productivité IA construit autour d'une base de connaissances personnelle, présenté comme un second cerveau numérique. Il réunit trois choses : apprendre et organiser les documents importés, produire rapidement des premiers brouillons à partir de plus de cent modèles de rédaction, et répondre aux questions en s'appuyant à la fois sur vos documents et sur la recherche web. La description officielle indique qu'il repose sur plusieurs grands modèles, affinés par réglage fin et ingénierie de consignes pour les travailleurs du savoir.
Le défaut habituel de ces outils est de tout faire un peu sans profondeur. Wanneng Xiaoin parie plus clairement : au lieu d'une conversation généraliste, il construit une chaîne de l'entrée à la sortie, transforme vos documents en base de connaissances, s'en sert pour les questions et les brouillons, et maintient l'entrée avec un résumé quotidien de l'actualité.
Dans le travail de connaissance, le goulot n'est pas d'écrire mais de vérifier ensuite : les affirmations ont-elles une source, les chiffres sont-ils justes, les citations viennent-elles de documents réellement lus. Relier une base personnelle aux questions et à la génération de brouillons vise à réduire cette seconde passe, et c'est ce qui distingue l'outil d'un assistant de rédaction ordinaire.
Tout ce qui suit provient de la description publique du produit. Aucun prix, liste de modèles ou limite de stockage non divulgué n'a été ajouté, et les fonctions disponibles sont à confirmer sur la version actuelle.
Cinq capacités en une chaîne
Rédiger d'un clic à partir d'un titre
Selon la description officielle, un titre suffit pour produire un long article correctement formaté et au contenu professionnel. Ce point d'entrée convient à deux cas : un sujet clair dont on veut vite voir la forme finale, et une situation où il faut un brouillon modifiable avant de commencer. Le mot brouillon pèse : il abaisse le coût du passage de rien à quelque chose, sans remplacer le jugement ni la vérification.
Base de connaissances personnelle
C'est le socle du produit. Une fois les documents importés, l'IA apprend d'eux et aide à les organiser, de sorte que questions et brouillons s'appuient sur votre matière et non seulement sur les connaissances générales du modèle. Pour une analyse sectorielle, un bilan de projet ou un sujet de long terme, cette étape décide si la sortie est fluide mais vide ou concrète et étayée.
Brouillons à partir de modèles
La documentation officielle mentionne plus de cent modèles capables de produire en quelques minutes des brouillons de plusieurs dizaines de milliers de caractères. La valeur n'est pas la longueur mais la structure : combien de sections pour un rapport, quels chapitres pour une proposition, comment ouvrir une publication. Avec une structure, modifier devient remplir et substituer plutôt que réécrire.
Questions sur deux canaux
Les questions peuvent être traitées via le web ou via la base personnelle, l'IA fournissant une réponse précise et personnalisée. Chaque canal a son rôle : le web couvre l'actualité et l'information nouvelle, la base couvre ce que disent vos documents. Quand il faut recouper, utiliser les deux est plus sûr que se fier à un seul.
Résumé quotidien de l'actualité
L'outil collecte automatiquement les contenus les plus qualitatifs du jour et les met en forme pour la lecture. Son rôle est de maintenir le rythme d'entrée, car le maillon qui casse le plus facilement chez ceux qui écrivent n'est pas la sortie mais la lecture continue. Un résumé permet de parcourir en peu de temps ce qui valait la peine ce jour-là.
Un flux réutilisable
- Charger d'abord la base de connaissances. Importer rapports, notes et textes passés par thème ; mieux vaut peu de fichiers précis qu'un déversement de documents sans rapport.
- Faire un contrôle rapide : poser quelques questions auxquelles seule votre matière peut répondre et voir si l'outil cite ce que vous reconnaissez, ce qui indique si les documents ont été utilement assimilés.
- Pour rédiger, choisir le modèle avant de donner le titre. Le modèle fixe la structure, le titre fixe l'angle, et les brouillons ainsi obtenus demandent le moins de reprise.
- Traiter le brouillon comme un brouillon. Vérifier faits et chiffres paragraphe par paragraphe, remplacer les formulations génériques par des cas concrets de la base et supprimer les phrases sans appui.
- Lire chaque jour le résumé d'actualité et replacer dans la base ce qui touche aux sujets en cours, pour fermer la boucle entre entrée et sortie.
À qui cela convient
- Analystes en recherche sectorielle, conseil et investissement qui entretiennent sujets et archives de sources dans la durée.
- Créateurs publiant plusieurs longs textes par semaine et perdant des heures sur la structure et le premier jet.
- Rédacteurs de propositions et formateurs qui transforment documents passés et notes de projet en matière réutilisable.
- Apprenants qui veulent organiser la lecture quotidienne dans un système plutôt que dans des favoris dispersés.
Limites à connaître
- Le prix de l'abonnement, le quota gratuit et la capacité de la base ne sont pas précisés : les décisions de coût et d'échelle dépendent des informations actuelles dans l'application.
- Modèles et rédaction en un clic produisent des premiers brouillons : les contenus politiques, médicaux ou financiers doivent être vérifiés aux sources originales, l'outil n'assurant pas la vérification des faits.
- La qualité des réponses dépend de la qualité de ce qui a été importé : des documents d'origine douteuse ou des versions périmées propagent des erreurs dans les réponses et les brouillons, d'où la nécessité d'un nettoyage régulier.
- Les réponses via le web dépendent des résultats récupérés : une question exigeant des chiffres exacts ou des clauses à jour demande encore d'ouvrir la page d'origine.
- Aucune capture d'écran ici : la source ne contient pas de visuel officiel vérifiable, donc l'image est omise pour ne pas suggérer une interface.
Questions fréquentes
Quelle différence avec un chat IA généraliste ?
Un chat généraliste s'appuie sur les connaissances du modèle. Wanneng Xiaoin s'organise autour d'une base personnelle : il apprend d'abord vos documents, puis les questions et les brouillons s'y appuient, avec des modèles produisant des brouillons structurés. La différence se voit dans la présence ou non de vos propres preuves.
Un titre suffit-il pour obtenir un long article ?
La description officielle permet de générer un long article formaté et professionnel à partir d'un titre. Le résultat réel dépend de la clarté du sujet et de la richesse de la base : à traiter comme un bon premier brouillon exigeant encore une relecture humaine.
Qui en profite le plus ?
Les professionnels qui lisent, organisent et écrivent en continu : recherche sectorielle, création de contenu, rédaction de propositions, préparation de cours. Pour des questions occasionnelles, l'apport est plus limité.
Les documents de la base sont-ils sûrs ?
La description ne détaille ni l'emplacement de stockage, ni le chiffrement, ni les durées de conservation. Avec des données clients ou des contenus non publiés, testez à petite échelle et lisez les conditions de confidentialité avant de décider quoi importer.