

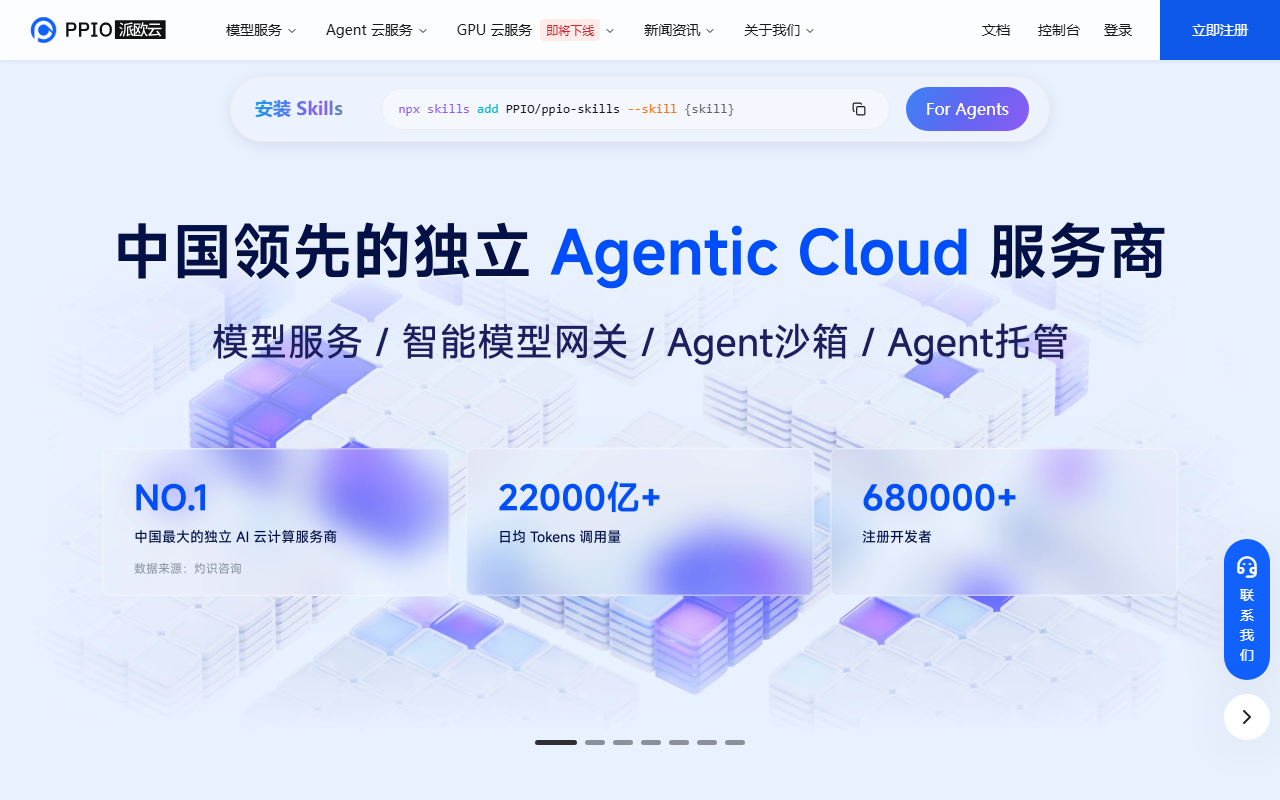
PPIO Paiouyun एक वितरित क्लाउड प्लेटफॉर्म है जो बिखरे GPU संसाधनों को एक कंप्यूट नेटवर्क में जोड़ता है, जिससे OpenAI-संगत API या माँग पर GPU इंस्टेंस से जनरेटिव AI सुविधाएँ बनाई जा सकती हैं और उद्यम समर्पित निजी क्लस्टर चुन सकते हैं।
PPIO Paiouyun क्या है
PPIO Paiouyun एक वितरित क्लाउड कंप्यूटिंग प्रदाता है जो नेटवर्क के किनारे और क्षेत्रीय डेटा सेंटरों में मौजूद प्रोफेशनल सर्वर क्षमता को एक ही कंप्यूट नेटवर्क में जोड़ता है। यह साझा अर्थव्यवस्था (शेयरिंग इकोनॉमी) के मॉडल को बिग डेटा, क्लाउड-नेटिव और वितरित कंप्यूटिंग तकनीकों के साथ जोड़कर यह क्षमता AI इन्फरेंस API, GPU इंस्टेंस और उद्योग-विशिष्ट समाधानों के रूप में देता है। मुख्य कारोबारी क्षेत्र हैं AI इन्फरेंस क्लाउड, ऑडियो-वीडियो समाधान, मेटावर्स के लिए क्लाउड रेंडरिंग और उद्यमों के लिए निजी डिप्लॉयमेंट। उत्पाद की आधिकारिक साइट ppio.cn है।
पारंपरिक पब्लिक क्लाउड अपने ही डेटा सेंटरों की वर्चुअल मशीनें बेचता है, जबकि PPIO खुद को कंप्यूट क्षमता का एग्रीगेटर और शेड्यूलर मानता है। एक ओर यह हाइपरस्केल डेटा सेंटर, क्षेत्रीय कंप्यूट नोड और खाली पड़े उपकरण जैसे विषम संसाधन जुटाता है; दूसरी ओर उन्हें एक ही कंसोल, साझा API और अपने इन्फरेंस एक्सेलेरेशन इंजन के जरिए उपलब्ध कराता है। प्लेटफॉर्म पर DeepSeek-R1-0528 जैसे नए मॉडल भी उपलब्ध हैं, जिन्हें API से कॉल किया जा सकता है या मॉडल मार्केटप्लेस में सीधे आज़माया जा सकता है।
मुख्य क्षमताएँ
मॉडल API सेवा
प्लेटफॉर्म बड़े भाषा मॉडल के API के साथ इमेज और वीडियो जनरेशन मॉडल के API भी देता है। एंडपॉइंट OpenAI API मानक के अनुरूप हैं, इसलिए ज़्यादातर प्रोजेक्ट्स में बदलाव सिर्फ़ बेस URL, API कुंजी और मॉडल नाम तक सीमित रहता है और मौजूदा OpenAI SDK कोड चलता रहता है। PPIO 99.9% तक स्थिरता का दावा करता है और मल्टीमॉडल मॉडलों के बीच सेकंडों में स्विचिंग के साथ इन्फरेंस एक्सेलेरेशन देता है, जो उन टीमों के लिए उपयोगी है जो कई मॉडल तुलना करती हैं या एक ही उत्पाद में टेक्स्ट और इमेज जनरेशन मिलाती हैं।
GPU क्लाउड
GPU क्षमता दो रूपों में मिलती है। GPU कंटेनर इंस्टेंस कंटेनरीकृत GPU संसाधन, उपयोग-आधारित बिलिंग, तैयार इमेज और एक-क्लिक डिप्लॉयमेंट देते हैं — प्रशिक्षण, फाइन-ट्यूनिंग और बैच इन्फरेंस के लिए उपयुक्त जहाँ आप खुद एनवायरनमेंट संभालते हैं। Serverless GPUs कस्टम मॉडल के लिए बिना इंफ्रास्ट्रक्चर ऑपरेशन के डिप्लॉयमेंट देते हैं, ऑटो स्केलिंग, लोड बैलेंसिंग और सेकंडों में कोल्ड स्टार्ट के साथ, जो उतार-चढ़ाव वाले ऑनलाइन ट्रैफिक के लिए ठीक है।
ऑडियो-वीडियो समाधान
व्यापक रूप से वितरित एज नोड और मीडिया क्षेत्र के अनुभव के आधार पर यह श्रेणी हार्डवेयर, नेटवर्क और मीडिया तकनीक जोड़कर लंबे और छोटे वीडियो ऑन-डिमांड, मनोरंजन लाइव स्ट्रीमिंग, वीडियो कॉल और इंटरैक्टिव लाइव के लिए एक-स्टॉप समाधान देती है। दावा है उच्च गुणवत्ता, कम लागत और स्थिर डिलीवरी।
क्लाउड रेंडरिंग और मेटावर्स
एज कंप्यूट पर ओपन-सोर्स प्रोफेशनल ग्राफिक्स सॉफ्टवेयर चलाकर प्लेटफॉर्म मेटावर्स जैसे ऐप्स के लिए स्वचालित क्लाउड रेंडरिंग देता है, जिन्हें एसेट या फ्रेम दूर से रेंडर करने होते हैं।
उद्यमों के लिए निजी डिप्लॉयमेंट
जो संस्थाएँ डेटा साझा क्लाउड पर नहीं भेज सकतीं, उनके लिए समर्पित GPU क्लस्टर और पूरी तरह प्रबंधित ऑपरेशन उपलब्ध है: मॉडल सर्विंग स्टैक कंपनी के नियंत्रित वातावरण में रहता है और रोज़ का संचालन प्रदाता के पास।
शुरुआत कैसे करें
- खाता बनाएँ आधिकारिक साइट पर फ़ोन नंबर या उपयोगकर्ता नाम से।
- पहचान सत्यापित करें — व्यक्तिगत या कॉर्पोरेट सत्यापन कंप्यूट और API चालू होने से पहले ज़रूरी है।
- बैलेंस भरें खाता अवलोकन पेज से; Alipay, WeChat Pay और कॉर्पोरेट बैंक ट्रांसफर समर्थित हैं।
- API कुंजी बनाएँ कुंजी प्रबंधन पेज में, अगर API इस्तेमाल करना है, और उसे फ्रंटएंड कोड या सार्वजनिक रिपॉज़िटरी में न रखें।
- मॉडल कॉल करें: मॉडल मार्केटप्लेस में कार्ड चुनें और ऑनलाइन ट्रायल पैनल में पैरामीटर सेट करके चलाएँ। इंटीग्रेशन के लिए OpenAI-संगत क्लाइंट को प्लेटफॉर्म एंडपॉइंट, कुंजी और मॉडल नाम के साथ इस्तेमाल करें; Python SDK कोड अक्सर वैसा ही चलता है।
- GPU चलाएँ: कंसोल से GPU कंटेनर इंस्टेंस या Serverless डिप्लॉयमेंट बनाएँ, स्पेसिफिकेशन, इमेज या मॉडल और स्केलिंग नियम चुनें।
कहाँ उपयुक्त है
- जनरेटिव AI उत्पाद लॉन्च करना: चैट, लेखन, इमेज और वीडियो जनरेशन बिना अपना इन्फरेंस क्लस्टर बनाए।
- वीडियो और लाइव स्ट्रीमिंग: ऑन-डिमांड, मनोरंजन और इंटरैक्टिव स्ट्रीमिंग के लिए ट्रांसकोडिंग और डिलीवरी।
- बैच रेंडरिंग: फ़िल्म, आर्किटेक्चरल विज़ुअलाइज़ेशन और मेटावर्स सीन।
- लचीली क्षमता: अचानक ट्रैफिक या समय-सीमित ट्रेनिंग जॉब्स, उपयोग-आधारित बिलिंग पर।
- ऑटोनॉमस ड्राइविंग और शोध: कम विलंबता, उच्च बैंडविड्थ या बड़े पैमाने पर समानांतर गणना वाले काम।
सीमाएँ और ध्यान देने योग्य बातें
- 99.9% स्थिरता, सेकंडों में कोल्ड स्टार्ट और तुरंत मॉडल स्विच जैसे आँकड़े विक्रेता के दावे हैं; यहाँ स्वतंत्र रूप से मापे नहीं गए, इसलिए अपने ट्रैफिक पर परखें।
- बिलिंग प्रीपेड और उपयोग-आधारित मिली-जुली है और पहचान सत्यापन अनिवार्य है। दरें, मुफ़्त कोटा और छूट कंसोल और सेल्स टीम से पता करें; इस लेख में कोई कीमत नहीं दी गई।
- मॉडल सूची बदलती रहती है। DeepSeek-R1-0528 और अन्य मॉडलों की उपलब्धता उपयोग के समय मार्केटप्लेस में जाँचें।
- ऑडियो-वीडियो समाधान और निजी डिप्लॉयमेंट B2B सौदे हैं जिनमें सेल्स प्रक्रिया लगती है, तुरंत सेल्फ-सर्विस नहीं।
- API कुंजियाँ संवेदनशील हैं: लीक होने पर असली खर्च बन सकता है, इसलिए प्रोजेक्ट के हिसाब से अलग रखें और समय-समय पर बदलें।
सामान्य प्रश्न
सामान्य पब्लिक क्लाउड GPU से क्या अलग है? सामान्य पब्लिक क्लाउड मुख्यतः अपने डेटा सेंटर के इंस्टेंस बेचता है। PPIO किनारे और क्षेत्रीय विषम क्षमता जुटाकर एक ही API और शेड्यूलिंग परत से देता है, इसलिए एक ही कंसोल में उपयोग-आधारित GPU, Serverless डिप्लॉयमेंट और OpenAI-संगत API मिलते हैं। यह उन टीमों के लिए ठीक है जिन्हें अभी प्रबंधित API चाहिए और आगे अपना इन्फरेंस स्टैक भी।
OpenAI SDK इस्तेमाल करने वाले प्रोजेक्ट को शिफ्ट करने में कितना काम है? आम तौर पर तीन सेटिंग बदलती हैं: बेस URL, API कुंजी और मॉडल नाम। बिज़नेस लॉजिक वैसा ही रहता है। प्रोडक्शन ट्रैफिक शिफ्ट करने से पहले स्टेजिंग में स्ट्रीमिंग और टूल कॉलिंग सहित रिग्रेशन चलाएँ।
छोटे प्रयोग के लिए GPU इंस्टेंस चाहिए? नहीं। पहले मार्केटप्लेस में आज़माएँ, फिर API उपयोग के अनुसार कॉल करें, जो हमेशा चालू इंस्टेंस से सस्ता है। कस्टम मॉडल, विशेष डिपेंडेंसी या अनुमानित विलंबता की ज़रूरत पर GPU या Serverless पर जाएँ।
क्या कंपनी डेटा अपने वातावरण में रख सकती है? हाँ, समर्पित GPU क्लस्टर और पूरी तरह प्रबंधित निजी डिप्लॉयमेंट के जरिए। क्लस्टर आकार, नेटवर्क अलगाव और समय-सीमा सेल्स टीम से तय होती है।

अक्सर पूछे जाने वाले प्रश्न
सामान्य पब्लिक क्लाउड GPU से क्या अलग है?
सामान्य पब्लिक क्लाउड अपने इंस्टेंस बेचता है। PPIO किनारे और क्षेत्रीय विषम क्षमता जुटाकर एक API और शेड्यूलिंग परत से देता है, इसलिए एक कंसोल में उपयोग-आधारित GPU, Serverless और OpenAI-संगत API मिलते हैं।
OpenAI SDK वाले प्रोजेक्ट को शिफ्ट करने में कितना काम है?
बेस URL, API कुंजी और मॉडल नाम बदलते हैं; बिज़नेस लॉजिक वैसा रहता है। ट्रैफिक शिफ्ट से पहले स्टेजिंग में स्ट्रीमिंग और टूल कॉलिंग का रिग्रेशन चलाएँ।
छोटे प्रयोग के लिए GPU इंस्टेंस चाहिए?
नहीं। पहले मार्केटप्लेस में आज़माएँ, फिर API उपयोग के अनुसार कॉल करें। कस्टम मॉडल या अनुमानित विलंबता के लिए GPU या Serverless चुनें।
क्या कंपनी डेटा अपने वातावरण में रख सकती है?
हाँ, समर्पित GPU क्लस्टर और पूरी तरह प्रबंधित निजी डिप्लॉयमेंट से; आकार, नेटवर्क अलगाव और समय-सीमा सेल्स टीम से तय होती है।



