

PPIO Paiouyun è una piattaforma cloud distribuita che raccoglie risorse GPU sparse in un'unica rete di calcolo: si lanciano funzioni di IA generativa con API compatibili OpenAI o istanze GPU a consumo, e le aziende possono scegliere un cluster privato dedicato.
Che cos'è PPIO Paiouyun
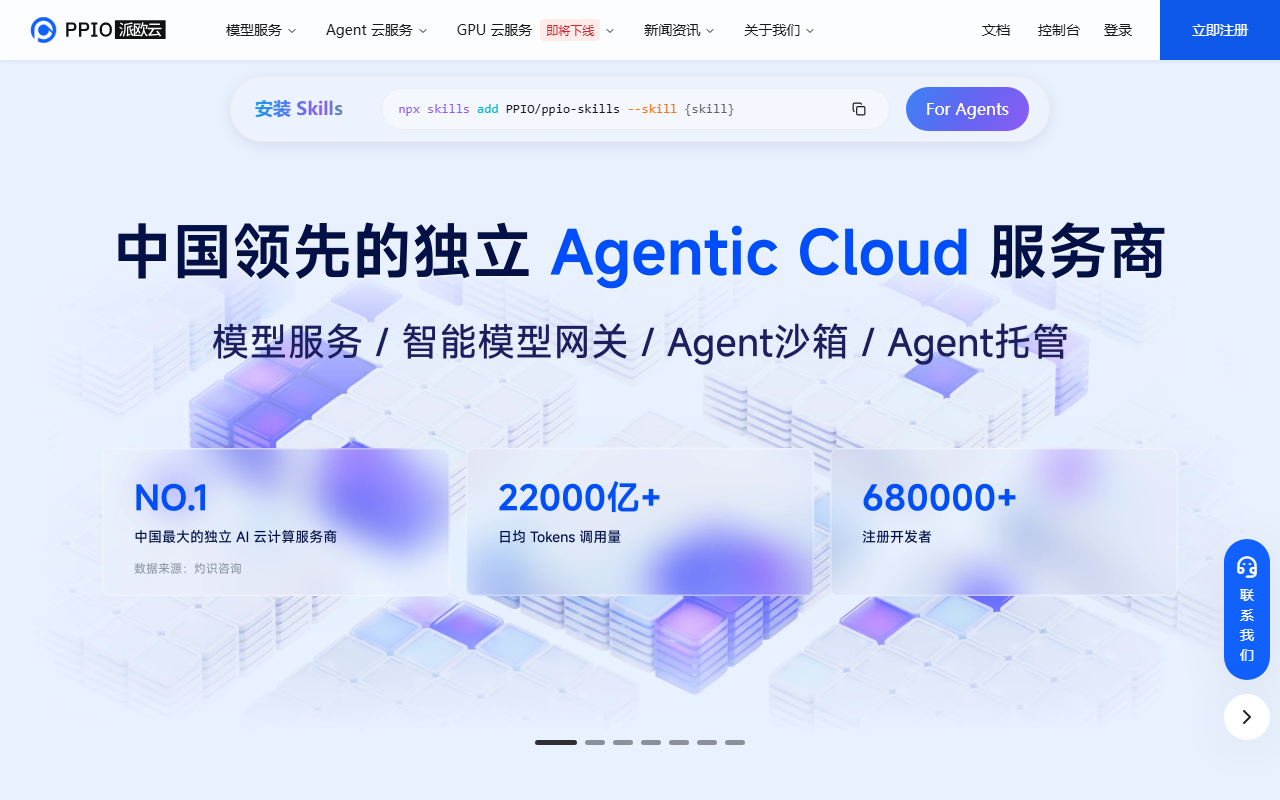
PPIO Paiouyun è un fornitore di cloud computing distribuito che riunisce la capacità di server professionali collocati al bordo della rete e in data center regionali in un'unica rete di calcolo. Combina un modello di economia condivisa con tecnologie big data, cloud native e calcolo distribuito, per poi erogare quella capacità come API di inferenza IA, istanze GPU e soluzioni verticali. Le linee principali sono il cloud di inferenza IA, le soluzioni audio e video, il rendering cloud per il metaverso e il deployment privato per le aziende. Il sito ufficiale del prodotto è ppio.cn.
A differenza di un cloud pubblico tradizionale, che in prevalenza rivende macchine virtuali dei propri data center, PPIO si posiziona come aggregatore e scheduler di calcolo. Da un lato raccoglie risorse eterogenee — data center iperscalabili, nodi regionali e apparecchi inutilizzati —; dall'altro le espone tramite una console unica, un'API comune e un motore proprietario di accelerazione dell'inferenza. La piattaforma propone anche modelli recenti come DeepSeek-R1-0528, richiamabili via API o provabili direttamente nel catalogo modelli.
Funzionalità principali
Servizio API per i modelli
Sono disponibili API per grandi modelli linguistici e per la generazione di immagini e video. Gli endpoint seguono lo standard OpenAI API, quindi nella maggior parte dei progetti la migrazione si riduce a cambiare URL di base, chiave e nome del modello, mantenendo il codice esistente dell'SDK OpenAI. PPIO dichiara una stabilità fino al 99,9% e consente di passare tra modelli multimodali in pochi secondi con accelerazione dell'inferenza: utile per team che confrontano più modelli o uniscono testo e immagini in un unico prodotto.
Cloud GPU
La capacità GPU arriva in due forme. Le istanze container GPU forniscono risorse containerizzate con fatturazione a consumo, immagini pronte e deployment in un clic: adatte ad addestramento, fine-tuning e inferenza batch quando l'ambiente è gestito da te. Le GPU serverless sono pensate per modelli personalizzati senza infrastruttura da operare, con scalabilità automatica, bilanciamento del carico e avvio a freddo in pochi secondi, ideali per inferenza online con traffico irregolare.
Soluzioni audio e video
Basata su nodi di bordo ampiamente distribuiti e anni di esperienza nel settore media, questa linea integra hardware, rete e tecnologie audiovisive per video on demand lungo e breve, streaming di intrattenimento, videochiamate e dirette interattive. La promessa è uno stack completo con qualità alta, costo contenuto e distribuzione stabile.
Rendering cloud e metaverso
Con software grafico professionale open source eseguito sul calcolo di bordo, la piattaforma offre un deployment automatico del rendering cloud per applicazioni di tipo metaverso che devono calcolare asset o frame in remoto.
Deployment privato per le aziende
Per le organizzazioni che non possono inviare dati a un cloud condiviso esiste un cluster GPU dedicato con gestione completamente in outsourcing: lo stack di serving resta in un ambiente controllato dall'azienda, mentre le operazioni quotidiane restano al fornitore.
Come iniziare
- Creare un account sul sito ufficiale con numero di telefono o nome utente.
- Verificare l'identità: la verifica personale o aziendale è obbligatoria prima di attivare calcolo e API.
- Ricaricare il saldo dalla pagina di riepilogo dell'account; sono supportati Alipay, WeChat Pay e bonifico aziendale.
- Generare una chiave API nella pagina di gestione delle chiavi se usi le API, senza inserirla nel codice frontend o in repository pubblici.
- Chiamare un modello: apri il catalogo, scegli una scheda e usa il pannello di prova online con i tuoi parametri. Per l'integrazione punta un client compatibile OpenAI sull'endpoint della piattaforma con chiave e nome del modello; il codice Python di solito si riusa così com'è.
- Avviare carichi GPU: crea istanze container o deployment serverless dalla console scegliendo specifica, immagine o modello e regole di scalabilità.
Dove si inserisce
- Lanciare prodotti di IA generativa: chat, scrittura, generazione di immagini e video senza un cluster di inferenza proprio.
- Video e dirette: transcodifica e distribuzione per on demand, intrattenimento e streaming interattivo.
- Rendering batch: cinema, visualizzazione architettonica e scene di metaverso.
- Capacità elastica: picchi di traffico o addestramenti occasionali a consumo.
- Guida autonoma e ricerca: carichi che richiedono bassa latenza, banda elevata o calcolo parallelo massivo.
Limiti e punti da verificare
- Valori come il 99,9% di stabilità, l'avvio a freddo in pochi secondi e il cambio istantaneo di modello sono dichiarazioni del fornitore; qui non sono stati misurati in modo indipendente, quindi testali con il tuo traffico prima di decidere.
- La fatturazione unisce prepagato e consumo, e la verifica dell'identità è obbligatoria. Prezzi unitari, quote gratuite e sconti si ricavano dalla console e dal team commerciale; questo articolo non riporta tariffe.
- Il catalogo modelli cambia. La disponibilità di DeepSeek-R1-0528 e di altri modelli va verificata nel catalogo al momento dell'uso.
- Le soluzioni audio/video e il deployment privato sono progetti business-to-business che passano da una trattativa commerciale, non da un self-service immediato.
- Le chiavi API sono sensibili: una fuga può generare costi reali, quindi separale per progetto e ruotale periodicamente.
Domande frequenti
Qual è la differenza rispetto a una GPU di un cloud pubblico normale? Un cloud pubblico normale vende soprattutto istanze dei propri data center. PPIO aggrega capacità eterogenea di bordo e regionale e la espone con un'unica API e un unico strato di scheduling: nella stessa console convivono GPU a consumo, deployment serverless e API compatibili OpenAI. Un mix adatto a chi oggi vuole un'API gestita e domani forse uno stack di inferenza proprio.
Quanto costa migrare un progetto che usa già l'SDK OpenAI? Di norma cambiano tre impostazioni: URL di base, chiave API e nome del modello. La logica di business resta intatta. Esegui una regressione in staging che copra streaming e chiamate agli strumenti prima di spostare il traffico.
Serve un'istanza GPU per una prova piccola? No. Prova prima nel catalogo modelli e poi chiama l'API a consumo: costa meno di un'istanza sempre accesa. Passa a GPU o serverless quando servono modelli personalizzati, dipendenze particolari o latenza prevedibile.
Un'azienda può tenere i dati nel proprio ambiente? Sì, con cluster GPU dedicato e deployment privato completamente gestito. Dimensione del cluster, isolamento di rete e tempi si concordano con il team commerciale.

Domande frequenti
Qual è la differenza rispetto a una GPU di un cloud pubblico normale?
Il cloud pubblico vende soprattutto istanze proprie. PPIO aggrega capacità eterogenea di bordo e regionale e la espone con un'unica API e strato di scheduling: GPU a consumo, serverless e API compatibili OpenAI nella stessa console.
Quanto costa migrare un progetto che usa già l'SDK OpenAI?
Cambiano URL di base, chiave e nome del modello; la logica di business resta. Esegui una regressione in staging con streaming e chiamate agli strumenti prima di spostare il traffico.
Serve un'istanza GPU per una prova piccola?
No. Prova nel catalogo modelli e poi usa l'API a consumo, meno costosa di un'istanza sempre attiva. Passa a GPU o serverless per modelli personalizzati o latenza prevedibile.
Un'azienda può tenere i dati nel proprio ambiente?
Sì, con cluster GPU dedicato e deployment privato gestito; dimensione, isolamento di rete e tempi si concordano con il team commerciale.



