

Shuyan AI è un fornitore di API per team il cui modello non vede il web. Offre tre interfacce principali: estrazione web che riceve un URL e restituisce Markdown o JSON strutturato, ricerca live su fonti giornalistiche, enciclopediche e accademiche, e OCR che converte PDF e scansioni in testo con gerarchia conservata. Un marketplace aggiunge chiamate aggregate a modelli di terzi e integrazione tramite protocollo standard. I nuovi account ricevono 500 chiamate gratuite, l'API è REST e il deployment privato è previsto. Le cifre su latenza e prezzo sono dichiarazioni del fornitore.
Shuyan AI: API per estrazione web, ricerca live e OCR dei documenti
Chi costruisce agenti prima o poi sbatte contro lo stesso muro: il modello è abbastanza intelligente, ma non vede la pagina che deve leggere. O la sua conoscenza si ferma alla data di addestramento, o l'HTML arriva sepolto sotto menu e pubblicità, o il documento decisivo esiste solo come PDF scansionato. Shuyan AI colpisce esattamente questo spazio. Non addestra modelli, vende la conduttura che riporta il mondo esterno in una forma assimilabile. Tre domande decidono se integrarla: l'output è davvero pulito e strutturato, un risultato di ricerca è riconducibile a una fonte verificabile, e la latenza tiene alla concorrenza che serve.
L'azienda si presenta come infrastruttura dati per l'era dei grandi modelli e descrive l'approccio come bimodale, unendo visione e codice. Un percorso interpreta la pagina come viene renderizzata, l'altro estrae la struttura con logica di codice, e i due si controllano a vicenda. Questo affronta due debolezze classiche dello scraping: le pagine renderizzate lato client che una semplice richiesta HTTP non vede mai, e i selettori fragili che cedono al primo cambio di layout. Il fornitore dichiara un indice che copre oltre 300 domini e centinaia di milioni di record strutturati, con il rumore pubblicitario filtrato.
L'offerta si divide in tre livelli. In basso le tre interfacce dati: estrazione, ricerca e OCR. Sopra un marketplace che raggruppa le chiamate a più fornitori, agenti conversazionali, una modalità di ricerca approfondita e l'integrazione nei flussi di lavoro tramite protocollo standard. Ai margini servizi di dataset e una piattaforma di analisi. La maggior parte dei team userà solo due o tre endpoint del livello inferiore; il resto sono capacità adiacenti dello stesso fornitore da valutare separatamente.
Come funzionano le capacità centrali
Estrazione web: ricostruire la pagina renderizzata come testo leggibile
Si invia un URL e si riceve Markdown o JSON strutturato. Il valore non sta nel poter scaricare la pagina, ma nel non dover scrivere regole di pulizia dopo: corpo del testo, gerarchia dei titoli e tabelle vengono conservati dove possibile, pubblicità e navigazione scartate. In una pipeline di recupero questo passo fissa il tetto della qualità dei frammenti, e quella qualità fissa il tetto del recupero. Un ingresso sporco produce frammenti vicini nello spazio vettoriale e inutili in pratica. Il supporto dichiarato a pagine con rendering dinamico e layout complessi è esattamente ciò che un percorso visivo aggiunge a un parser DOM puro.
Ricerca live: uno strato di recupero citabile
L'endpoint di ricerca è progettato per il consumo da parte dei modelli e restituisce frammenti valutati e strutturati, non un elenco grezzo di link. Le fonti dichiarate coprono notizie, enciclopedie, materiale accademico e piattaforme media, aggiornate contro una scansione ampia e un archivio di siti proprio. Nelle applicazioni di ricerca la differenza visibile è nell'ampiezza dei riferimenti: il fornitore afferma che la modalità approfondita consulta sette volte più pagine di una ricerca ordinaria, il che significa contesto più lungo e più margine per il confronto incrociato.
OCR dei documenti: conservare la gerarchia, non solo i caratteri
Si carica un PDF o una scansione e il motore estrae testo, tabelle e formule in Markdown e JSON che mantengono la struttura del documento. La difficoltà non è mai stata riconoscere singoli glifi, ma ricostruire l'organizzazione: quale riga è un titolo, quale tabella attraversa tre pagine, quale simbolo di una formula è un pedice. La gerarchia conta a valle perché una base di conoscenza segmenta lungo i titoli. Persa la struttura, resta solo il taglio a numero fisso di caratteri, che spezza frasi e tabelle.
Marketplace e protocollo standard: chiamate e dati su un solo livello
Il marketplace aggrega più fornitori di modelli dietro un unico endpoint con fatturazione e formati unificati, evitando la manutenzione di più deployment. L'integrazione tramite protocollo standard immette ricerca ed estrazione nei flussi di intelligenza artificiale con un'interfaccia comune, risparmiando a chi già usa quel protocollo la riscrittura della logica di chiamata degli strumenti. Il vantaggio congiunto è configurare in un solo punto: lato dati e lato modelli smettono di essere integrazioni separate con guasti separati.
Come iniziare
- Registrati sul sito ufficiale e crea una chiave API. I nuovi account includono 500 chiamate gratuite, sufficienti a provare le tre interfacce prima di impegnare un budget.
- Valida l'estrazione sulle pagine che contano davvero. Scegli da dieci a venti URL reali, inclusi rendering dinamico, tabelle complesse e articoli lunghi suddivisi in pagine, e controlla se il Markdown restituito conserva la struttura necessaria. Non giudicare dalla pagina di esempio del fornitore.
- Per l'OCR prepara prima campioni limite: impaginazione a due colonne, tabelle a cavallo di salti di pagina e scansioni con formule. Gli errori di struttura si concentrano proprio lì, e trovarli prima del lancio costa molto meno.
- Se usi già piattaforme di sviluppo per agenti, inserisci la capacità in un flusso invece di scrivere un backend. Per l'integrazione diretta chiama gli endpoint REST e scegli Markdown quando una persona riesamina l'output, JSON quando lo analizza un programma.
- Per carichi pubblici e finanziari il fornitore propone deployment privato ad alta concorrenza, ma forma di consegna, tempi e costo non sono pubblicati: servono trattative commerciali.
Prezzi e quote
- L'unico dato pubblicato sono 500 chiamate gratuite per nuovo account. Bastano per una prova di concetto e sono lontane dal volume di produzione.
- La fatturazione è a token e il fornitore colloca il prezzo intorno a un terzo dei servizi comparabili, addebitando solo le chiamate riuscite. Addebitare solo il successo pesa più qui che in un'API di testo, perché i fallimenti di estrazione sono per natura più frequenti.
- Prezzo unitario per endpoint, fasce di volume, preventivo per il deployment privato e regole di liquidazione oltre la quota gratuita non sono pubblicati. Vanno confermati nella console o con il reparto commerciale prima di proiettare i costi.
A chi serve
- Sviluppatori che costruiscono agenti su piattaforme pronte e hanno bisogno di lettura pagine e ricerca live senza mantenere crawler e pool di proxy.
- Team di recupero documentale e basi di conoscenza il cui materiale interno vive in PDF e scansioni e deve prima diventare testo suddivisibile con gerarchia.
- Prodotti di aggregazione contenuti e confronto prezzi che raccolgono e puliscono di continuo dati su prodotti e notizie e sono sensibili al rumore pubblicitario.
- Team tecnici di finanza o pubblica amministrazione che richiedono deployment privato e residenza dei dati senza rinunciare alla ricerca live.
Limiti e avvertenze
- Tutte le cifre sulle prestazioni provengono dal fornitore. Latenza media sotto il secondo, quaranta per cento più veloce del mercato, tasso di errore sotto lo 0,01 per cento e prezzo a un terzo non hanno riferimento indipendente, e né il corpus di test né il tipo di pagine sono dichiarati. Misura sui tuoi siti obiettivo.
- La trasparenza sui prezzi è limitata. Oltre alle 500 chiamate, il materiale pubblico non indica prezzo unitario, tetto di concorrenza, politica di limitazione né se i tentativi falliti vengono addebitati.
- Mancano dettagli sulla conformità. Estrazione e ricerca toccano contenuti di terzi, quindi limiti di diritto d'autore, gestione delle regole per i robot e conservazione del materiale scaricato richiedono conferma scritta, soprattutto se prevedi di ridistribuire ciò che ottieni.
- La qualità multilingue non è dichiarata. Il fornitore insiste sulla precisione su pagine cinesi complesse, vantaggio per i siti cinesi che non dice nulla sulle altre lingue.
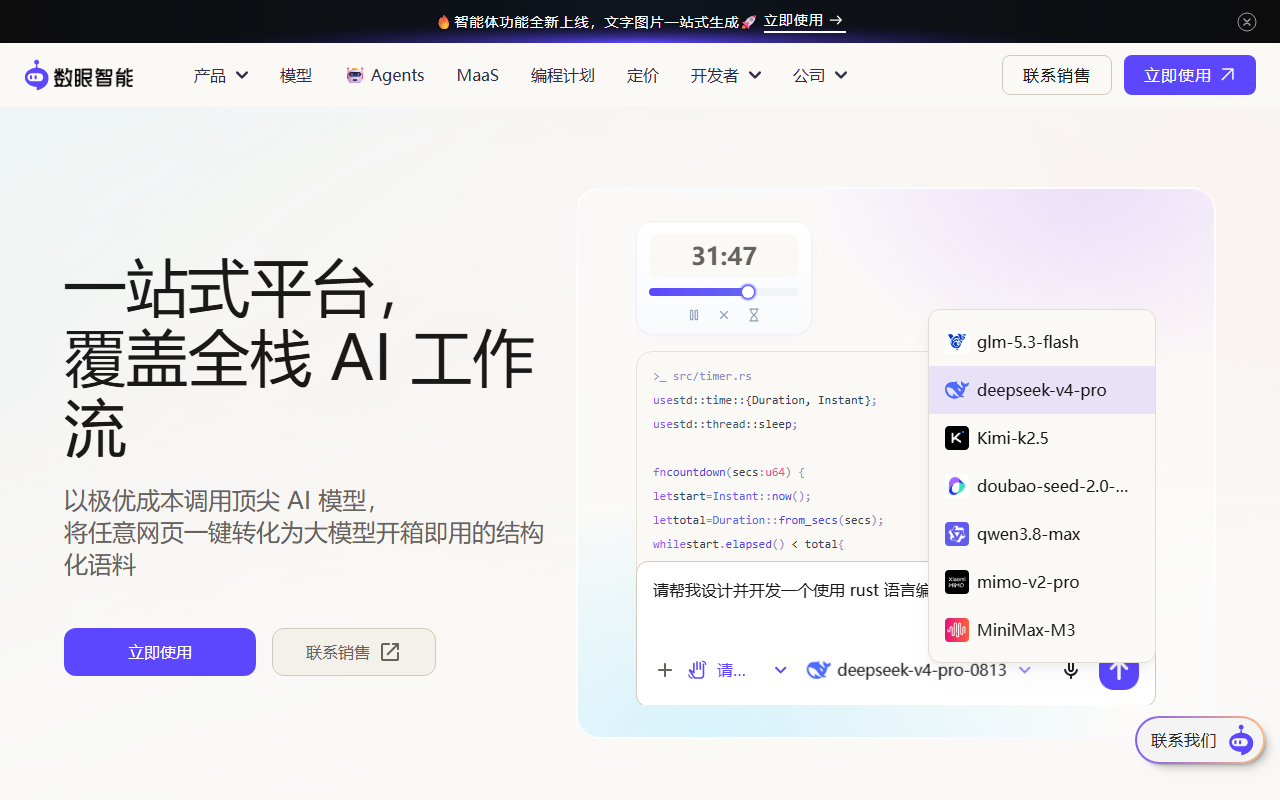
- L'unico asset multimediale confermabile è una schermata ufficiale con ancora segnaposto, quindi questo articolo non contiene immagini. Verifica interfaccia ed esempi di output nella console.
Domande frequenti
Shuyan AI è un modello?
No. È uno strato di dati e aggregazione. Non addestra modelli di base: vende endpoint di estrazione, ricerca e OCR, più un marketplace che instrada verso modelli di terzi. Il modello sottostante lo scegli tu.
Che vantaggio c'è rispetto a un crawler fatto in casa?
Soprattutto il costo di manutenzione. Un crawler proprio deve gestire rendering dinamico, difese anti-bot, selettori che scadono e pulizia del testo, e un solo restyling può rompere tutto. Un'API gestita sposta quel carico sul fornitore al prezzo del costo unitario e del controllo: l'influenza sulle regole di estrazione si riduce, e questo pesa sulle pagine atipiche.
Si collega direttamente alle piattaforme per agenti?
Il fornitore dichiara il supporto a due piattaforme note e la configurazione nei flussi degli agenti. Verifica nomi dei plugin e passaggi nell'elenco reale di ciascuna piattaforma: questo articolo non li certifica.
Cosa succede dopo la quota gratuita?
Le regole di liquidazione e il prezzo unitario oltre la fascia gratuita non sono pubblici. Completa la validazione entro le 500 chiamate, poi chiedi un preventivo confermando che l'addebito sia solo a successo, così il modello di costo non si scosta.
Domande frequenti
Shuyan AI è un modello?
No. È uno strato di dati e aggregazione. Non addestra modelli di base: vende endpoint di estrazione, ricerca e OCR, più un marketplace che instrada verso modelli di terzi. Il modello sottostante lo scegli tu.
Che vantaggio c'è rispetto a un crawler fatto in casa?
Soprattutto il costo di manutenzione. Un crawler proprio deve gestire rendering dinamico, difese anti-bot, selettori che scadono e pulizia del testo, e un solo restyling può rompere tutto. Un'API gestita sposta quel carico sul fornitore al prezzo del costo unitario e del controllo: l'influenza sulle regole di estrazione si riduce, e questo pesa sulle pagine atipiche.
Si collega direttamente alle piattaforme per agenti?
Il fornitore dichiara il supporto a due piattaforme note e la configurazione nei flussi degli agenti. Verifica nomi dei plugin e passaggi nell'elenco reale di ciascuna piattaforma: questo articolo non li certifica.
Cosa succede dopo la quota gratuita?
Le regole di liquidazione e il prezzo unitario oltre la fascia gratuita non sono pubblici. Completa la validazione entro le 500 chiamate, poi chiedi un preventivo confermando che l'addebito sia solo a successo, così il modello di costo non si scosta.



