
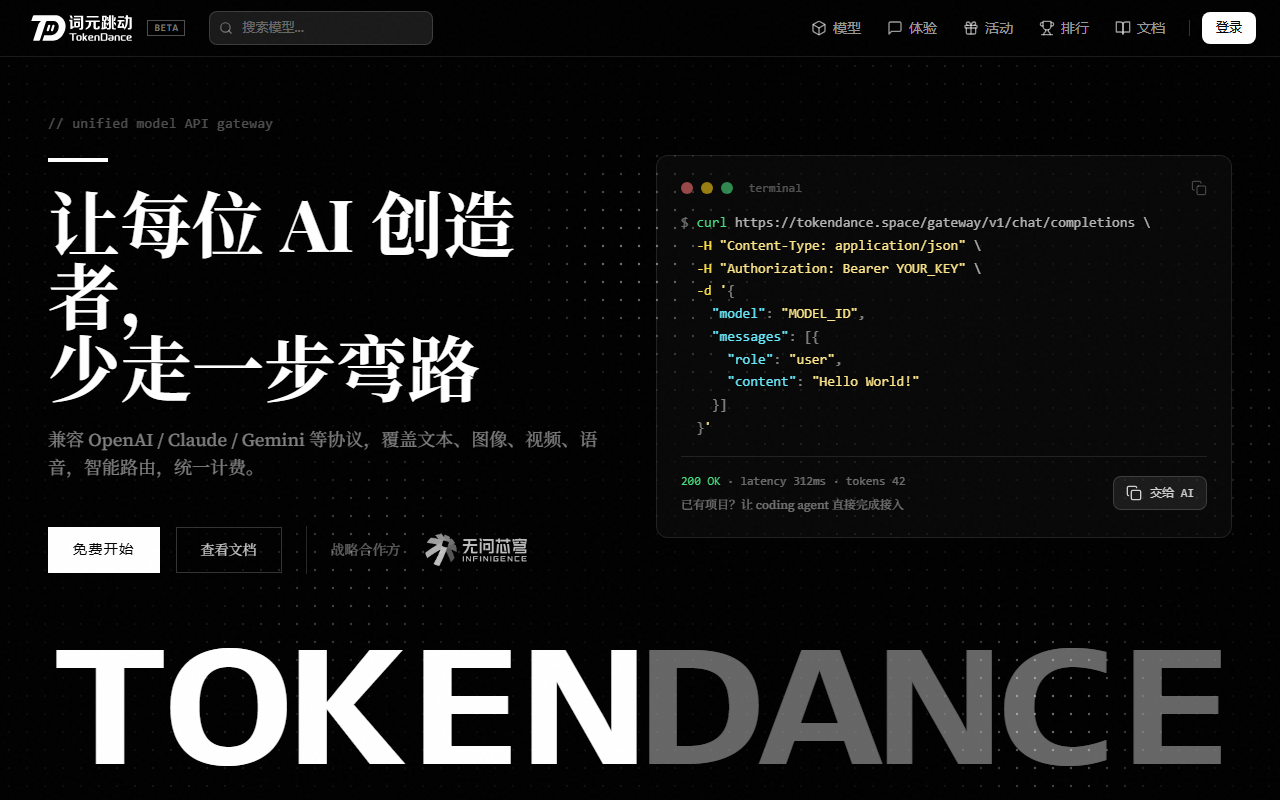
TokenDance è un gateway di aggregazione per API di modelli linguistici. Supporta nativamente i protocolli OpenAI, Claude e Gemini: si sostituisce la Base URL con l'indirizzo del gateway, si inseriscono chiave API e ID del modello, e le chiamate dell'SDK esistente raggiungono MiniMax, Qwen, Kimi, Zhipu, DeepSeek e altri modelli cinesi. Offre instradamento intelligente, fatturazione unificata e commutazione tra endpoint, senza modificare il codice applicativo.
TokenDance: un solo Base URL per diversi modelli linguistici cinesi
Chi costruisce un prodotto di IA attraversa la stessa fase: collega un fornitore per validare il flusso, poi un secondo e un terzo per qualità o costo. Presto il codice porta uno strato di adattamento, le chiavi si spargono tra console diverse, le fatture vivono in account separati e, quando un fornitore vacilla, qualcuno cambia endpoint a mano. TokenDance punta proprio a questo attrito: una Base URL davanti a più fornitori, con l'applicazione che vede un solo punto d'ingresso.
Il meccanismo non ha nulla di esotico. Espone tre forme di protocollo diffuse — OpenAI, Claude, Gemini — e instrada internamente per nome del modello verso l'endpoint corrispondente. Lo sviluppatore cambia configurazione, non codice, ed è ciò che rende credibile la promessa di migrazione nulla. In un progetto già basato sull'SDK OpenAI basta una riga di Base URL per provare un modello cinese, e il costo della sperimentazione crolla.
Il resto del valore sta nell'esercizio. Con più endpoint per lo stesso modello, il guasto di un fornitore attiva la commutazione automatica; una richiesta può anche elencare modelli candidati e degradare passo dopo passo se il principale non risponde. La fatturazione unificata raccoglie il consumo di token di tutti i fornitori in una sola fattura ed elimina ricariche e riconciliazioni separate. La fonte non dettaglia tariffe, limiti di richieste, impegni di servizio né conservazione dei dati: da verificare prima di integrare.
Funzioni principali
Compatibilità di protocollo
Il supporto nativo di OpenAI, Claude e Gemini rende sufficiente il cambio di Base URL e lascia intatto il codice applicativo. Nei progetti esistenti è l'aspetto più concreto: provare un modello nuovo non impone di rifare lo strato di chiamata.
Instradamento intelligente
Le richieste vanno per nome del modello all'endpoint corretto e i dettagli di orchestrazione restano nascosti dietro un'unica entrata. Chi chiama non deve memorizzare domini e stranezze dei parametri di ogni fornitore.
Fatturazione unificata
Il consumo di token viene conteggiato tra fornitori e fatturato in un solo punto, senza ricaricare cinque console. Quando si attribuiscono i costi, una fattura si spiega meglio di cinque.
Commutazione e degrado
Lo stesso modello può avere più endpoint con cambio automatico, e una richiesta può indicare modelli candidati per retrocedere in ordine. È il vantaggio più tangibile di un gateway rispetto all'integrazione diretta.
Copertura dei modelli
Sono collegati più di otto modelli cinesi di riferimento, tra cui MiniMax, Qwen, Kimi, Zhipu e DeepSeek, con aggiunte continue. La copertura riguarda i modelli cinesi principali, non un catalogo globale.
Avvio rapido
Registrazione e verifica passano dall'accesso in un clic di Watcha e gli SDK esistenti continuano a funzionare: l'integrazione richiede minuti. Quell'accesso lega l'account a un sistema specifico, condizione da accettare.
Programma di sostegno
Un modulo permette di chiedere un sostegno in token secondo la fase del prodotto. Utile ai progetti iniziali, anche se importo e criteri non sono pubblicati.
Primi passi
- Aprire il sito di TokenDance e registrarsi con l'accesso in un clic di Watcha per verificare l'account.
- Generare una chiave API personale nella console e custodirla come qualsiasi credenziale.
- Sostituire la Base URL del progetto con l'indirizzo del gateway https://tokendance.space/gateway/v1/.
- Indicare nella richiesta l'ID del modello desiderato, per esempio DeepSeek o Kimi.
- Inviare la richiesta con l'SDK OpenAI esistente o con curl e verificare che la risposta sia quella attesa.
- Se serve un grande volume di token, compilare il modulo del programma di sostegno secondo la fase del prodotto.
A chi serve
- Team emergenti che confrontano più modelli cinesi a basso costo tramite un gateway prima di scegliere.
- Prodotti che in produzione instradano per tipo di attività: ragionamento, scrittura, codice.
- Sistemi di agenti che richiedono uno strato di modelli ad alta disponibilità e degradabile.
- Istruzione, ricerca e sviluppatori indipendenti sensibili ai costi che sfruttano la fatturazione unificata.
Limiti
- Tariffe, quota gratuita, limiti di richieste e impegni di servizio non sono pubblicati; verificare con il fornitore prima di integrare.
- Gli account richiedono l'accesso in un clic di Watcha, quindi si accetta quel sistema; l'integrazione con l'identità aziendale non è descritta.
- Il gateway vede il contenuto delle richieste e la politica di conservazione o logging non è indicata: valutare la conformità per i dati sensibili.
- Il catalogo si concentra sui modelli cinesi principali; modelli globali o aperti di nicchia possono mancare.
- Un salto in più aggiunge latenza e un ulteriore punto di guasto. La commutazione aiuta, ma serve monitoraggio proprio.
- Importi, criteri e continuità del sostegno non sono pubblicati; non conviene basarvi un modello di costo a lungo termine.
Domande frequenti
Bisogna cambiare codice?
Non quello applicativo. Si sostituisce la Base URL con quella del gateway, si inseriscono chiave e modello e si continua a usare l'SDK OpenAI come prima.
Quali modelli sono disponibili?
La fonte cita più di otto modelli cinesi principali, tra cui MiniMax, Qwen, Kimi, Zhipu e DeepSeek, con ampliamenti continui. L'elenco definitivo è nella console.
Come funziona la commutazione?
Su due livelli: più endpoint per modello con cambio automatico, e modelli candidati per richiesta che degradano in ordine se il principale fallisce.
Che differenza c'è con la chiamata diretta ai fornitori?
L'integrazione diretta impone di gestire chiavi, ricariche, limiti e commutazione per ogni fornitore. Un gateway li centralizza in un'entrata e una fattura, al prezzo di un salto in più e della dipendenza dal gateway stesso.
Esiste un livello gratuito?
La fonte menziona solo un programma di sostegno richiesto secondo la fase del prodotto, senza quota gratuita ordinaria. Conviene chiedere al fornitore.
Domande frequenti
Bisogna cambiare codice?
Non quello applicativo. Si sostituisce la Base URL con quella del gateway, si inseriscono chiave e modello e si continua a usare l'SDK OpenAI come prima.
Quali modelli sono disponibili?
La fonte cita più di otto modelli cinesi principali, tra cui MiniMax, Qwen, Kimi, Zhipu e DeepSeek, con ampliamenti continui. L'elenco definitivo è nella console.
Come funziona la commutazione?
Su due livelli: più endpoint per modello con cambio automatico, e modelli candidati per richiesta che degradano in ordine se il principale fallisce.
Che differenza c'è con la chiamata diretta ai fornitori?
L'integrazione diretta impone di gestire chiavi, ricariche, limiti e commutazione per ogni fornitore. Un gateway li centralizza in un'entrata e una fattura, al prezzo di un salto in più e della dipendenza dal gateway stesso.



