

TokenPony è adatto a sviluppatori individuali, piccoli team, utenti aziendali e ricercatori che devono usare più modelli linguistici contemporaneamente, non vogliono costruire un server GPU proprio e desiderano accedervi tramite un'unica interfaccia.
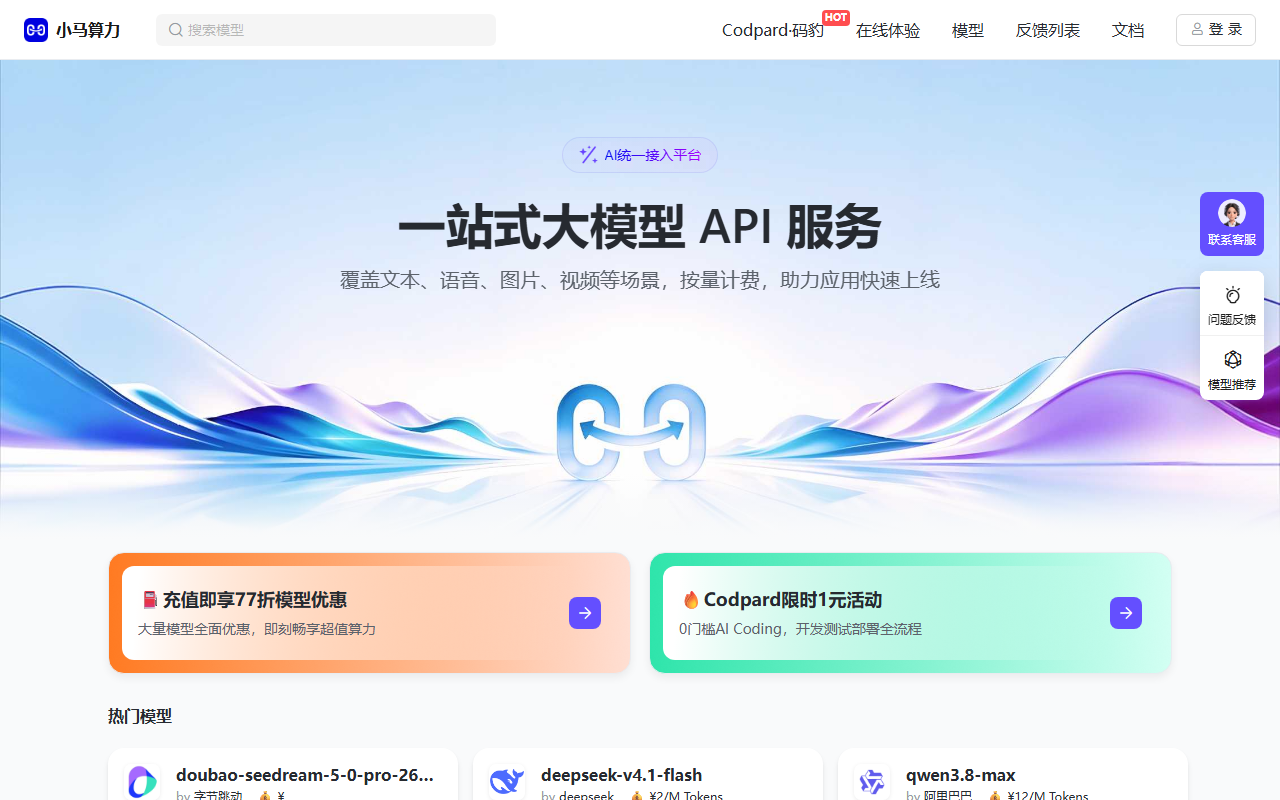
TokenPony: piattaforma di aggregazione API per modelli linguistici di grandi dimensioni con interfaccia unificata
TokenPony è una piattaforma di aggregazione API per modelli linguistici di grandi dimensioni, pensata per sviluppatori individuali e piccoli team. Il suo ruolo è paragonabile a quello di un livello di orchestrazione: DeepSeek, Kimi, Qwen, GLM e altri modelli di uso comune vengono riuniti sotto un'unica interfaccia, così l'utente non deve passare continuamente da una piattaforma all'altra. Per uno sviluppatore, il tempo ed energie non si consumano tanto per una singola chiamata a un modello, quanto per l'integrazione, l'autenticazione, la fatturazione e la manutenzione quando si usano più modelli insieme. La piattaforma riunisce questi aspetti in un unico punto e offre al contempo un contesto fino a 1024K token, adatto a documenti lunghi, conversazioni multi-turno e task complessi basati su agenti. Non è necessario costruire un server GPU proprio.
Funzioni principali
Accesso a tutti i modelli La piattaforma integra DeepSeek, Kimi, Qwen, GLM e altri modelli diffusi, eliminando la necessità di cambiare piattaforma e permettendo di richiamare liberamente modelli diversi all'interno dello stesso ambiente. Per le applicazioni che devono usare più modelli contemporaneamente, questo elimina il fastidio delle integrazioni ripetute.
Supporto al contesto molto esteso La piattaforma offre una gestione del contesto fino a 1024K token, utilizzabile per documenti lunghi, conversazioni multi-turno e task complessi con agenti. La lunghezza del contesto determina direttamente quanti materiali si possono inserire in una singola richiesta, ed è una condizione preliminare per gestire compiti su testi estesi.
Chiamata API con un clic Configurazione zero, nessun deploy: l'integrazione è subito attiva. Lo sviluppatore non deve occuparsi del rilascio del servizio né della configurazione dell'ambiente di esecuzione; una volta ottenuta la chiave può iniziare a effettuare chiamate.
Nessun server GPU necessario I modelli già addestrati si utilizzano chiamandone le API, senza dover costruire un server GPU proprio: si risparmia così il costo dell'hardware. Per sviluppatori individuali e piccoli team questo è spesso il punto decisivo.
Ottimizzazione dei costi Meccanismo di pricing trasparente, che permette di bilanciare prestazioni e costi. Il costo unitario delle chiamate varia in modo netto tra un modello e l'altro, quindi un prezzo chiaro aiuta a tenere sotto controllo la spesa complessiva.
Come si usa
- Registrazione e accesso: apri il prodotto e completala registrazione tramite il pulsante di accesso nell'angolo in alto a destra della pagina.
- Esplorazione dei modelli: entra nella pagina dei modelli per consultare l'elenco supportato e usa i filtri per trovare i dettagli di un modello specifico.
- Ricarica del saldo: scegli l'opzione di ricarica nei dati utente. Attualmente è disponibile il pagamento tramite WeChat Pay, con un importo minimo di ricarica di 10 yuan, destinato a coprire le successive chiamate ai modelli.
- Creazione della chiave API: nella pagina dei modelli seleziona il modello da configurare e crea per esso una chiave API.
- Chiamata dell'interfaccia: usa la chiave API appena creata per richiamare il modello desiderato tramite l'interfaccia della piattaforma e inizia lo sviluppo.
- Gestione del consumo: stima il numero di chiamate per il progetto e, considerando la diversa tariffazione dei modelli, scegli quello più adatto per evitare sprechi.
Per chi è adatto
- Sviluppatori individuali: per chi desidera integrare rapidamente più modelli linguistici, semplificare il flusso di sviluppo e ridurne i costi
- Piccoli team: che devono sfruttare al meglio risorse limitate e costruire e rilasciare rapidamente applicazioni basate su modelli linguistici
- Creativi: come autori di testi e content creator, che usano l'AI per aumentare efficienza e qualità del lavoro
- Utenti aziendali: che vogliono integrare capacità AI nei propri processi senza investire ingenti risorse nell'auto costruzione di modelli e infrastruttura
- Ricercatori: che necessitano di richiamare modelli diversi in modo flessibile per studi ed esperimenti ed esplorare nuovi scenari applicativi dell'AI
- Studenti e docenti: per apprendimento e didattica, e per esplorare le applicazioni dell'AI nell'ambito educativo
Limitazioni e avvertenze
- Le capacità e i parametri dei modelli dipendono dalle versioni effettivamente disponibili sulla piattaforma: modelli diversi differiscono per qualità dell'output, velocità e limiti di contesto.
- L'interfaccia aggregata non migliora la qualità dell'output del modello stesso: per le attività importanti, l'accuratezza resta da valutare e verificare autonomamente.
- Le chiamate sono tariffate a consumo: contesti lunghi e frequenze elevate di chiamata aumentano in modo significativo i costi, quindi è necessario stimare in base all'uso reale.
- La chiave API è una credenziale: conservala con cura ed evita di esporla o di caricarla in repository di codice pubblici.
- È necessaria la connessione a Internet e la dipendenza dalla disponibilità del servizio: modifiche o interruzioni possono influire sulla catena di chiamata.
- Condizioni di ricarica e metodi di pagamento, prezzi e promozioni fanno riferimento alle pagine effettive della piattaforma: verifica le regole vigenti prima dell'uso.
Domande frequenti
Quale problema risolve TokenPony?
TokenPony riunisce DeepSeek, Kimi, Qwen, GLM e altri modelli linguistici di uso comune sotto un'unica interfaccia, evitando il passaggio tra piattaforme e le integrazioni ripetute. Offre inoltre un contesto fino a 1024K token per documenti lunghi, conversazioni multi-turno e task complessi con agenti, e non richiede un server GPU proprio, riducendo il costo dell'hardware.
Come si richiama un modello con TokenPony?
Il flusso è questo: registrarsi e accedere, consultare la pagina dei modelli per l'elenco supportato, ricaricare il saldo nei dati utente, scegliere il modello desiderato nella pagina dei modelli e creare per esso una chiave API, quindi usare la chiave per le chiamate tramite l'interfaccia della piattaforma. Per la ricarica è attualmente disponibile il pagamento tramite WeChat Pay con un importo minimo di 10 yuan.
A cosa fare attenzione usando un aggregatore API di modelli?
Ci sono alcuni aspetti: i modelli differiscono per qualità dell'output, velocità e limiti di contesto, e l'interfaccia aggregata non migliora la qualità del singolo modello; le chiamate sono tariffate a consumo, quindi contesti lunghi e frequenze elevate fanno salire i costi; la chiave API è una credenziale e non deve essere resa pubblica in repository aperti. Servono inoltre connessione a Internet e disponibilità del servizio, mentre prezzi e condizioni vanno verificati sulle pagine ufficiali della piattaforma.



