
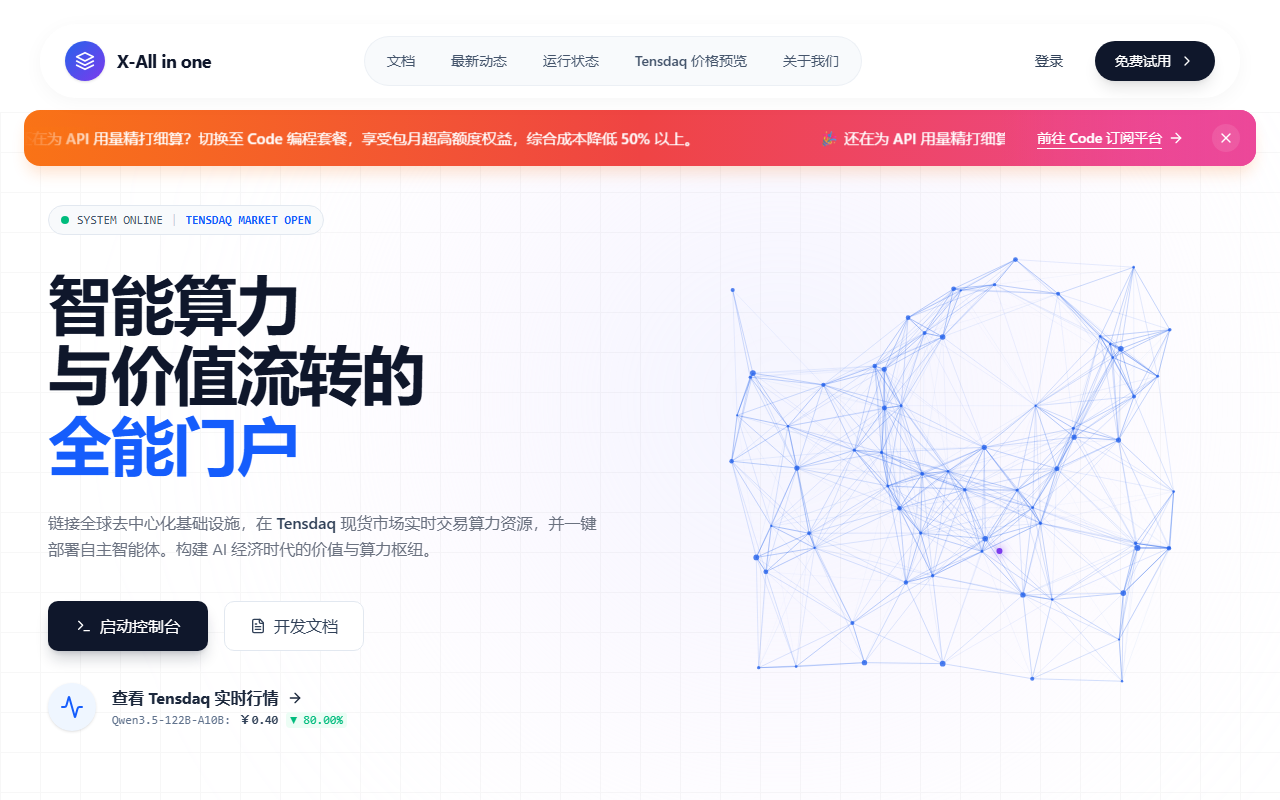
X-All in one è una piattaforma API IA sviluppata internamente. Permette di chiamare più modelli da un’unica interfaccia e di usare Tensdaq, dove si fissa il prezzo massimo per milione di token.
Che cos’è X-All in one
X-All in one è una piattaforma API IA sviluppata internamente che riunisce in un unico servizio l’accesso ai modelli, la pianificazione della computazione e la gestione della fatturazione. Secondo il materiale ufficiale, l’infrastruttura si appoggia alla capacità di calcolo di livello nazionale dei tre principali operatori di telecomunicazioni, e sia la pianificazione delle risorse sia il livello di erogazione dell’API sono realizzati in casa, il che consente una scalabilità elastica e una distribuzione tra regioni in base alla domanda.
Per chi la usa contano due aspetti: chiamare più modelli da un’unica interfaccia e impiegare Tensdaq, un meccanismo di offerte con cui stabilire da sé il prezzo dell’inferenza. I numeri ufficiali parlano di un tempo di risposta del primo pacchetto inferiore del 30 % alla media del settore, di prezzi intorno all’80 % della media di mercato e di un costo effettivo d’uso più basso di oltre il 20 %. Si tratta di dati forniti dal produttore e i risultati reali variano a seconda del modello, della fascia oraria e della regione: conviene quindi provare con un piccolo lotto di richieste.
Funzionalità principali
Tensdaq, MaaS IA a offerte: il nome unisce Tensor e Nasdaq. Invece di un prezzo fisso per token, l’utente indica il massimo che è disposto a pagare per milione di token. La piattaforma usa questo dato per livellare la domanda: i lavori pesanti che non richiedono risposta immediata possono essere spostati nelle ore più economiche.
Motore di pianificazione proprietario: uno scheduler distribuito sviluppato in casa assegna le risorse sotto alta concorrenza e riduce le probabilità di interruzione del servizio.
API ad alte prestazioni: pensata per contenere la latenza del primo pacchetto, punta agli usi sensibili al ritardo come la conversazione in tempo reale e l’output in streaming.
Console unica per sviluppatori: un’interfaccia visiva con monitoraggio delle richieste e analisi dei consumi, dove volume, numero di chiamate e costo si leggono nello stesso punto.
Gestione unificata di più modelli: in uno stesso progetto si possono mescolare modelli diversi senza mantenere credenziali e codice di integrazione separati per ogni fornitore.
Sistema di sicurezza: il produttore descrive cifratura di trasporto TLS e RSA, inferenza cifrata per fasi e gestione dei permessi per isolare le risorse.
Come iniziare
- Registrazione e credito: vai su https://www.x-aio.com/ e registrati; la documentazione ufficiale indica che vengono assegnati automaticamente 20 yuan di credito iniziale, usabili sull’API a offerte.
- Ottenere la chiave API: accedi alla console, crea e copia la tua chiave.
- Integrazione: configura la chiave nell’agente o nell’applicazione e chiama l’API standard.
- Attivare le offerte: apri la pagina Tensdaq, consulta l’elenco dei modelli che accettano offerte, leggi le condizioni e attiva la funzione.
- Impostare l’offerta: individua il modello desiderato in Tensdaq e inserisci il massimo che pagherai per milione di token. L’offerta si calcola sul prezzo di input; il prezzo di output segue un moltiplicatore fisso legato al tipo di modello.
- Attendere l’applicazione e controllare: il prezzo si applica dopo ogni ora esatta. La vista di dettaglio mostra fino a 24 ore di variazioni, con la media oraria e i valori di picco e minimo.
- Chiamate e monitoraggio: scegli l’endpoint Tensdaq quando chiami l’API e segui nella console consumi e metriche di prestazione, regolando offerta e configurazione se serve.
Lo stesso produttore consiglia di partire con un’offerta del 10-15 % sopra la media di mercato per garantire la stabilità, per poi ridurla gradualmente.
Casi d’uso
Sviluppo di agenti: le catene di ragionamento complesse comportano molte chiamate in sequenza e sono sensibili sia alla latenza sia alla concorrenza. Un endpoint unificato e la computazione elastica aiutano a mantenere stabile la velocità di risposta nei picchi di traffico.
Integrazione IA in azienda: sistemi di assistenza, piattaforme di generazione contenuti e assistenti di analisi dati usano spesso più modelli insieme per bilanciare qualità e costo; la gestione unificata e l’analisi dei consumi alleggeriscono questo lavoro ingegneristico.
Sviluppatori singoli e ricerca: il pagamento a consumo unito alle offerte consente di validare idee con budget ridotti e senza grandi investimenti iniziali, in progetti personali, team giovani o lavori accademici.
Limiti e cautele
I dati di prestazioni e costi pubblicati (primo pacchetto più veloce del 30 %, prezzi all’80 % della media, risparmio oltre il 20 %, tempo medio di risoluzione dei problemi sotto le due ore, team centrale con più di sei anni di esperienza media nel settore) sono dichiarazioni del produttore, prive di misurazioni indipendenti di terze parti: meglio quindi decidere in base alle proprie prove.
Le offerte scambiano la prevedibilità con il prezzo: che l’offerta venga accettata dipende da domanda e offerta in quel momento e il prezzo può cambiare ogni ora, quindi non è adatta a percorsi di produzione con impegni rigidi su latenza o disponibilità. Se il servizio richiede garanzie ferme, valuta prima la via a prezzo fisso o prepara un piano alternativo.
Importo, ambito e validità del credito di registrazione seguono quanto indicato dal sito ufficiale; anche l’elenco dei modelli, i linguaggi con SDK e la disponibilità regionale possono cambiare, perciò prima di integrare verifica lo stato attuale sul sito ufficiale e nella documentazione dell’API. La cifratura del trasporto e dell’inferenza riduce l’esposizione, ma i dati sensibili richiedono una verifica di conformità autonoma.
Domande frequenti
A chi è adatta X-All in one? A sviluppatori e aziende che gestiscono più modelli da un’unica interfaccia e tengono d’occhio il costo dell’inferenza, in particolare per agenti, assistenza clienti e generazione di contenuti.
Come funziona il sistema di offerte di Tensdaq? L’utente fissa un prezzo massimo per milione di token; il prezzo si applica a ogni ora esatta e la piattaforma bilancia domanda e offerta. L’output è fatturato con un moltiplicatore fisso in base al tipo di modello. Si consiglia di partire con un’offerta del 10-15 % sopra la media di mercato.
C’è un credito gratuito per i nuovi utenti? Secondo la documentazione ufficiale, dopo la registrazione vengono assegnati automaticamente 20 yuan di credito iniziale, utilizzabili sull’API a offerte. Ambito e validità seguono le regole pubblicate sul sito ufficiale.
Domande frequenti
A chi è adatta X-All in one?
A sviluppatori e aziende che gestiscono più modelli da un’unica interfaccia e tengono d’occhio il costo dell’inferenza, in particolare per agenti, assistenza clienti e generazione di contenuti.
Come funziona il sistema di offerte di Tensdaq?
L’utente fissa un prezzo massimo per milione di token; il prezzo si applica a ogni ora esatta e la piattaforma bilancia domanda e offerta. L’output è fatturato con un moltiplicatore fisso in base al tipo di modello. Si consiglia di partire con un’offerta del 10-15 % sopra la media di mercato.
C’è un credito gratuito per i nuovi utenti?
Secondo la documentazione ufficiale, dopo la registrazione vengono assegnati automaticamente 20 yuan di credito iniziale, utilizzabili sull’API a offerte. Ambito e validità seguono le regole pubblicate sul sito ufficiale.



