

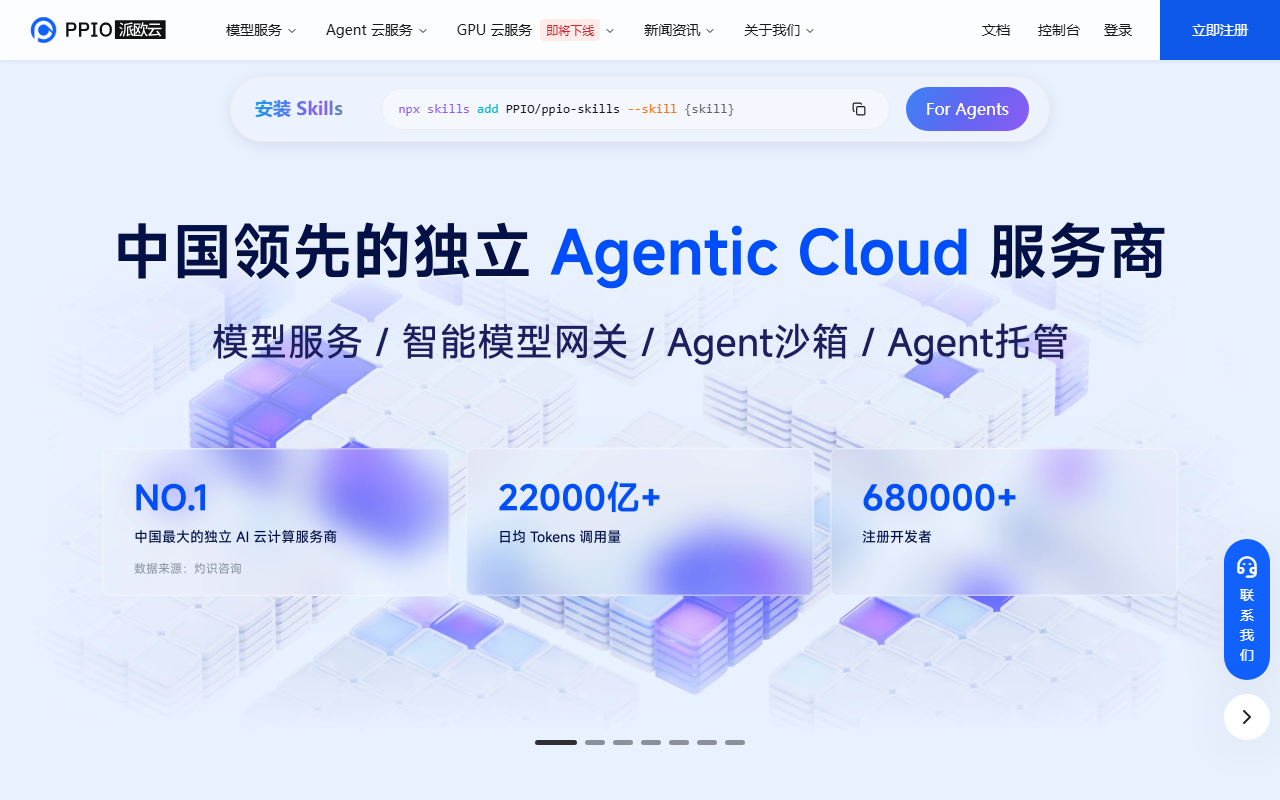
PPIO Paiouyun to rozproszona platforma chmurowa, która grupuje rozproszone zasoby GPU w jedną sieć obliczeniową: funkcje generatywnej AI można wdrażać przez API zgodne z OpenAI lub instancje GPU na żądanie, a firmy mogą wybrać dedykowany klaster prywatny.
Czym jest PPIO Paiouyun
PPIO Paiouyun to dostawca rozproszonej chmury obliczeniowej, który łączy moc profesjonalnych serwerów działających na skraju sieci oraz w regionalnych centrach danych w jedną sieć obliczeniową. Firma łączy model gospodarki współdzielenia z technologiami big data, cloud native i obliczeń rozproszonych, a następnie udostępnia tę moc jako API wnioskowania AI, instancje GPU oraz rozwiązania branżowe. Główne obszary to chmura wnioskowania AI, rozwiązania audio i wideo, renderowanie w chmurze dla metawersum oraz wdrożenia prywatne dla firm. Oficjalna strona produktu to ppio.cn.
W odróżnieniu od klasycznej chmury publicznej, która sprzedaje przede wszystkim maszyny wirtualne z własnych centrów danych, PPIO pozycjonuje się jako agregator i scheduler mocy obliczeniowej. Z jednej strony gromadzi zasoby heterogeniczne — centra danych w skali hyperscale, regionalne węzły obliczeniowe i nieużywane urządzenia. Z drugiej udostępnia je przez jedną konsolę, wspólne API i własny silnik przyspieszania wnioskowania. Platforma oferuje też nowsze modele, takie jak DeepSeek-R1-0528, które można wywoływać przez API lub testować bezpośrednio w katalogu modeli.
Najważniejsze możliwości
Usługa API modeli
Platforma udostępnia API dużych modeli językowych oraz API generowania obrazów i wideo. Punkty końcowe są zgodne ze standardem OpenAI API, więc w większości projektów migracja sprowadza się do zmiany bazowego adresu URL, klucza i nazwy modelu, a istniejący kod OpenAI SDK działa dalej. PPIO deklaruje stabilność do 99,9% i obsługuje przełączanie między modelami multimodalnymi w kilka sekund wraz z przyspieszaniem wnioskowania, co pomaga zespołom porównującym kilka modeli lub łączącym tekst i obraz w jednym produkcie.
Chmura GPU
Moc GPU jest dostarczana w dwóch formach. Instancje kontenerowe GPU dają skonteneryzowane zasoby GPU z rozliczeniem za użycie, gotowymi obrazami i wdrożeniem jednym kliknięciem; sprawdzają się w treningu, dostrajaniu i wnioskowaniu wsadowym, gdy środowiskiem zarządzasz sam. Serverless GPU są przeznaczone dla modeli własnych bez utrzymywania infrastruktury, z automatycznym skalowaniem, równoważeniem obciążenia i zimnym startem w kilka sekund, odpowiednie dla wnioskowania online o zmiennym ruchu.
Rozwiązania audio i wideo
Opierając się na szeroko rozproszonych węzłach brzegowych i doświadczeniu w branży mediów, ta linia łączy sprzęt, sieć i technologie mediów, dostarczając kompleksowe rozwiązanie dla długiego i krótkiego wideo na żądanie, streamingu rozrywkowego, rozmów wideo i transmisji interaktywnych. Obietnica to wysoka jakość, niski koszt i stabilna dostawa.
Renderowanie w chmurze i metawersum
Dzięki otwartemu, profesjonalnemu oprogramowaniu graficznemu uruchamianemu na obliczeniach brzegowych platforma oferuje automatyczne wdrożenia renderowania w chmurze dla aplikacji typu metawersum, które muszą renderować zasoby lub klatki zdalnie.
Wdrożenia prywatne dla firm
Dla organizacji, które nie mogą wysyłać danych do współdzielonej chmury, przewidziano dedykowany klaster GPU z w pełni zarządzaną eksploatacją: stos serwowania modeli pozostaje w środowisku kontrolowanym przez firmę, a codzienna eksploatacja u dostawcy.
Jak zacząć
- Załóż konto na oficjalnej stronie, używając numeru telefonu lub nazwy konta.
- Zweryfikuj tożsamość — weryfikacja osobista lub firmowa jest wymagana przed włączeniem obliczeń i API.
- Doładuj saldo na stronie przeglądu konta; obsługiwane są Alipay, WeChat Pay i przelew firmowy.
- Utwórz klucz API w panelu zarządzania kluczami, jeśli zamierzasz korzystać z API, i nie umieszczaj go w kodzie frontendu ani publicznych repozytoriach.
- Wywołaj model: otwórz katalog modeli, wybierz kartę i użyj panelu testowego z własnymi parametrami. Do integracji skieruj klienta zgodnego z OpenAI na punkt końcowy platformy z kluczem i nazwą modelu; kod w Pythonie zwykle działa bez zmian.
- Uruchom GPU: utwórz instancje kontenerowe lub wdrożenia serverless w konsoli, wybierając specyfikację, obraz lub model oraz zasady skalowania.
Gdzie się sprawdza
- Wdrażanie produktów generatywnej AI: czat, pisanie, generowanie obrazów i wideo bez własnego klastra wnioskowania.
- Wideo i transmisje: transkodowanie i dystrybucja dla wideo na żądanie, rozrywki i streamingu interaktywnego.
- Renderowanie wsadowe: film, wizualizacja architektoniczna, sceny metawersum.
- Elastyczna moc: skoki ruchu lub okresowe zadania treningowe rozliczane za użycie.
- Pojazdy autonomiczne i badania: zadania wymagające niskich opóźnień, szerokiego pasma lub masowego przetwarzania równoległego.
Ograniczenia i na co uważać
- Wartości takie jak 99,9% stabilności, zimny start w kilka sekund i natychmiastowa zmiana modelu to deklaracje dostawcy. Nie zostały tu zmierzone niezależnie, więc przetestuj je na własnym ruchu przed decyzją.
- Rozliczenia łączą przedpłatę i opłatę za użycie, a weryfikacja tożsamości jest obowiązkowa. Ceny jednostkowe, darmowe limity i rabaty pochodzą z konsoli i od zespołu sprzedaży; w artykule nie podajemy cennika.
- Katalog modeli się zmienia. Dostępność DeepSeek-R1-0528 i innych modeli sprawdź w katalogu w momencie użycia.
- Rozwiązania audio/wideo i wdrożenia prywatne to projekty B2B wymagające negocjacji handlowych, a nie natychmiastowa samoobsługa.
- Klucze API są wrażliwe: wyciek może generować realne koszty, dlatego rozdzielaj je na projekty i regularnie rotuj.
Częste pytania
Czym różni się to od GPU w zwykłej chmurze publicznej? Zwykła chmura publiczna sprzedaje głównie instancje z własnych centrów danych. PPIO agreguje heterogeniczne moce brzegowe i regionalne i udostępnia je przez jedno API i warstwę schedulingu: w tej samej konsoli są GPU za użycie, wdrożenia serverless i API zgodne z OpenAI. To pasuje zespołom, które dziś chcą zarządzanego API, a jutro może własnego stosu wnioskowania.
Ile pracy wymaga migracja projektu korzystającego z OpenAI SDK? Zwykle zmieniają się trzy ustawienia: bazowy URL, klucz API i nazwa modelu. Logika biznesowa zostaje bez zmian. Przed przełączeniem ruchu wykonaj regresję na środowisku testowym obejmującą streaming i wywołania narzędzi.
Czy do małego testu potrzebna jest instancja GPU? Nie. Najpierw sprawdź model w katalogu, a potem wywołuj API za użycie — to taniej niż stale włączona instancja. Na GPU lub serverless przejdź, gdy potrzebujesz własnych modeli, nietypowych zależności lub przewidywalnych opóźnień.
Czy firma może trzymać dane we własnym środowisku? Tak, dzięki dedykowanemu klastrowi GPU i w pełni zarządzanemu wdrożeniu prywatnemu. Rozmiar klastra, izolacja sieci i terminy są uzgadniane z zespołem sprzedaży.

Najczęściej zadawane pytania
Czym różni się to od GPU w zwykłej chmurze publicznej?
Chmura publiczna sprzedaje własne instancje. PPIO agreguje heterogeniczne moce brzegowe i regionalne i udostępnia je przez jedno API i warstwę schedulingu: GPU za użycie, serverless i API zgodne z OpenAI w jednej konsoli.
Ile pracy wymaga migracja projektu z OpenAI SDK?
Zmieniają się bazowy URL, klucz i nazwa modelu; logika biznesowa zostaje. Przed przełączeniem ruchu wykonaj regresję obejmującą streaming i wywołania narzędzi.
Czy do małego testu potrzebna jest instancja GPU?
Nie. Najpierw katalog modeli, potem API za użycie — taniej niż stała instancja. GPU lub serverless wybierz dla własnych modeli i przewidywalnych opóźnień.
Czy firma może trzymać dane u siebie?
Tak, przez dedykowany klaster GPU i w pełni zarządzane wdrożenie prywatne; rozmiar, izolacja sieci i terminy są uzgadniane ze sprzedażą.



