

Shuyan AI to dostawca API dla zespołów, których model nie widzi otwartej sieci. Udostępnia trzy interfejsy: parsowanie stron, które przyjmuje adres i zwraca ustrukturyzowany Markdown lub JSON, wyszukiwanie na żywo obejmujące źródła newsowe, encyklopedyczne i naukowe oraz OCR zamieniający pliki PDF i skany w tekst z zachowaną hierarchią. Platforma modeli dodaje zagregowane wywołania modeli zewnętrznych i integrację przez standardowy protokół. Nowe konta otrzymują 500 darmowych wywołań, API działa w modelu REST, dostępne jest wdrożenie prywatne. Liczby dotyczące opóźnień i ceny pochodzą od dostawcy.
Shuyan AI: API do parsowania stron, wyszukiwania na żywo i OCR dokumentów
Kto buduje agentów, prędzej czy później trafia na tę samą ścianę: model jest wystarczająco bystry, ale nie widzi strony, którą ma przeczytać. Albo wiedza kończy się na dacie treningu, albo HTML przychodzi zasypany menu i reklamami, albo decydujący dokument istnieje tylko jako zeskanowany plik PDF. Dokładnie tę lukę zajmuje Shuyan AI. Firma nie trenuje modeli, sprzedaje rurociąg, który porządkuje świat zewnętrzny w formę przyswajalną dla modelu. O przydatności integracji decydują trzy pytania: czy wynik jest naprawdę czysty i ustrukturyzowany, czy rezultat wyszukiwania da się prześledzić do weryfikowalnego źródła i czy opóźnienie wytrzymuje potrzebną współbieżność.
Firma określa się jako infrastruktura danych epoki wielkich modeli i opisuje podejście jako dwumodalne, łączące wizję komputerową i kod. Jedna ścieżka interpretuje stronę tak, jak jest wyświetlana, druga wydobywa strukturę logiką kodu, a obie wzajemnie się kontrolują. To odpowiada na dwie klasyczne słabości zbierania danych: strony renderowane po stronie przeglądarki, których proste zapytanie sieciowe nigdy nie widzi, oraz kruche selektory psujące się przy pierwszej zmianie układu. Dostawca twierdzi, że jego indeks obejmuje ponad 300 dziedzin i setki milionów ustrukturyzowanych rekordów, odfiltrowując szum reklamowy.
Oferta dzieli się na trzy warstwy. Na dole trzy interfejsy danych: parsowanie, wyszukiwanie i OCR. Wyżej platforma modeli skupiająca wywołania kilku dostawców, agentów konwersacyjnych, tryb pogłębionego researchu i integrację z przepływami pracy. Z boku usługi zestawów danych i platforma analityczna. Większość zespołów użyje tylko dwóch lub trzech punktów dolnej warstwy; reszta to sąsiednie możliwości tego samego dostawcy i warto oceniać je osobno.
Jak działają kluczowe możliwości
Parsowanie stron: przywrócenie wyrenderowanej strony jako czytelnego tekstu
Wysyłasz docelowy adres i otrzymujesz ustrukturyzowany Markdown lub JSON. Wartość nie polega na samym pobraniu, lecz na tym, że nie trzeba potem pisać reguł czyszczenia: treść, hierarchia nagłówków i tabele są zachowywane tam, gdzie to możliwe, a reklamy i nawigacja odrzucane. W potoku wyszukiwania opartego na dokumentach ten krok wyznacza pułap jakości fragmentów, a ta jakość wyznacza pułap trafności. Brudne wejście daje fragmenty bliskie w przestrzeni wektorowej i bezużyteczne w praktyce. Deklarowane wsparcie dla stron renderowanych dynamicznie i złożonych układów to dokładnie to, co ścieżka wizualna wnosi wobec czystego analizatora struktury.
Wyszukiwanie na żywo: warstwa wyszukiwania z cytowalnymi źródłami
Punkt wyszukiwania jest zbudowany pod konsumpcję przez model i zwraca ocenione, ustrukturyzowane fragmenty, a nie surową listę odnośników. Deklarowane źródła obejmują newsy, encyklopedie, materiały naukowe i platformy medialne, aktualizowane na podstawie szerokiego indeksowania i własnego archiwum witryn. W aplikacjach badawczych różnica widoczna jest w szerokości odniesień: dostawca twierdzi, że tryb pogłębiony przegląda siedem razy więcej stron niż zwykłe wyszukiwanie, co oznacza dłuższy kontekst i więcej miejsca na weryfikację krzyżową.
OCR dokumentów: zachować hierarchię, nie tylko znaki
Wysyłasz plik PDF lub skan, a silnik wydobywa tekst, tabele i wzory w formie zachowującej strukturę dokumentu. Trudność nigdy nie leżała w rozpoznaniu pojedynczych znaków, ale w odtworzeniu organizacji: który wiersz jest nagłówkiem, która tabela rozciąga się na trzy strony, który symbol we wzorze jest indeksem dolnym. Hierarchia ma znaczenie dalej, bo baza wiedzy dzieli materiał po nagłówkach. Gdy struktura zniknie, pozostaje cięcie po stałej liczbie znaków, a ono przecina zdania i tabele.
Platforma modeli i standardowy protokół: wywołania i dane w jednej warstwie
Platforma grupuje kilku dostawców modeli za jednym punktem wejścia ze wspólnym rozliczaniem i formatami odpowiedzi, więc zespół nie utrzymuje wielu wdrożeń. Integracja przez standardowy protokół wstrzykuje wyszukiwanie i parsowanie do przepływów pracy przez wspólny interfejs, oszczędzając tym, którzy już go używają, przepisywania logiki wywołań narzędzi. Wspólna korzyść to konfiguracja w jednym miejscu: strona danych i strona modeli przestają być osobnymi integracjami z osobnymi awariami.
Jak zacząć
- Zarejestruj się na oficjalnej stronie i utwórz klucz API. Nowe konta mają 500 darmowych wywołań, co wystarcza, by sprawdzić trzy interfejsy przed wiązaniem budżetu.
- Sprawdź parsowanie na stronach, które naprawdę się liczą. Wybierz od dziesięciu do dwudziestu rzeczywistych adresów, w tym renderowanych dynamicznie, ze złożonymi tabelami i długimi tekstami dzielonymi na strony, i oceń, czy zwrócony Markdown zachowuje potrzebną strukturę. Nie sądź po stronie przykładowej dostawcy.
- Do OCR przygotuj najpierw próbki graniczne: układ dwukolumnowy, tabele przechodzące przez podział strony i skany ze wzorami. Błędy struktury skupiają się właśnie tam, a znalezienie ich przed wdrożeniem jest znacznie tańsze.
- Jeśli używasz gotowych platform agentowych, podłącz możliwość w przepływie pracy zamiast pisać backend. Przy integracji bezpośredniej wywołuj punkty REST i wybieraj Markdown, gdy wynik sprawdzi człowiek, oraz JSON, gdy przetworzy go program.
- Dla obciążeń publicznych i finansowych dostawca oferuje prywatne wdrożenie o wysokiej współbieżności, ale forma dostawy, termin i koszt nie są publikowane, więc potrzebna jest rozmowa handlowa.
Ceny i limity
- Jedyna opublikowana liczba to 500 darmowych wywołań na nowe konto. Wystarcza na sprawdzenie koncepcji i jest daleko od wolumenu produkcyjnego.
- Rozliczanie odbywa się po tokenach, a dostawca sytuuje cenę na około jednej trzeciej usług porównywalnych, pobierając opłatę wyłącznie za udane wywołania. Opłata tylko za sukces waży tu bardziej niż w zwykłym API tekstowym, bo błędy parsowania są z natury częstsze.
- Cena jednostkowa interfejsu, progi wolumenowe, wycena wdrożenia prywatnego i zasady rozliczeń po wyczerpaniu darmowego limitu nie są publikowane. Potwierdź je w konsoli lub u handlowca przed prognozą kosztów.
Dla kogo
- Programistów budujących agentów na gotowych platformach, którzy potrzebują czytania stron i wyszukiwania na żywo bez utrzymywania crawlerów i pul proxy.
- Zespołów wyszukiwania dokumentów i baz wiedzy, których materiały wewnętrzne tkwią w plikach PDF i skanach i muszą najpierw stać się tekstem z hierarchią, gotowym do dzielenia.
- Produktów agregujących treści i porównujących ceny, które stale pobierają i czyszczą dane o produktach i newsach oraz są wrażliwe na szum reklamowy.
- Zespołów technicznych w finansach i administracji, które wymagają wdrożenia prywatnego i pozostania danych w domenie, zachowując wyszukiwanie na żywo.
Ograniczenia i zastrzeżenia
- Wszystkie dane o wydajności pochodzą od dostawcy. Średnie opóźnienie poniżej sekundy, czterdzieści procent szybciej niż rynek, odsetek błędów poniżej 0,01 procent i cena na poziomie jednej trzeciej nie mają niezależnego odniesienia, a zbiór testowy i typy stron nie zostały podane. Mierz na własnych witrynach docelowych.
- Przejrzystość cen jest ograniczona. Poza 500 darmowymi wywołaniami materiały publiczne nie podają ceny jednostkowej, pułapu współbieżności, polityki limitowania ani tego, czy nieudane ponowienia są rozliczane.
- Brak szczegółów zgodności. Parsowanie i wyszukiwanie dotykają treści osób trzecich, więc granice prawa autorskiego, przestrzeganie reguł robotów i okres przechowywania pobranych treści wymagają pisemnego potwierdzenia, zwłaszcza przy redystrybucji.
- Jakość w innych językach nie jest zadeklarowana. Dostawca podkreśla dokładność na złożonych stronach chińskich, co jest zaletą dla witryn chińskich i nic nie mówi o pozostałych językach.
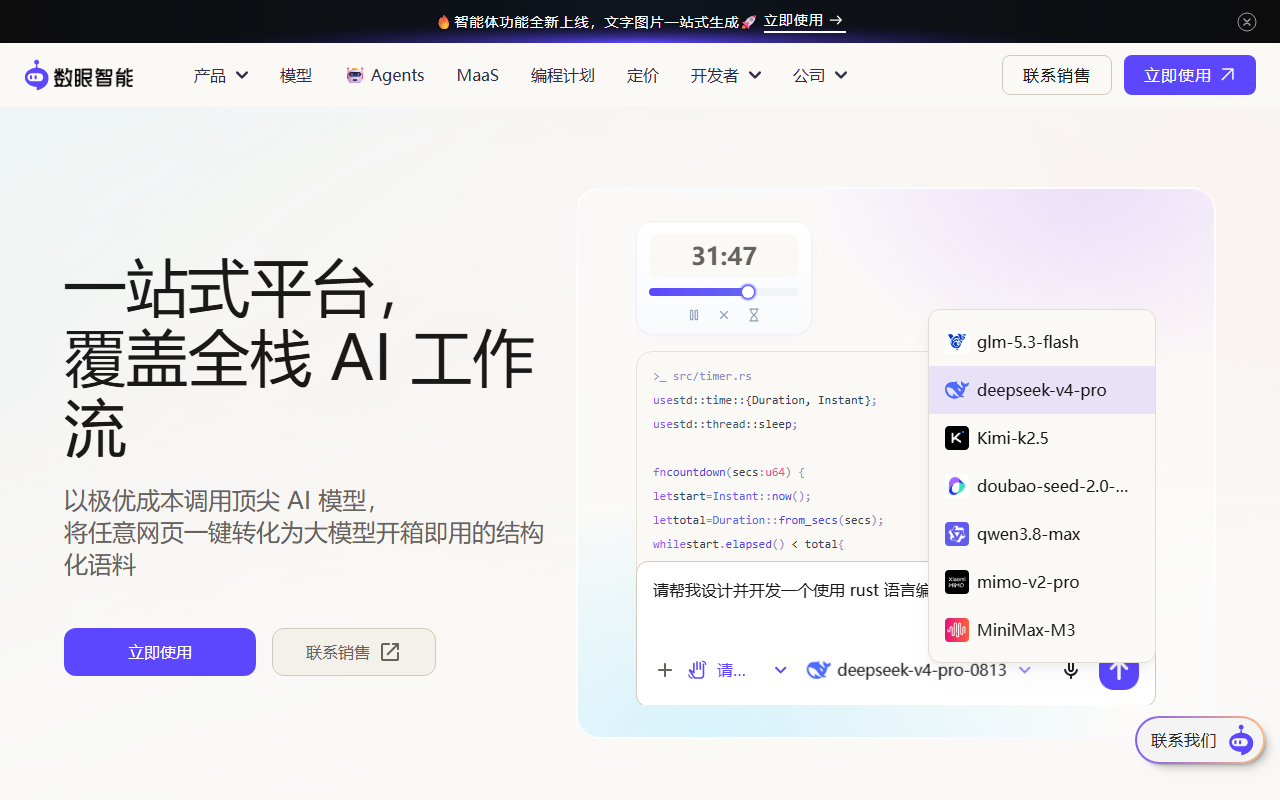
- Jedynym potwierdzalnym materiałem medialnym jest oficjalny zrzut ekranu z zastępczym odnośnikiem, dlatego artykuł nie zawiera obrazów. Interfejs i przykłady wyników sprawdź w konsoli.
Częste pytania
Czy Shuyan AI jest modelem?
Nie. To warstwa danych i agregacji. Firma nie trenuje modeli bazowych, sprzedaje punkty parsowania, wyszukiwania i OCR oraz platformę kierującą do modeli zewnętrznych. Model bazowy wybierasz sam.
Co daje przewagę nad własnym crawlerem?
Przede wszystkim koszt utrzymania. Własny crawler musi radzić sobie z dynamicznym renderowaniem, obroną przed botami, starzeniem się selektorów i czyszczeniem tekstu, a jeden redesign może zepsuć wszystko. Zarządzane API przenosi ten ciężar na dostawcę, kosztem ceny jednostkowej i kontroli: wpływ na reguły ekstrakcji maleje, co boli na nietypowych stronach.
Czy podłącza się bezpośrednio do gotowych platform agentowych?
Dostawca deklaruje wsparcie dwóch znanych platform i konfigurację w przepływie pracy agenta. Nazwy wtyczek i kroki sprawdź w aktualnej liście danej platformy, bo ten artykuł ich nie weryfikuje.
Co się dzieje po wyczerpaniu darmowego limitu?
Zasady rozliczeń i cena jednostkowa powyżej progu darmowego nie są publiczne. Zakończ testy w ramach 500 wywołań, potem poproś o wycenę i potwierdź, czy opłata dotyczy tylko sukcesu, aby model kosztów się nie rozjechał.
Najczęściej zadawane pytania
Czy Shuyan AI jest modelem?
Nie. To warstwa danych i agregacji. Firma nie trenuje modeli bazowych, sprzedaje punkty parsowania, wyszukiwania i OCR oraz platformę kierującą do modeli zewnętrznych. Model bazowy wybierasz sam.
Co daje przewagę nad własnym crawlerem?
Przede wszystkim koszt utrzymania. Własny crawler musi radzić sobie z dynamicznym renderowaniem, obroną przed botami, starzeniem się selektorów i czyszczeniem tekstu, a jeden redesign może zepsuć wszystko. Zarządzane API przenosi ten ciężar na dostawcę, kosztem ceny jednostkowej i kontroli: wpływ na reguły ekstrakcji maleje, co boli na nietypowych stronach.
Czy podłącza się bezpośrednio do gotowych platform agentowych?
Dostawca deklaruje wsparcie dwóch znanych platform i konfigurację w przepływie pracy agenta. Nazwy wtyczek i kroki sprawdź w aktualnej liście danej platformy, bo ten artykuł ich nie weryfikuje.
Co się dzieje po wyczerpaniu darmowego limitu?
Zasady rozliczeń i cena jednostkowa powyżej progu darmowego nie są publiczne. Zakończ testy w ramach 500 wywołań, potem poproś o wycenę i potwierdź, czy opłata dotyczy tylko sukcesu, aby model kosztów się nie rozjechał.



