

TokenPony sprawdzi się w przypadku indywidualnych deweloperów, małych zespołów, użytkowników biznesowych i badaczy, którzy chcą korzystać z kilku dużych modeli językowych jednocześnie, nie chcą budować własnego serwera GPU i szukają prostszego procesu integracji dzięki jednemu interfejsowi.
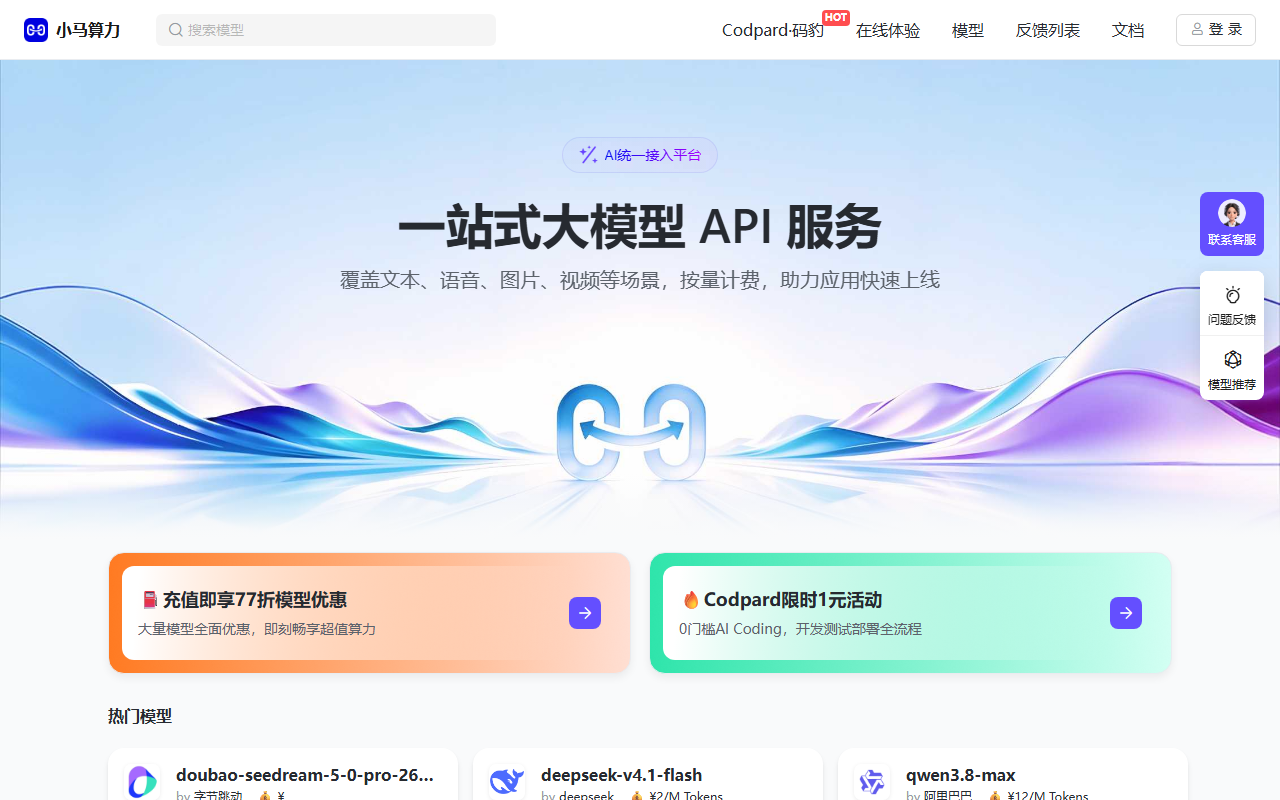
TokenPony: platforma agregująca API modeli AI z jednym interfejsem do wywoływania dużych modeli językowych
TokenPony to platforma agregująca API modeli AI, zaprojektowana z myślą o indywidualnych deweloperach i małych zespołach. Jej pozycję można porównać do warstwy orkiestracji: łączy wiele popularnych dużych modeli językowych, takich jak DeepSeek, Kimi, Qwen i GLM, w jeden interfejs, dzięki czemu użytkownik nie musi przeskakiwać między różnymi platformami. Dla deweloperów realnym kosztem jest zwykle nie „pojedyncze wywołanie modelu”, lecz koszt integracji, uwierzytelniania, rozliczeń i utrzymania, gdy w danej chwili używanych jest kilka modeli. Platforma zbiera te wszystkie kwestie w jednym miejscu, a jednocześnie udostępnia obsługę kontekstu 1024K do pracy z długimi dokumentami, rozmowami wielow turami oraz złożonymi zadaniami agentowymi, bez konieczności budowania własnego serwera GPU.
Główne funkcje
Dostęp do wszystkich modeli Integruje popularne duże modele językowe, takie jak DeepSeek, Kimi, Qwen i GLM, więc użytkownik nie musi zmieniać platformy i może swobodnie wywoływać różne modele w jednym miejscu. W przypadku aplikacji korzystających jednocześnie z kilku modeli oznacza to koniec z powtarzanym integrowaniem.
Obsługa kontekstu 1024K Zapewnia możliwość przetwarzania kontekstu o długości 1024K, co przydaje się przy długich dokumentach, rozmowach wielow turami i złożonych zadaniach agentowych. Długość kontekstu decyduje o tym, ile materiału zmieści się w jednym zapytaniu, i stanowi warunek wstępny pracy z długimi tekstami.
Wywołanie API jednym krokiem Bez konfiguracji i bez wdrażania — gotowe do użycia zaraz po podłączeniu. Deweloper nie musi zajmować się wdrożeniem usługi ani konfiguracją środowiska; wystarczy uzyskać klucz i od razu wykonywać wywołania.
Bez własnego serwera GPU Modele są używane poprzez wywołanie API gotowych modeli, więc nie trzeba budować własnego serwera GPU, a tym samym oszczędza się kosztów sprzętowych. Dla indywidualnych deweloperów i małych zespołów to zwykle najważniejszy punkt wyboru.
Optymalizacja kosztów Oferuje przejrzysty mechanizm wyceny, który ułatwia wyważenie wydajności i kosztów. Jednostkowy koszt wywołania różni się znacząco w zależności od modelu, a czytelne ceny pomagają utrzymać kontrolę nad wydatkami.
Kroki użycia
- Rejestracja i logowanie: otwórz stronę główną produktu i zarejestruj się przez wejście logowania w prawym górnym rogu strony.
- Przeglądanie modeli: przejdź do strony modeli, aby zobaczyć listę dostępnych modeli, i skorzystaj z filtrów, aby znaleźć szczegóły konkretnego modelu.
- Doładowanie: w sekcji „Informacje użytkownika” wybierz doładowanie konta. Obecnie obsługiwana jest płatność WeChat, a minimalna kwota doładowania wynosi 10 jednostek i służy do późniejszych wywołań modeli.
- Utworzenie klucza API: na stronie modeli wybierz model, który chcesz skonfigurować, i utwórz dla niego klucz API.
- Wywołanie interfejsu: użyj utworzonego klucza API, aby wywołać potrzebny model przez interfejs platformy i rozpocząć pracę deweloperską.
- Zarządzanie zużyciem: oszacuj liczbę wywołań dla projektu i wybierz odpowiedni model na podstawie cen, aby uniknąć niepotrzebnego zużycia.
Dla kogo jest ta platforma
- Indywidualni deweloperzy: osoby, które chcą szybko uzyskać dostęp do wielu dużych modeli językowych, uprościć proces rozwoju i obniżyć koszty pracy
- Małe zespoły: zespoły, które chcą sprawnie wykorzystywać ograniczone zasoby oraz szybko budować i wdrażać aplikacje oparte na dużych modelach językowych
- Twórcy treści: copywriterzy i twórcy treści, którzy chcą zwiększyć wydajność i jakość swojej pracy dzięki AI
- Użytkownicy biznesowi: firmy, które chcą wbudować możliwości AI w swoich procesach, ale nie chcą angażować dużych środków we własne modele i infrastrukturę
- Badacze: osoby, które potrzebują elastycznie korzystać z różnych modeli w badaniach i eksperymentach oraz odkrywać nowe zastosowania AI
- Studenci i nauczyciele: osoby wykorzystujące narzędzie do nauki i nauczania oraz poznawania zastosowań AI w edukacji
Ograniczenia i uwagi
- Możliwości i parametry modeli zależą od wersji faktycznie udostępnianej przez platformę; poszczególne modele różnią się jakością odpowiedzi, szybkością i limitami kontekstu.
- Interfejs agregujący nie zmienia jakości generowanych przez model odpowiedzi, dlatego dokładność w ważnych zadaniach nadal trzeba oceniać i weryfikować samodzielnie.
- Wywołania są rozliczane według zużycia; długi kontekst i częste wywołania istotnie zwiększają koszty, dlatego warto szacować je na podstawie rzeczywistego użycia.
- Klucz API jest poświadczeniem — należy go bezpiecznie przechowywać, nie ujawniać i nie umieszczać w publicznych repozytoriach kodu.
- Wymagane jest połączenie z internetem i dostępność platformy; zmiany w świadczeniu lub awarie mogą wpływać na łańcuch wywołań.
- Sposoby doładowania i płatności, ceny oraz promocje podlegają zasadom podanym na stronie platformy, dlatego przed rozpoczęciem korzystania warto sprawdzić aktualne warunki.
Najczęściej zadawane pytania
Jaki problem rozwiązuje TokenPony?
TokenPony łączy popularne duże modele językowe, takie jak DeepSeek, Kimi, Qwen i GLM, w jeden interfejs, dzięki czemu nie trzeba zmieniać platform ani powtarzać integracji. Platforma zapewnia też obsługę kontekstu 1024K, przydatną przy długich dokumentach, rozmowach wielow turami i złożonych zadaniach agentowych, a ponadto pozwala uniknąć budowania własnego serwera GPU i związanych z tym kosztów sprzętowych.
Jak wywoływać modele w TokenPony?
Przebieg jest następujący: zarejestruj się i zaloguj, przejdź do strony modeli, aby zobaczyć dostępne modele, wykonaj doładowanie konta w sekcji „Informacje użytkownika”, wybierz potrzebny model i utwórz klucz API na stronie modeli, a następnie użyj tego klucza do wywołania modelu przez interfejs platformy. Doładowanie jest obecnie realizowane przez płatność WeChat, a minimalna kwota wynosi 10 jednostek.
Na co zwrócić uwagę przy korzystaniu z platformy agregującej API?
Warto pamiętać o kilku kwestiach: poszczególne modele różnią się jakością odpowiedzi, szybkością i limitami kontekstu, a interfejs agregujący nie zmienia jakości generowanej przez model odpowiedzi; wywołania są rozliczane według zużycia, więc długi kontekst i częste wywołania istotnie podnoszą koszty; klucz API jest poświadczeniem i nie powinien trafiać do publicznych repozytoriów. Potrzebne są także połączenie z internetem i dostępność platformy, natomiast ceny i zasady podlegają warunkom podanym na stronie platformy.



