Mofa Xingyun é uma plataforma de desenvolvimento de humanos digitais 3D com direção em tempo real, geração de vídeo, síntese de voz e integração por SDK ou API.
Mofa Xingyun: plataforma de humanos digitais 3D
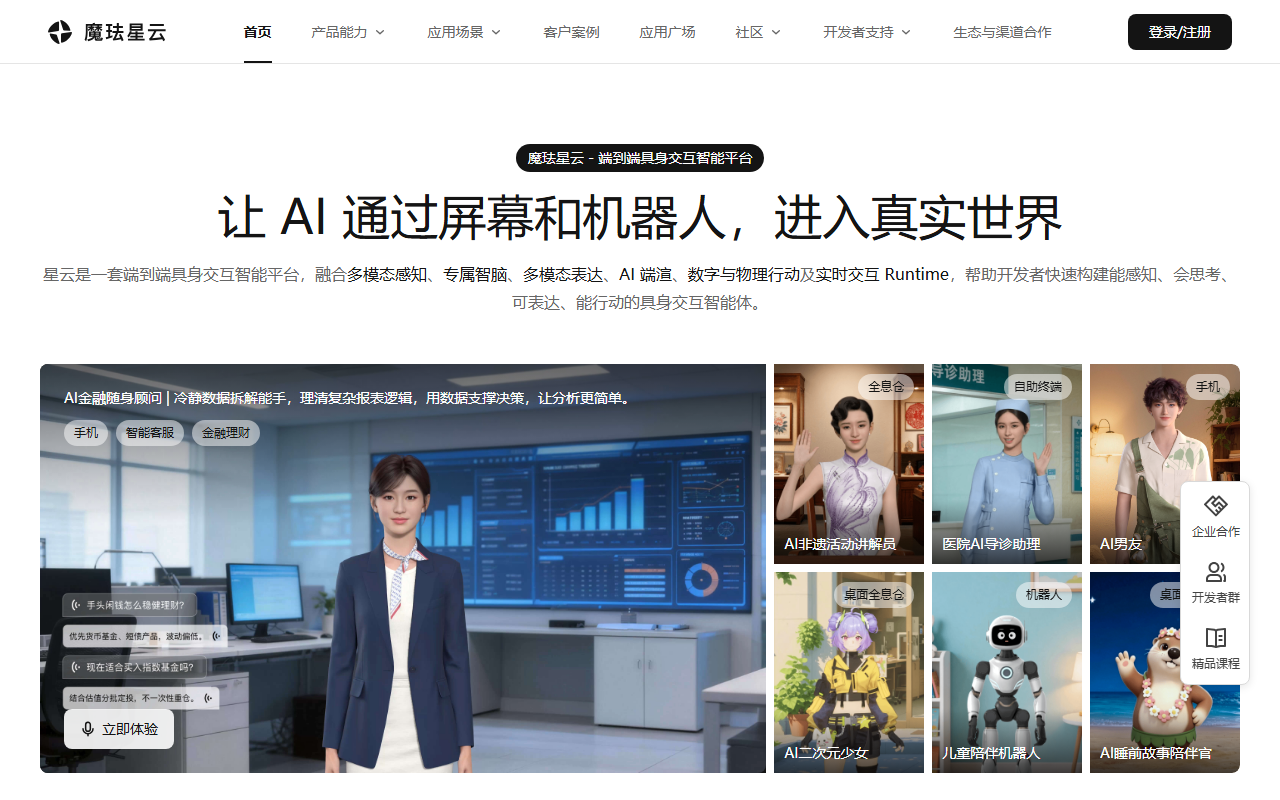
Mofa Xingyun é uma plataforma aberta para desenvolvedores que criam humanos digitais 3D. As informações do produto descrevem voz, expressões e movimentos em tempo real guiados por texto, além de geração de vídeo, síntese de voz e interação multimodal. Equipes podem integrar esses recursos por SDK ou API conforme as necessidades do projeto. Consulte a documentação oficial atual para confirmar recursos disponíveis, requisitos de implantação e capacidades do modelo.
Recursos principais
- Direção em tempo real: gera voz, expressões, olhar, gestos e movimentos corporais a partir de texto para experiências interativas.
- Vídeo com avatar: o material descreve vídeos de apresentadores 3D criados a partir de texto ou PPT, com preparação de cena, iluminação e câmera.
- Síntese de voz: são citadas vozes em vários idiomas e estilos, com expressão emocional. Também há menção à clonagem de voz; obtenha autorização explícita da pessoa antes de usar uma voz clonada.
- Interação multimodal: combina significado e emoção do texto com fala e movimentos gerados.
- Integração para desenvolvedores: as opções descritas incluem SDK de direção corporal, API de geração de vídeo e API de síntese de voz.
Como começar
- Acesse o site oficial do Mofa Xingyun para consultar produto, documentação, privacidade e preços atuais.
- Registre-se e crie um aplicativo; escolha direção em tempo real, geração de vídeo ou síntese de voz para o caso de uso.
- Integre o SDK ou API conforme a documentação e teste latência, imagem, voz e comportamento nos dispositivos antes do lançamento.
- Antes da implantação, confirme tratamento de dados, avisos aos usuários, direitos de imagem e voz, revisão de conteúdo e orçamento.
Cobrança e aplicações
A plataforma é descrita como baseada em créditos. O consumo varia por recurso; no vídeo, pode depender de resolução, complexidade da cena, taxa de quadros e duração. Os exemplos podem mudar, então consulte o custo atual antes de gerar.
Possíveis aplicações incluem atendimento virtual, professores digitais, funcionários virtuais, terminais interativos e treinamento de vendas. O desempenho depende do conteúdo, da configuração, da conexão e do dispositivo. Confirme suporte entre dispositivos, concorrência, latência e permissões comerciais na documentação e em testes do projeto. Para usar rostos ou vozes reais, obtenha autorização e respeite a privacidade e as leis aplicáveis.
Perguntas frequentes
O que a plataforma pode gerar?
A descrição inclui voz, expressões e movimentos em tempo real, vídeos a partir de texto ou PPT e síntese de voz multilíngue.
Há APIs para desenvolvedores?
São citados SDK de direção corporal e APIs de vídeo e voz. Consulte a documentação oficial para acesso e requisitos.
Como o uso é cobrado?
A cobrança usa créditos, com consumo variável por recurso e configuração do vídeo. Confirme as tarifas antes de iniciar.
Perguntas frequentes
Quais recursos oferece?
As informações descrevem voz, expressões e movimentos em tempo real, vídeos a partir de texto ou PPT e síntese de voz multilíngue.
Como desenvolvedores podem integrar?
São citados um SDK de direção corporal, uma API de vídeo e uma API de voz. Consulte a documentação oficial para os requisitos atuais.
Como funciona a cobrança?
A plataforma usa créditos e o consumo varia por recurso e configuração do vídeo. Confirme os preços atuais antes de gerar.