

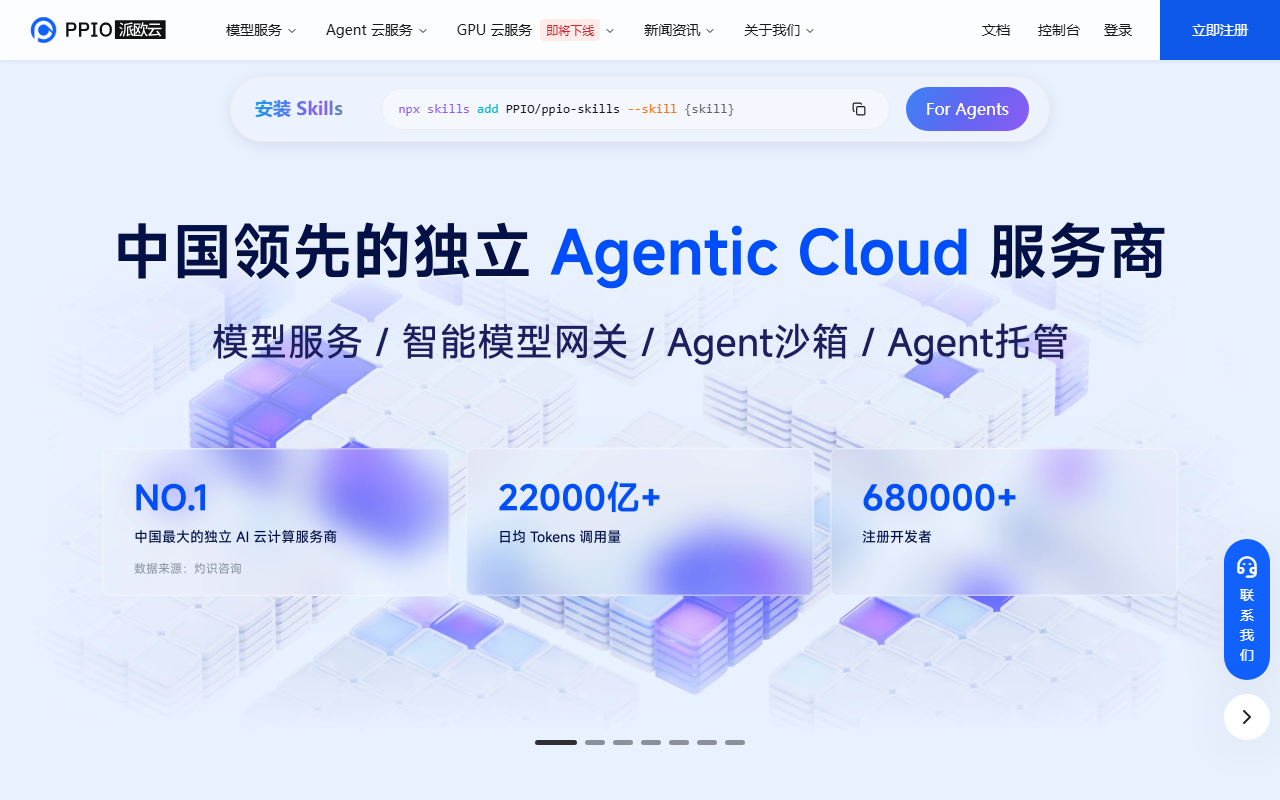
O PPIO Paiouyun é uma plataforma de nuvem distribuída que agrupa recursos de GPU dispersos em uma única malha de computação, permitindo lançar recursos de IA generativa com APIs compatíveis com OpenAI ou instâncias de GPU sob demanda, com opção de cluster privado para empresas.
O que é o PPIO Paiouyun
O PPIO Paiouyun é um provedor de computação em nuvem distribuída que reúne a capacidade de servidores profissionais localizados na borda da rede e em data centers regionais em uma única malha de computação. Ele combina um modelo de economia compartilhada com tecnologias de big data, nuvem nativa e computação distribuída, e entrega essa capacidade como APIs de inferência de IA, instâncias de GPU e soluções setoriais. As linhas principais são nuvem de inferência de IA, soluções de áudio e vídeo, renderização em nuvem para metaverso e implantação privada para empresas. O site oficial do produto é ppio.cn.
Diferente de uma nuvem pública tradicional, que em geral revende máquinas virtuais dos próprios data centers, o PPIO se posiciona como agregador e escalonador de computação. De um lado agrega recursos heterogêneos — data centers de grande porte, nós regionais e equipamentos ociosos —; do outro os expõe por meio de um console único, uma API comum e um motor próprio de aceleração de inferência. A plataforma também lista modelos recentes como o DeepSeek-R1-0528, que pode ser chamado pela API ou testado direto no espaço de modelos.
Principais recursos
Serviço de API de modelos
Oferece APIs de grandes modelos de linguagem e também de geração de imagem e vídeo. Os endpoints seguem o padrão da API da OpenAI, então na maioria dos projetos a migração se resume a trocar a URL base, a chave e o nome do modelo, mantendo o código atual do SDK da OpenAI. O PPIO informa estabilidade de até 99,9% e permite alternar entre modelos multimodais em segundos com aceleração de inferência, o que ajuda times que comparam vários modelos ou misturam texto e imagem no mesmo produto.
Nuvem de GPU
A capacidade de GPU vem em dois formatos. Instâncias de contêiner GPU entregam recursos conteinerizados com cobrança por uso, imagens prontas e implantação em um clique: indicadas para treinamento, ajuste fino e inferência em lote, quando você controla o ambiente. As GPUs sem servidor atendem modelos próprios sem operar infraestrutura, com escalonamento automático, balanceamento de carga e inicialização a frio em segundos, ideais para inferência online com tráfego irregular.
Soluções de áudio e vídeo
Com base em nós de borda amplamente distribuídos e anos de experiência em mídia, a linha integra hardware, rede e tecnologia audiovisual para vídeo sob demanda de formato longo e curto, streaming de entretenimento, chamadas de vídeo e transmissões interativas. A proposta é uma pilha completa com qualidade alta, custo baixo e entrega estável.
Renderização em nuvem e metaverso
Com software gráfico profissional de código aberto rodando na computação de borda, a plataforma oferece implantação automática de renderização em nuvem para aplicações de metaverso que precisam renderizar ativos ou quadros remotamente.
Implantação privada para empresas
Para companhias que não podem enviar dados a uma nuvem compartilhada, o PPIO oferece cluster de GPU dedicado com operação totalmente gerenciada: a pilha de serving fica em um ambiente controlado pela empresa, enquanto a operação diária permanece com o provedor.
Como começar
- Criar uma conta no site oficial com número de telefone ou nome de usuário.
- Verificar a identidade: a verificação pessoal ou empresarial é obrigatória antes de liberar computação e API.
- Adicionar saldo na página de visão geral da conta; aceita Alipay, WeChat Pay e transferência bancária corporativa.
- Gerar uma chave de API na página de gerenciamento de chaves se for usar a API, e nunca colocá-la em código de frontend ou repositório público.
- Chamar um modelo: abra o espaço de modelos, escolha um cartão e use o painel de teste online com seus parâmetros. Para integrar, aponte um cliente compatível com OpenAI para o endpoint da plataforma com sua chave e o nome do modelo; código Python costuma ser reaproveitado sem mudanças.
- Subir cargas de GPU: crie instâncias de contêiner ou implantações sem servidor pelo console, escolhendo especificação, imagem ou modelo e regras de escalonamento.
Onde se encaixa
- Lançar produtos de IA generativa: chat, escrita, geração de imagem e vídeo sem montar cluster próprio de inferência.
- Vídeo e transmissões: transcodificação e entrega para sob demanda, entretenimento e streaming interativo.
- Renderização em lote: cinema, visualização arquitetônica e cenas de metaverso.
- Capacidade elástica: picos de tráfego ou treinamentos pontuais com cobrança por uso.
- Direção autônoma e pesquisa: cargas que exigem baixa latência, banda larga ou computação paralela massiva.
Limites e pontos de atenção
- Números como 99,9% de estabilidade, inicialização a frio em segundos e troca instantânea de modelo são declarações do fornecedor; não foram medidos de forma independente aqui, então vale testar com o seu tráfego antes de decidir.
- A cobrança combina pré-pago e por uso, e a verificação de identidade é obrigatória. Preços unitários, cotas gratuitas e descontos vêm do console e do time comercial; este artigo não divulga valores.
- O catálogo de modelos muda. A disponibilidade do DeepSeek-R1-0528 e de outros modelos deve ser conferida no espaço de modelos no momento do uso.
- Soluções de áudio e vídeo e implantação privada são projetos entre empresas, que passam por negociação comercial e não por autoatendimento imediato.
- Chaves de API são sensíveis: um vazamento pode gerar custo real, então separe por projeto e faça rotação periódica.
Perguntas frequentes
Qual a diferença em relação a uma GPU de nuvem pública comum? Uma nuvem pública comum vende principalmente instâncias dos próprios data centers. O PPIO agrega capacidade heterogênea de borda e regional sob um modelo compartilhado e a expõe com uma única API e camada de escalonamento, de modo que o mesmo console traz GPU por uso, implantações sem servidor e APIs compatíveis com OpenAI. Esse conjunto atende times que querem uma API gerenciada hoje e talvez a própria pilha de inferência depois.
Quanto custa migrar um projeto que já usa o SDK da OpenAI? Normalmente são três ajustes: URL base, chave de API e nome do modelo. A lógica de negócio não muda. Faça uma regressão em homologação cobrindo streaming e chamadas de ferramentas antes de mover o tráfego de produção.
Preciso de uma instância de GPU para um teste pequeno? Comece pelo teste online no espaço de modelos e depois chame a API por consumo, que custa menos que uma instância sempre ligada. Migre para instância de GPU ou sem servidor quando precisar de modelos próprios, dependências específicas ou latência previsível.
Uma empresa pode manter os dados no próprio ambiente? Sim, com a opção de cluster de GPU dedicado mais implantação privada totalmente gerenciada. Tamanho do cluster, isolamento de rede e prazos são acordados com o time comercial.

Perguntas frequentes
Qual a diferença em relação a uma GPU de nuvem pública comum?
A nuvem pública comum vende instâncias próprias. O PPIO agrega capacidade heterogênea de borda e regional e a expõe com uma única API e camada de escalonamento: o mesmo console traz GPU por uso, sem servidor e APIs compatíveis com OpenAI.
Quanto custa migrar um projeto que já usa o SDK da OpenAI?
São três ajustes: URL base, chave e nome do modelo; a lógica de negócio não muda. Faça regressão em homologação com streaming e chamadas de ferramentas antes de mover o tráfego.
Preciso de uma instância de GPU para um teste pequeno?
Não. Teste no espaço de modelos e use a API por consumo, mais barato que uma instância ligada 24 horas. Migre para GPU ou sem servidor se precisar de modelos próprios ou latência previsível.
Uma empresa pode manter os dados no próprio ambiente?
Sim, com cluster de GPU dedicado e implantação privada totalmente gerenciada; tamanho, isolamento de rede e prazos são acordados com o time comercial.



