

A Shuyan AI é fornecedora de APIs para equipes cujo modelo não consegue ler a web. São três interfaces centrais: extração web que recebe uma URL e devolve Markdown ou JSON estruturado, busca ao vivo com fontes de notícias, enciclopédias e artigos acadêmicos, e OCR que converte PDFs e digitalizações em texto com hierarquia. Um marketplace de modelos adiciona chamadas agregadas a LLMs de terceiros e integração via MCP. Contas novas recebem 500 chamadas gratuitas, a API é REST e há implantação privada. As alegações de latência e preço vêm do fornecedor.
Shuyan AI: APIs de extração web, busca ao vivo e OCR para modelos de linguagem
Quem constrói agentes acaba batendo na mesma parede: o modelo é inteligente o suficiente, mas não enxerga a página que precisa ler. Ou o conhecimento para na data de treino, ou o HTML chega soterrado por menus e anúncios, ou o documento decisivo existe apenas como PDF digitalizado. A Shuyan AI ataca essa lacuna: não treina modelos, vende a tubulação que reorganiza o mundo externo em algo que o modelo consegue ingerir. Três perguntas decidem se vale integrar: a saída é de fato limpa e estruturada, um resultado de busca pode ser rastreado até uma fonte verificável e a latência se mantém na concorrência que você precisa.
A empresa se posiciona como infraestrutura de dados para a era dos grandes modelos e descreve sua abordagem como bimodal, combinando visão computacional e código. Um caminho interpreta a página conforme ela é renderizada; o outro extrai estrutura por lógica de código, e os dois se conferem mutuamente. A proposta ataca duas fraquezas clássicas do scraping: páginas renderizadas no cliente, que uma requisição HTTP simples nunca vê, e seletores frágeis que quebram quando o layout muda. O fornecedor afirma que seu índice cobre mais de 300 domínios e centenas de milhões de registros estruturados, filtrando ruído publicitário.
A oferta se divide em três camadas. Na base ficam as três interfaces de dados: extração, busca e OCR. Acima, um marketplace que agrupa chamadas a vários provedores, agentes conversacionais, um modo de pesquisa profunda e integração com fluxos MCP. Nas bordas aparecem serviços de conjuntos de dados e uma plataforma de análise BI. A maioria das equipes usará apenas dois ou três endpoints da camada inferior; o restante são capacidades adjacentes do mesmo fornecedor e devem ser avaliadas em separado.
Como funcionam as capacidades centrais
Extração web: reconstruir a página renderizada como texto legível
Envia-se uma URL e recebe-se Markdown ou JSON estruturado. O valor não está em conseguir baixar a página, mas em não precisar escrever regras de limpeza depois: corpo do texto, hierarquia de títulos e tabelas são preservados onde possível, enquanto anúncios e navegação são descartados. Num pipeline de recuperação, essa etapa define o teto da qualidade dos trechos, e essa qualidade define o teto da recuperação. Entrada suja gera trechos parecidos no espaço vetorial e inúteis na prática. O fornecedor declara suporte a páginas com renderização dinâmica e layouts complexos, exatamente o que um caminho de visão oferece além de um analisador DOM puro.
Busca ao vivo: uma camada de recuperação citável
O endpoint de busca é desenhado para consumo por modelos e devolve trechos pontuados e estruturados, não uma lista crua de links. As fontes declaradas cobrem notícias, enciclopédias, material acadêmico e plataformas de mídia, atualizadas contra um rastreamento amplo e um arquivo próprio de sites. Em aplicações de pesquisa, a diferença visível está na amplitude de referências: o fornecedor afirma que o modo de pesquisa profunda consulta sete vezes mais páginas que uma busca comum, o que significa mais contexto e mais margem para contrastar afirmações.
OCR de documentos: preservar a hierarquia, não só os caracteres
Envia-se um PDF ou digitalização e o motor extrai texto, tabelas e fórmulas em Markdown e JSON que mantêm a estrutura do documento. O difícil nunca foi reconhecer glifos isolados, e sim reconstruir a organização: qual linha é título, qual tabela atravessa três páginas, qual símbolo de uma fórmula é subscrito. A hierarquia importa adiante porque uma base de conhecimento fragmenta por títulos. Perdida a estrutura, resta cortar por número fixo de caracteres, o que parte frases e tabelas ao meio.
Marketplace e MCP: chamadas de modelo e dados na mesma camada
O marketplace agrega vários provedores de LLM atrás de um único endpoint, com cobrança e formatos unificados, evitando que a equipe mantenha vários deploys. A integração MCP injeta busca e extração em fluxos de IA por interface padronizada, poupando a reescrita da lógica de chamada de ferramentas para quem já usa esse protocolo. O ganho conjunto é configurar num só lugar: o lado de dados e o de modelos deixam de ser integrações separadas com falhas separadas.
Como começar
- Cadastre-se no site oficial e crie uma chave de API. Contas novas incluem 500 chamadas gratuitas, suficientes para exercitar as três interfaces antes de comprometer orçamento.
- Valide a extração com as páginas que realmente importam. Escolha de dez a vinte URLs reais, incluindo renderização dinâmica, tabelas complexas e artigos longos paginados, e verifique se o Markdown devolvido mantém a estrutura necessária. Não julgue pela página de exemplo do fornecedor.
- Para o OCR, monte antes amostras de fronteira: layout em duas colunas, tabelas que cruzam quebras de página e digitalizações com fórmulas. Os erros estruturais se concentram justamente aí, e encontrá-los antes do lançamento custa muito menos.
- Se você já usa Dify ou Coze, monte o recurso dentro de um fluxo de agente em vez de escrever um backend. Para integração direta, chame os endpoints REST e escolha Markdown quando uma pessoa for revisar a saída e JSON quando um programa for analisá-la.
- Para cargas de governo ou finanças o fornecedor oferece implantação privada de alta concorrência, mas forma de entrega, prazo e custo não são publicados: exigem conversa comercial.
Preço e cotas
- O único número publicado são 500 chamadas gratuitas por conta nova. Serve para uma prova de conceito e está longe do volume de produção.
- A cobrança é medida por tokens, e o fornecedor situa o preço em cerca de um terço do de serviços comparáveis, cobrando apenas chamadas bem-sucedidas. Cobrar só o sucesso importa mais aqui do que numa API de texto, porque falhas de extração são naturalmente mais frequentes.
- Preço unitário por endpoint, faixas por volume, cotação da implantação privada e regras de liquidação ao esgotar a cota gratuita não são divulgados. Confirme no console ou com o time comercial antes de projetar custos.
Para quem serve
- Desenvolvedores que constroem agentes no Dify ou no Coze e precisam de leitura de páginas e busca ao vivo sem manter rastreadores e pools de proxy.
- Equipes de recuperação e bases de conhecimento cujo material interno vive em PDFs e digitalizações e precisa virar texto fragmentável com hierarquia.
- Produtos de agregação de conteúdo e comparação de preços que capturam e limpam dados de produtos e notícias continuamente e são sensíveis a ruído publicitário.
- Equipes técnicas de finanças ou governo que exigem implantação privada e residência de dados sem abrir mão da recuperação ao vivo.
Limites e ressalvas
- Todos os números de desempenho vêm do fornecedor. Latência média abaixo de um segundo, quarenta por cento mais rápido que o setor, taxa de erro abaixo de 0,01 por cento e preço de um terço não têm referência independente, e o corpus de teste não é detalhado. Meça com seus próprios sites-alvo.
- A transparência de preços é limitada. Além das 500 chamadas, o material público não informa preço unitário, teto de concorrência, política de limite de taxa nem se novas tentativas com falha são cobradas.
- Faltam detalhes de conformidade. Extração e busca tocam conteúdo de terceiros, então limites de direitos autorais, tratamento de robots e retenção do material baixado precisam de confirmação por escrito, sobretudo se você for redistribuir o que obtém.
- A qualidade multilíngue não é declarada. O fornecedor insiste na precisão em páginas complexas em chinês, vantagem para sites chineses que nada diz sobre o desempenho em outros idiomas.
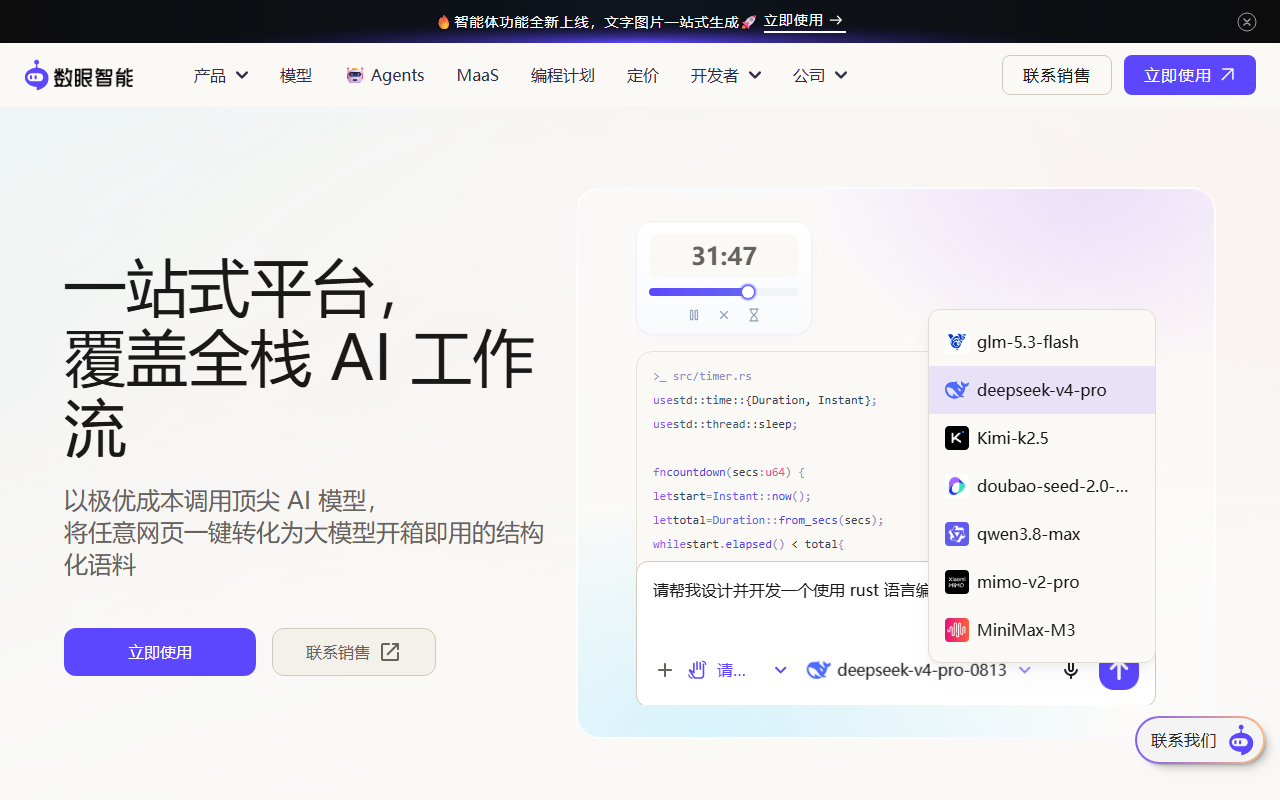
- O único ativo de mídia confirmável é uma captura oficial com âncora de substituição, por isso este artigo não traz imagens. Consulte o console para ver interface e exemplos de saída.
Perguntas frequentes
A Shuyan AI é um modelo?
Não. É uma camada de dados e agregação. Não treina modelos de base; vende endpoints de extração, busca e OCR, além de um marketplace que encaminha para modelos de terceiros. O modelo por baixo continua sendo escolha sua.
Qual a vantagem sobre escrever meu próprio rastreador?
Sobretudo o custo de manutenção. Um rastreador próprio lida com renderização dinâmica, medidas anti-bot, seletores que expiram e limpeza de texto, e um único redesenho pode quebrar tudo. Uma API gerenciada transfere essa carga ao fornecedor em troca de preço unitário e controle: você manda menos nas regras de extração, o que dói em páginas atípicas.
Conecta direto ao Dify ou ao Coze?
O fornecedor afirma suporte às duas plataformas dentro de fluxos de agente. Confirme nomes de plugin e passos na listagem de cada plataforma, pois este artigo não os verifica.
O que acontece ao esgotar a cota gratuita?
As regras de liquidação e o preço unitário acima da faixa gratuita não são públicos. Faça a validação dentro das 500 chamadas e peça cotação confirmando se a cobrança é apenas por sucesso, para o modelo de custo não divergir.
Perguntas frequentes
A Shuyan AI é um modelo?
Não. É uma camada de dados e agregação. Não treina modelos de base; vende endpoints de extração, busca e OCR, além de um marketplace que encaminha para modelos de terceiros. O modelo por baixo continua sendo escolha sua.
Qual a vantagem sobre escrever meu próprio rastreador?
Sobretudo o custo de manutenção. Um rastreador próprio lida com renderização dinâmica, medidas anti-bot, seletores que expiram e limpeza de texto, e um único redesenho pode quebrar tudo. Uma API gerenciada transfere essa carga ao fornecedor em troca de preço unitário e controle: você manda menos nas regras de extração, o que dói em páginas atípicas.
Conecta direto ao Dify ou ao Coze?
O fornecedor afirma suporte às duas plataformas dentro de fluxos de agente. Confirme nomes de plugin e passos na listagem de cada plataforma, pois este artigo não os verifica.
O que acontece ao esgotar a cota gratuita?
As regras de liquidação e o preço unitário acima da faixa gratuita não são públicos. Faça a validação dentro das 500 chamadas e peça cotação confirmando se a cobrança é apenas por sucesso, para o modelo de custo não divergir.



