
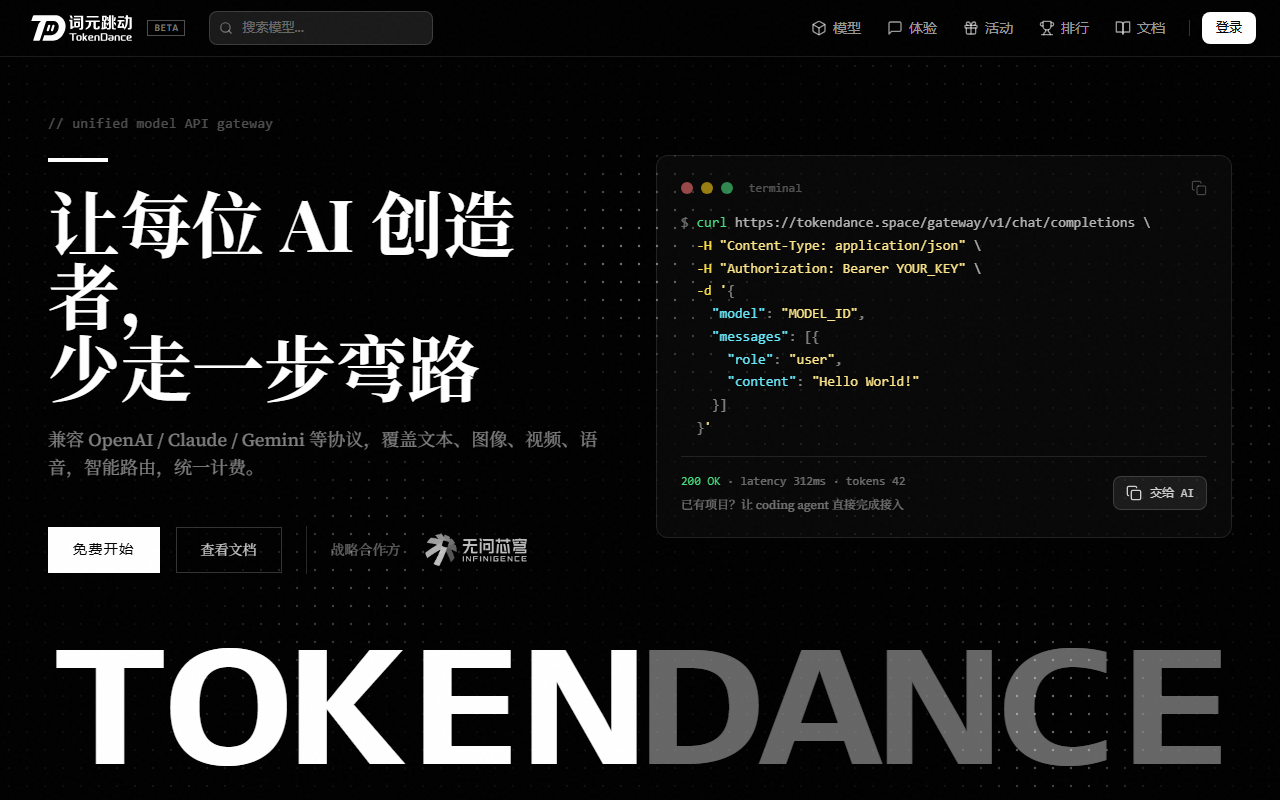
TokenDance é um gateway de agregação de API para modelos de linguagem. É compatível nativamente com os protocolos OpenAI, Claude e Gemini: troque a Base URL pelo endereço do gateway, informe a chave de API e o identificador do modelo, e as chamadas do SDK atual chegam a MiniMax, Qwen, Kimi, Zhipu, DeepSeek e outros modelos chineses. Traz roteamento inteligente, cobrança unificada entre provedores e failover entre endpoints, sem alterar o código de negócio.
TokenDance: uma única Base URL para vários provedores de modelos chineses
Quem constrói um produto de IA passa pela mesma fase: conecta um provedor para validar o fluxo e depois um segundo e um terceiro por qualidade ou custo. Logo o código carrega uma camada de adaptação, as chaves se espalham por painéis, as faturas ficam em contas diferentes e, quando um provedor oscila, alguém troca o endpoint na mão. O TokenDance mira esse atrito: uma Base URL na frente de vários provedores, com a aplicação enxergando um único ponto de entrada.
O mecanismo não tem nada de exótico. Ele expõe três formatos de protocolo majoritários — OpenAI, Claude e Gemini — e roteia internamente por nome de modelo até o endpoint correspondente. O desenvolvedor muda configuração, não código, e é isso que torna a promessa de migração zero plausível. Num projeto que já usa o SDK da OpenAI, uma linha de Base URL basta para testar um modelo chinês, então o custo de experimentar cai bastante.
O restante do valor está na operação. Com vários endpoints para o mesmo modelo, a queda de um provedor pode acionar troca automática; uma requisição também pode listar modelos candidatos e degradar passo a passo se o principal não responder. A cobrança unificada junta o consumo de tokens de todos os provedores numa fatura só e elimina recargas e conciliações separadas. A fonte não detalha tarifas, limites de requisição, compromissos de nível de serviço nem retenção de dados, então confirme antes de integrar.
Principais recursos
Compatibilidade de protocolos
O suporte nativo a OpenAI, Claude e Gemini faz a troca da Base URL bastar, sem tocar no código de negócio. Em projetos legados essa é a parte mais prática: testar um modelo novo não exige reconstruir a camada de chamadas.
Roteamento inteligente
As requisições vão pelo nome do modelo até o endpoint correto e os detalhes de agendamento ficam escondidos atrás de uma entrada. Não é mais preciso memorizar domínios e peculiaridades de parâmetros de cada provedor.
Cobrança unificada
O consumo de tokens é contabilizado entre provedores e faturado num só lugar, sem recarregar cinco painéis. Na hora de atribuir custos, uma fatura se explica melhor que cinco.
Failover e degradação
Um mesmo modelo pode ter vários endpoints com troca automática, e uma requisição pode nomear modelos candidatos para recuar em ordem. É a vantagem mais concreta de um gateway sobre a integração direta.
Cobertura de modelos
Há mais de oito modelos chineses de referência conectados, entre eles MiniMax, Qwen, Kimi, Zhipu e DeepSeek, com ampliações contínuas. A cobertura é de modelos chineses principais, não um catálogo global.
Início rápido
O cadastro e a verificação usam o login em um clique do Watcha, e os SDKs existentes continuam funcionando, então a integração leva minutos. Esse login vincula a conta a um sistema específico, condição que precisa ser aceita.
Programa de subsídio
Um formulário permite solicitar patrocínio de tokens conforme a fase do produto. Útil em projetos iniciais, embora valor e critérios de aprovação não sejam publicados.
Primeiros passos
- Acesse o site do TokenDance e cadastre-se com o login em um clique do Watcha para verificar a conta.
- Gere uma chave de API pessoal no console e guarde como qualquer credencial.
- Substitua a Base URL do projeto pelo endereço do gateway https://tokendance.space/gateway/v1/.
- Informe o identificador do modelo desejado na requisição, por exemplo DeepSeek ou Kimi.
- Envie a requisição com o SDK da OpenAI já existente ou com curl e confira se a resposta é a esperada.
- Se precisar de grande volume de tokens, envie o formulário do programa de subsídio conforme a fase do produto.
Para quem serve
- Equipes iniciantes que comparam vários modelos chineses com custo baixo por um gateway antes de decidir.
- Produtos que roteiam por tipo de tarefa em produção, enviando raciocínio, escrita e código a modelos distintos.
- Sistemas de agentes que precisam de uma camada de modelos com alta disponibilidade e degradação.
- Educação, pesquisa e desenvolvedores individuais sensíveis a custo que aproveitam a cobrança unificada.
Limitações
- Tarifas, cota gratuita, limites de requisição e compromissos de serviço não são divulgados; confirme com o fornecedor antes de integrar.
- As contas exigem login em um clique do Watcha, o que implica aceitar esse sistema; a integração com identidade corporativa não é descrita.
- O gateway vê o conteúdo das requisições e a política de retenção ou logs não é informada, então avalie conformidade com dados sensíveis.
- O catálogo é focado em modelos chineses principais; modelos globais ou abertos de nicho podem faltar.
- Um salto extra adiciona latência e mais um ponto de falha. O failover ajuda, mas ainda é preciso monitoramento próprio.
- Valores, critérios e continuidade do subsídio não são publicados; não baseie neles um modelo de custo de longo prazo.
Perguntas frequentes
Precisa mudar código?
Não o de negócio. Troque a Base URL pela do gateway, informe chave e modelo, e continue usando o SDK da OpenAI como antes.
Quais modelos existem?
A fonte cita mais de oito modelos chineses principais, incluindo MiniMax, Qwen, Kimi, Zhipu e DeepSeek, com expansão contínua. A lista definitiva está no console.
Como funciona o failover?
Dois níveis: vários endpoints por modelo com troca automática, e modelos candidatos por requisição que degradam em ordem se o principal falhar.
Qual a diferença de chamar cada provedor?
A integração direta obriga a gerenciar chaves, recargas, limites e failover por provedor. Um gateway centraliza isso em uma entrada e uma fatura, ao custo de um salto extra e da dependência do próprio gateway.
Existe nível gratuito?
A fonte menciona apenas um programa de patrocínio solicitado conforme a fase do produto, sem cota gratuita regular. Vale perguntar ao fornecedor.
Perguntas frequentes
Precisa mudar código?
Não o de negócio. Troque a Base URL pela do gateway, informe chave e modelo, e continue usando o SDK da OpenAI como antes.
Quais modelos existem?
A fonte cita mais de oito modelos chineses principais, incluindo MiniMax, Qwen, Kimi, Zhipu e DeepSeek, com expansão contínua. A lista definitiva está no console.
Como funciona o failover?
Dois níveis: vários endpoints por modelo com troca automática, e modelos candidatos por requisição que degradam em ordem se o principal falhar.
Qual a diferença de chamar cada provedor?
A integração direta obriga a gerenciar chaves, recargas, limites e failover por provedor. Um gateway centraliza isso em uma entrada e uma fatura, ao custo de um salto extra e da dependência do próprio gateway.



