

O TokenPony atende desenvolvedores individuais, equipes pequenas, empresas e pesquisadores que precisam usar vários modelos grandes ao mesmo tempo, não querem montar servidores GPU próprios e preferem uma interface unificada que simplifique a integração.
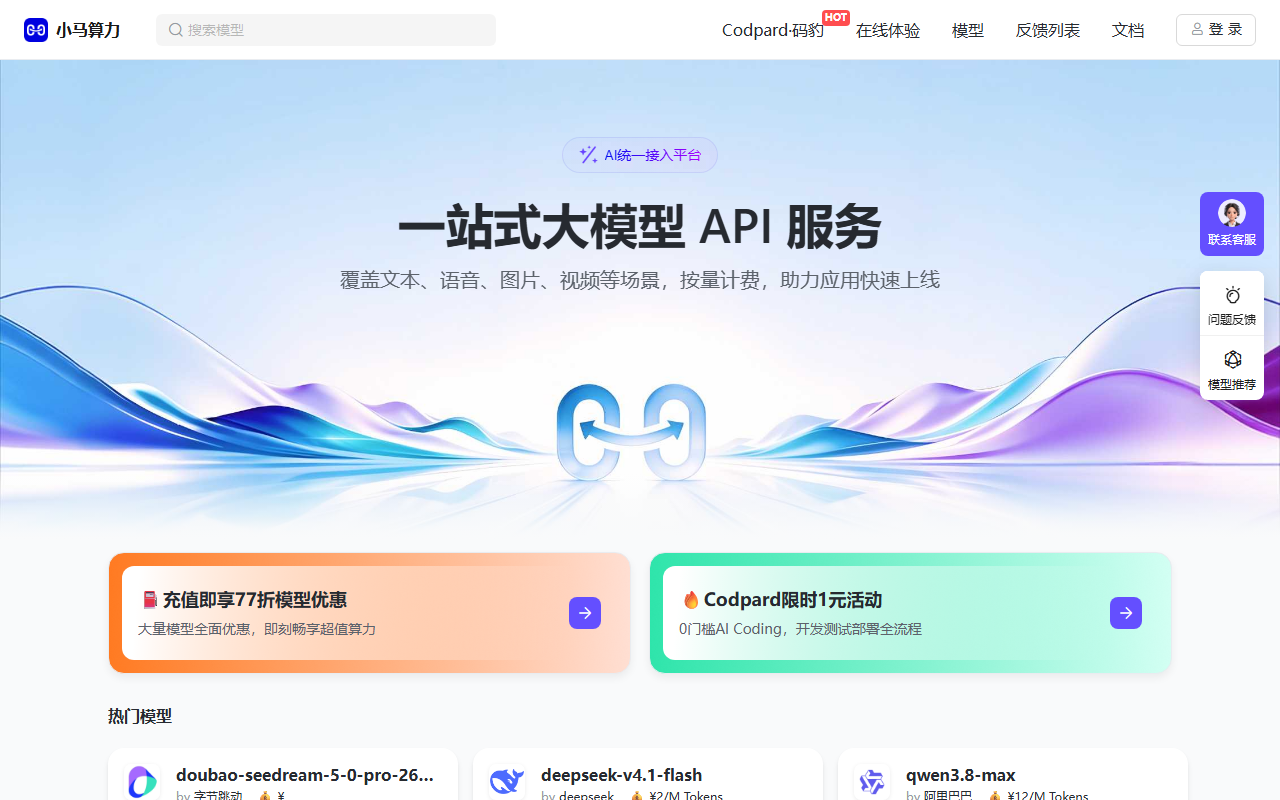
TokenPony: uma plataforma de agregação de API com interface unificada para chamadas a modelos grandes
TokenPony é uma plataforma de agregação de API de modelos de IA criada para desenvolvedores individuais e equipes pequenas. Sua posição pode ser comparada à de uma camada de orquestração: reúne modelos grandes populares como DeepSeek, Kimi, Qwen e GLM sob uma mesma interface, de modo que o usuário não precisa ficar alternando entre vários provedores. Para os desenvolvedores, o que realmente consome mais esforço não é "chamar um modelo uma vez", mas o custo de integração, autenticação, cobrança e manutenção quando vários modelos são usados ao mesmo tempo. Esta plataforma reúne tudo isso em um só lugar e ainda oferece suporte a contexto ultralongo de 1024K para documentos longos, conversas de vários turnos e tarefas complexas com agentes, sem a necessidade de montar servidores GPU próprios.
Principais recursos
Acesso a todos os modelos Integra modelos grandes populares como DeepSeek, Kimi, Qwen e GLM. O usuário não precisa mudar de plataforma e pode chamar livremente modelos diferentes dentro da mesma plataforma. Para aplicações que usam vários modelos ao mesmo tempo, isso elimina o trabalho de integrações repetidas.
Suporte a contexto ultralongo Oferece capacidade de contexto de 1024K, utilizável para documentos longos, conversas de vários turnos e tarefas complexas com agentes. O tamanho do contexto determina diretamente quanta cabe em uma única requisição, e é um requisito prévio para tarefas de textos longos.
Chamada de API em um clique Sem configuração e sem implantação: integre e use. Os desenvolvedores não precisam lidar com implantação de serviço nem configuração do ambiente de execução; assim que obtiverem a chave, já podem começar a chamar.
Sem servidor GPU Basta usar as APIs de modelos já treinados, portanto não é preciso montar servidores GPU próprios e o custo de hardware é economizado. Para desenvolvedores individuais e equipes pequenas, esse costuma ser o fator mais decisivo.
Otimização de custos Oferece um mecanismo de preços transparente, o que facilita escolher entre desempenho e custo. O custo unitário varia bastante entre modelos, e preços claros ajudam a controlar o gasto total.
Etapas de uso
- Cadastro e login: acesse o site do produto e conclua o cadastro pela entrada de login no canto superior direito da página.
- Consultar os modelos: entre na página de modelos para ver a lista de modelos suportados e use o filtro para encontrar os detalhes de um modelo específico.
- Recarga de saldo: escolha a recarga em "Informações do usuário". Atualmente há suporte ao pagamento por WeChat, com valor mínimo de recarga de 10 yuans, destinado a cobrir as chamadas posteriores aos modelos.
- Criar uma API Key: na página de modelos, selecione o modelo que deseja configurar e poderá criar uma API Key para esse modelo.
- Chamar a interface: use a API Key criada para chamar o modelo desejado pela interface da plataforma e comece seu trabalho de desenvolvimento.
- Gerenciar o uso: estime o volume de chamadas de cada projeto e combine-o com os preços dos diferentes modelos para escolher o mais adequado, evitando consumo desnecessário.
Para quem é indicado
- Desenvolvedores individuais: querem acesso rápido a vários modelos grandes, simplificar o fluxo de desenvolvimento e reduzir custos de desenvolvimento
- Equipes pequenas: precisam aproveitar recursos limitados com eficiência e montar e implantar rapidamente aplicações baseadas em modelos grandes
- Profissionais criativos: como redatores e criadores de conteúdo, que precisam da IA para aumentar a eficiência e a qualidade da criação
- Empresas: querem integrar capacidades de IA nos negócios sem investir muitos recursos em construir modelos e infraestrutura próprios
- Pesquisadores: precisam chamar diferentes modelos de forma flexível para pesquisa e experimentos, explorando novos cenários de aplicação da IA
- Estudantes e professores: para aprender e ensinar, explorando aplicações da IA na educação
Limites e avisos
- As capacidades e os parâmetros dos modelos dependem das versões realmente oferecidas pela plataforma; diferentes modelos variam em qualidade de saída, velocidade e limites de contexto.
- Uma interface de agregação não altera a qualidade de saída dos próprios modelos; a precisão em tarefas importantes ainda precisa ser avaliada e verificada por você.
- As chamadas são cobradas por uso, e contextos longos e chamadas de alta frequência aumentam bastante o gasto, então estime com base no uso real.
- A API Key é uma credencial: guarde-a com cuidado e evite expô-la ou enviá-la a repositórios de código públicos.
- É necessária conexão com a internet e disponibilidade da plataforma; ajustes no serviço ou falhas afetam a cadeia de chamadas.
- Recargas, formas de pagamento, preços e ofertas seguem as páginas reais da plataforma; confirme as regras atuais antes de usar.
Perguntas frequentes
Que problema o TokenPony resolve?
O TokenPony reúne modelos grandes populares como DeepSeek, Kimi, Qwen e GLM sob uma mesma interface, evitando o trabalho de trocar de plataforma e integrar cada modelo separadamente. Também oferece contexto ultralongo de 1024K para documentos longos, conversas de vários turnos e tarefas complexas com agentes, e dispensa servidores GPU próprios, reduzindo o custo de hardware.
Como chamar um modelo no TokenPony?
O fluxo básico é: fazer cadastro e login, consultar na página de modelos quais são suportados, recarregar saldo em Informações do usuário, criar uma API Key para o modelo desejado nessa mesma página e usá-la para chamar o modelo pela interface da plataforma. As recargas aceitam pagamento por WeChat, com valor mínimo de 10 yuans.
O que observar ao usar uma plataforma de agregação de API?
Fique atento ao fato de que modelos diferentes variam em qualidade, velocidade e limites de contexto, e que a interface de agregação não altera a qualidade de saída dos próprios modelos. As chamadas são cobradas por uso, então contextos longos e chamadas frequentes elevam bastante o gasto. Trate a API Key como uma credencial e não a publique em repositórios públicos. É preciso ter conexão e disponibilidade da plataforma, e preços e regras seguem as páginas reais dela.



