
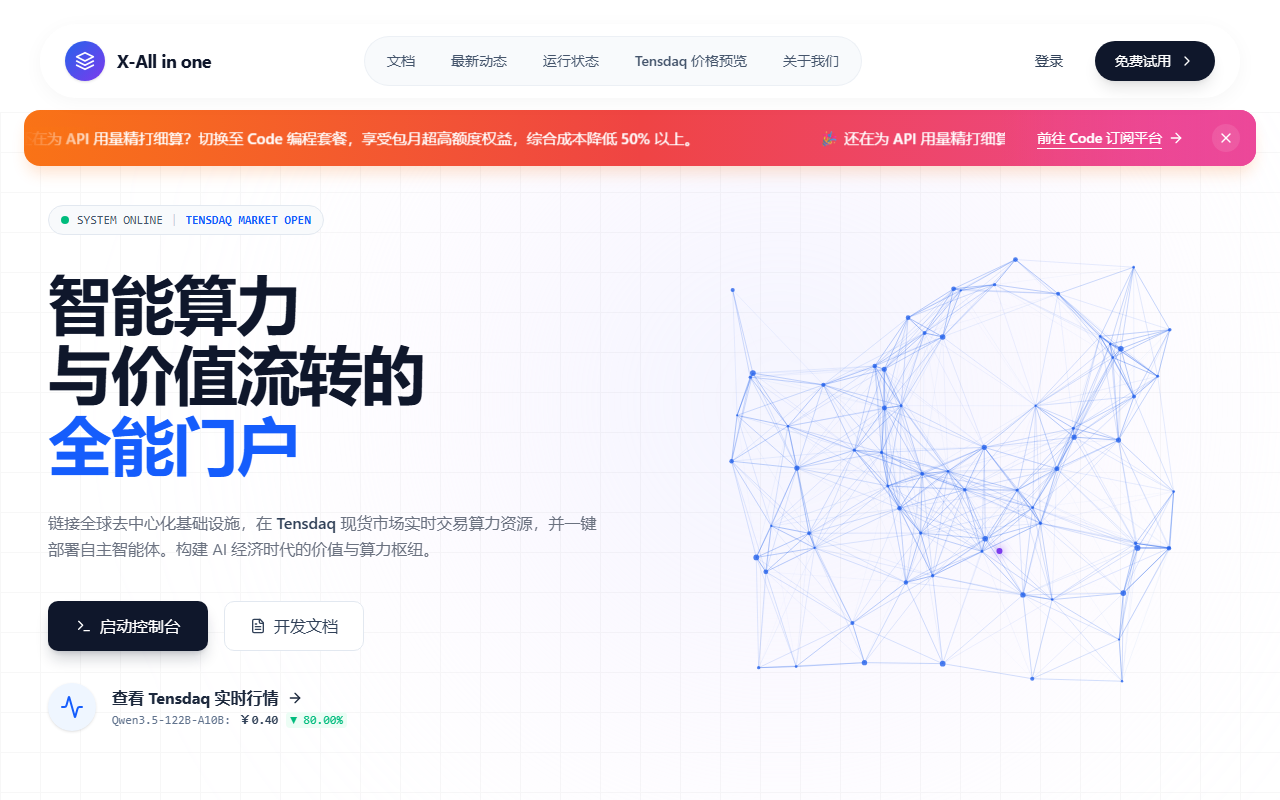
X-All in one é uma plataforma de API de IA desenvolvida internamente. Permite chamar vários modelos por uma única interface e usar o Tensdaq, onde você define o preço máximo por milhão de tokens.
O que é o X-All in one
O X-All in one é uma plataforma de API de IA desenvolvida internamente que reúne num único serviço o acesso a modelos, o agendamento de computação e a gestão de cobrança. De acordo com o material oficial, a infraestrutura se apoia na capacidade de computação de nível nacional das três grandes operadoras de telecomunicações, e tanto o agendamento de recursos quanto a camada de entrega da API foram construídos internamente, o que permite escalar de forma elástica e distribuir a carga entre regiões conforme a demanda.
Para quem usa, há dois pontos práticos: chamar vários modelos por uma única interface e usar o Tensdaq, um mecanismo de lances em que você define o próprio preço de inferência. Os números oficiais falam em tempo de resposta do primeiro pacote 30% abaixo da média do setor, preços em torno de 80% da média de mercado e custo real de uso mais de 20% menor. São dados fornecidos pelo fabricante, e os resultados reais variam conforme o modelo, o horário e a região, por isso vale testar com um lote pequeno de requisições antes de adotar a plataforma.
Principais recursos
Tensdaq, MaaS de IA por lances: o nome combina Tensor e Nasdaq. Em vez de um preço fixo por token, você indica o máximo que aceita pagar por milhão de tokens. A plataforma usa essa informação para redistribuir a demanda: tarefas grandes que não exigem resposta imediata podem ser agendadas nos horários mais baratos.
Motor próprio de agendamento de computação: um agendador distribuído desenvolvido internamente distribui os recursos sob alta concorrência e reduz as chances de interrupção do serviço.
API de alto desempenho: foi pensada para reduzir a latência do primeiro pacote e mira usos sensíveis ao atraso, como conversa em tempo real e saída em streaming.
Console único para desenvolvedores: uma interface visual com monitoramento de requisições e análise de consumo, de modo que volume, número de chamadas e custo aparecem no mesmo lugar.
Gestão unificada de vários modelos: dentro de um mesmo projeto é possível misturar modelos diferentes sem manter credenciais e código de integração separados para cada fornecedor.
Sistema de segurança: o fabricante descreve criptografia de transporte TLS e RSA, inferência criptografada por etapas e controle de permissões para isolar recursos.
Como começar
- Cadastro e crédito: acesse https://www.x-aio.com/ e crie sua conta; a documentação oficial informa que são concedidos automaticamente 20 yuan de crédito inicial, utilizáveis na API de lances.
- Obter a chave de API: entre no console, crie e copie sua chave de API.
- Integração: configure a chave no seu agente ou aplicação e chame a API padrão.
- Ativar o serviço de lances: abra a página do Tensdaq, veja a lista de modelos que aceitam lances, leia as condições e ative a função.
- Definir o lance: encontre o modelo desejado no Tensdaq e informe o máximo que pagará por milhão de tokens. O lance é calculado sobre o preço de entrada; o preço de saída segue um multiplicador fixo conforme o tipo de modelo.
- Aguardar a aplicação e revisar: a cada hora cheia o preço passa a valer. A tela de detalhes mostra até 24 horas de variação, com a média por hora e os picos e vales.
- Chamadas e monitoramento: escolha o endpoint do Tensdaq ao chamar a API e acompanhe no console o consumo e as métricas de desempenho, ajustando lance e configuração quando necessário.
O próprio fabricante recomenda começar com um lance de 10% a 15% acima da média de mercado para garantir estabilidade e reduzi-lo aos poucos depois.
Casos de uso
Desenvolvimento de agentes: cadeias de raciocínio complexas encadeiam muitas chamadas e são sensíveis tanto à latência quanto à concorrência. Um endpoint unificado e a computação elástica ajudam a manter a velocidade de resposta nos horários de pico.
Integração de IA na empresa: sistemas de atendimento, plataformas de geração de conteúdo e assistentes de análise de dados costumam precisar de vários modelos ao mesmo tempo para equilibrar qualidade e custo; a gestão unificada e a análise de consumo reduzem esse trabalho de engenharia.
Desenvolvedores individuais e pesquisa: o pagamento por uso combinado com lances permite validar ideias com orçamento apertado, sem grande investimento inicial, seja em projetos pessoais, equipes novas ou trabalhos acadêmicos.
Limitações e cuidados
Os números de desempenho e custo divulgados (primeiro pacote 30% mais rápido, preços em 80% da média, mais de 20% de economia, tempo médio de resolução de problemas abaixo de duas horas e equipe principal com mais de seis anos de experiência média no setor) são declarações do fabricante, sem medições independentes de terceiros, portanto decida com base nos seus próprios testes.
O modelo de lances troca previsibilidade por preço: o lance ser aceito depende da oferta e da demanda do momento e o preço pode mudar a cada hora, o que não combina com rotas de produção que exigem garantias rígidas de latência ou disponibilidade. Se o serviço precisa de garantias firmes, avalie primeiro a opção de preço fixo ou prepare um plano alternativo.
O valor, o alcance e a validade do crédito de cadastro seguem o que o site oficial informar; a lista de modelos, os idiomas com SDK e a disponibilidade regional também podem mudar, então confirme a situação atual no site oficial e na documentação da API antes de integrar. A criptografia no transporte e na inferência reduz a exposição, mas dados sensíveis exigem uma avaliação de conformidade própria.
Perguntas frequentes
Para quem o X-All in one é indicado? Serve a desenvolvedores e empresas que administram vários modelos por uma única interface e acompanham o custo de inferência, especialmente em agentes, atendimento ao cliente e geração de conteúdo.
Como funciona o sistema de lances do Tensdaq? Você define um preço máximo por milhão de tokens; o preço passa a valer a cada hora cheia e a plataforma ajusta oferta e demanda. A saída é cobrada com um multiplicador fixo conforme o tipo de modelo. A recomendação é começar com um lance de 10% a 15% acima da média de mercado.
Existe crédito gratuito para novos usuários? Segundo a documentação oficial, o cadastro concede automaticamente 20 yuan de crédito inicial, que pode ser usado na API de lances. O alcance e a validade seguem as regras publicadas no site oficial.
Perguntas frequentes
Para quem o X-All in one é indicado?
Serve a desenvolvedores e empresas que administram vários modelos por uma única interface e acompanham o custo de inferência, especialmente em agentes, atendimento ao cliente e geração de conteúdo.
Como funciona o sistema de lances do Tensdaq?
Você define um preço máximo por milhão de tokens; o preço passa a valer a cada hora cheia e a plataforma ajusta oferta e demanda. A saída é cobrada com um multiplicador fixo conforme o tipo de modelo. A recomendação é começar com um lance de 10% a 15% acima da média de mercado.
Existe crédito gratuito para novos usuários?
Segundo a documentação oficial, o cadastro concede automaticamente 20 yuan de crédito inicial, que pode ser usado na API de lances. O alcance e a validade seguem as regras publicadas no site oficial.



