

TokenPony se potrivește dezvoltatorilor independenți, echipelor mici, utilizatorilor companii și cercetătorilor care au nevoie să folosească simultan mai multe modele de limbaj mari, nu vor să construiască un server GPU propriu și vor un proces de integrare mai simplu printr-o singură interfață.
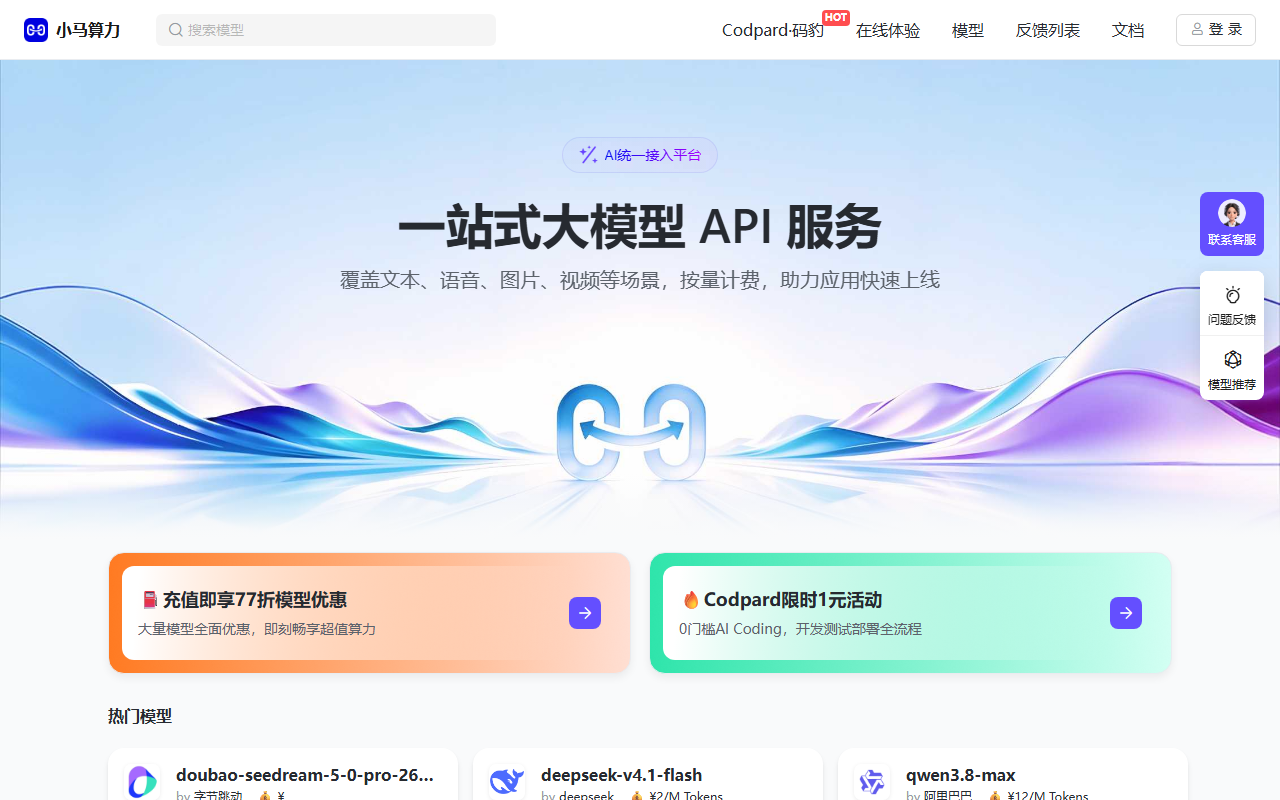
TokenPony: platformă de agregare a API-urilor de modele AI cu o singură interfață pentru apelarea modelelor de limbaj mari
TokenPony este o platformă de agregare a API-urilor de modele AI concepută pentru dezvoltatori independenți și echipe mici. Poziția sa poate fi asemuită cu un strat de orchestrare: reunește mai multe modele de limbaj mari populare, precum DeepSeek, Kimi, Qwen și GLM, într-o singură interfață, astfel încât utilizatorul nu trebuie să comute constant între platforme diferite. Pentru un dezvoltator, ceea ce consumă cel mai mult timp nu este „un singur apel al unui model”, ci costurile de integrare, autentificare, facturare și mentenanță atunci când se folosesc simultan mai multe modele. Platforma adună toate aceste aspecte într-un singur loc și oferă totodată suport pentru context de 1024K, util pentru documente lungi, conversații cu mai multe runde și sarcini complexe de tip agent, fără necesitatea de a construi propriul server GPU.
Funcții principale
Acces la toate modelele Integrează modele de limbaj mari populare precum DeepSeek, Kimi, Qwen și GLM, astfel încât utilizatorul nu trebuie să schimbe platforma și poate apela liber diferite modele din același loc. Pentru aplicațiile care au nevoie de mai multe modele în același timp, aceasta elimină efortul de integrare repetată.
Suport pentru context de 1024K Oferă o capacitate de procesare a contextului de 1024K, potrivită pentru documente lungi, conversații cu mai multe runde și sarcini complexe de tip agent. Lungimea contextului determină cât de mult material poate fi procesat dintr-o dată și reprezintă o condiție preliminară pentru sarcinile bazate pe texte extinse.
Apelarea API-ului printr-un singur pas Fără configurare și fără instalare, gata de utilizare imediat după conectare. Dezvoltatorul nu trebuie să se ocupe de instalarea serviciului sau de configurarea mediului de rulare; este suficient să obțină cheia și să facă apeluri imediat.
Fără server GPU Modelele deja antrenate se folosesc prin apelarea API-urilor lor, fără necesitatea construirii unui server GPU propriu, ceea ce reduce costurile de hardware. Pentru dezvoltatorii independenți și echipele mici, acesta este de obicei punctul decisiv în alegere.
Optimizarea costurilor Oferă un mecanism de tarifare transparent, care facilitează echilibrul dintre performanță și cost. Costul unitar al unui apel diferă semnificativ între modele, iar prețurile clare ajută la controlul cheltuielilor totale.
Pașii de utilizare
- Înregistrare și autentificare: deschideți pagina principală a produsului și finalizați înregistrarea prin opțiunea de autentificare din colțul dreapta-sus al paginii.
- Vizualizarea modelelor: accesați pagina modelelor pentru a vedea lista modelelor acceptate și folosiți funcția de filtrare pentru a găsi detaliile unui anumit model.
- Reîncărcarea contului: în secțiunea „Informații utilizator”, selectați opțiunea de reîncărcare. Momentan este acceptată plata prin WeChat, iar suma minimă de reîncărcare este de 10 unități, folosite ulterior pentru apelarea modelelor.
- Crearea cheii API: pe pagina modelelor, alegeți modelul pe care doriți să îl configurați și creați o cheie API pentru acesta.
- Apelarea interfeței: folosiți cheia API creată pentru a apela modelul dorit prin interfața platformei și începeți activitatea de dezvoltare.
- Gestionarea consumului: estimați numărul de apeluri în funcție de proiect și alegeți modelul potrivit pe baza tarifelor, pentru a evita consumul inutil.
Pentru cine este potrivit
- Dezvoltatori independenți: cei care vor să acceseze rapid mai multe modele de limbaj mari, să simplifice procesul de dezvoltare și să reducă costurile de dezvoltare
- Echipe mici: echipe care vor să utilizeze eficient resurse limitate și să construiască și să implementeze rapid aplicații bazate pe modele de limbaj mari
- Creatori de conținut: precum redactori și producători de conținut, care folosesc AI pentru a spori eficiența și calitatea muncii creative
- Utilizatori companii: companii care vor să integreze capabilități AI în activitatea lor, fără să investească resurse importante în modele și infrastructură proprii
- Cercetători: persoane care au nevoie să apeleze flexibil la modele diferite pentru cercetare și experimente și să exploreze noi aplicații ale AI
- Studenți și educatori: pentru învățare și predare, precum și pentru explorarea aplicațiilor AI în domeniul educației
Limitări și atenționări
- Capacitățile și parametrii modelelor depind de versiunile efectiv puse la dispoziție de platformă; modelele diferă între ele prin calitatea rezultatelor, viteză și limitele de context.
- Interfața de agregare nu modifică calitatea rezultatului produs de model, așadar acuratețea pentru sarcinile importante trebuie evaluată și verificată în continuare de către utilizator.
- apelurile sunt facturate în funcție de consum; contextul lung și apelurile frecvente cresc semnificativ costurile, astfel încât estimarea se face în raport cu utilizarea reală.
- Cheia API este o credențială, trebuie păstrată în siguranță și nu trebuie expusă sau adăugată în depozite de cod publice.
- Este necesară o conexiune la internet și o dependență de disponibilitatea platformei; modificările serviciului sau defecțiunile pot afecta lanțul de apeluri.
- Metodele de reîncărcare și de plată, prețurile și promoțiile respectă regulile indicate pe pagina platformei, așa că este bine să verificați condițiile actuale înainte de utilizare.
Întrebări frecvente
Ce problemă rezolvă TokenPony?
TokenPony reunește modele de limbaj mari populare precum DeepSeek, Kimi, Qwen și GLM într-o singură interfață, astfel încât nu trebuie să comutați între platforme sau să integrați repetat aceleași modele. Platforma oferă și suport pentru context de 1024K, util pentru documente lungi, conversații cu mai multe runde și sarcini complexe de tip agent, fără să fie necesară construirea unui server GPU propriu, ceea ce reduce costurile de hardware.
Cum se apelează un model pe TokenPony?
Fluxul de bază este: vă înregistrați și vă autentificați, consultați pagina modelelor pentru a vedea modelele acceptate, efectuați o reîncărcare din secțiunea Informații utilizator, alegeți modelul dorit și creați o cheie API în pagina modelelor, apoi folosiți acea cheie pentru a apela modelul prin interfața platformei. Reîncărcarea este acceptată momentan prin WeChat, cu o sumă minimă de 10 unități.
La ce ar trebui să fiu atent când folosesc o platformă de agregare de API?
Sunt necesare câteva atenționări: modelele diferă între ele prin calitatea rezultatelor, viteză și limitele de context, iar interfața de agregare nu modifică calitatea rezultatului produs de model; apelurile se taxează în funcție de consum, deci contextul lung și apelurile frecvente cresc semnificativ costurile; cheia API este o credențială și nu trebuie pusă în depozite de cod publice. Sunt necesare și conexiune la internet și disponibilitatea platformei, iar prețurile și regulile respectă condițiile indicate pe pagina platformei.



