

PPIO Paiouyun — распределённая облачная платформа, которая собирает разрозненные GPU-ресурсы в единую вычислительную сеть: функции генеративного ИИ можно запускать через OpenAI-совместимые API или GPU-инстансы по требованию, а компании могут выбрать выделенный приватный кластер.
Что такое PPIO Paiouyun
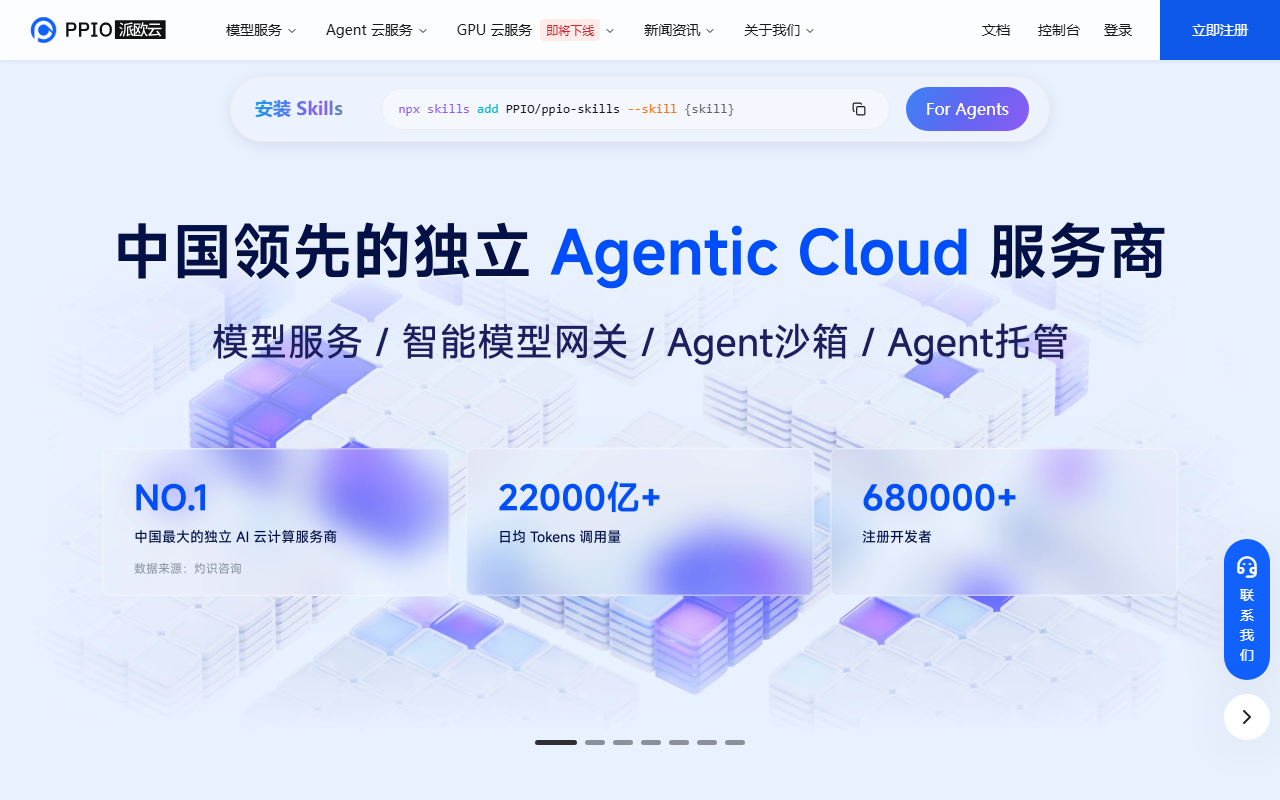
PPIO Paiouyun — поставщик распределённых облачных вычислений, который объединяет серверные мощности на периферии сети и в региональных дата-центрах в единую вычислительную сеть. Компания совмещает модель экономики совместного использования с технологиями больших данных, cloud native и распределённых вычислений, а затем отдаёт эти мощности в виде API для ИИ-инференса, GPU-инстансов и отраслевых решений. Основные направления — облако ИИ-инференса, аудио- и видеорешения, облачный рендеринг для метавселенных и приватное развёртывание для компаний. Официальный сайт продукта — ppio.cn.
В отличие от классического публичного облака, которое в основном перепродаёт виртуальные машины из собственных дата-центров, PPIO выступает агрегатором и планировщиком вычислений. С одной стороны, платформа собирает разнородные ресурсы: гипермасштабные дата-центры, региональные узлы и простаивающее оборудование. С другой — предоставляет их через единую консоль, общий API и собственный движок ускорения инференса. На платформе доступны и новые модели, например DeepSeek-R1-0528: их можно вызывать через API или пробовать прямо в каталоге моделей.
Основные возможности
API моделей
Платформа предлагает API больших языковых моделей, а также API генерации изображений и видео. Конечные точки соответствуют стандарту OpenAI API, поэтому в большинстве проектов миграция сводится к замене базового URL, ключа и имени модели — существующий код OpenAI SDK продолжает работать. Заявленная стабильность — до 99,9 %, поддерживается переключение между мультимодальными моделями за секунды с ускорением инференса, что полезно командам, которые сравнивают несколько моделей или совмещают текст и изображения в одном продукте.
GPU-облако
GPU-мощности поставляются в двух формах. GPU-контейнеры дают контейнеризованные ресурсы с оплатой по факту, готовыми образами и развёртыванием в один клик: подходят для обучения, дообучения и пакетного инференса, когда средой управляете вы. Serverless GPUs рассчитаны на собственные модели без эксплуатации инфраструктуры: автоматическое масштабирование, балансировка нагрузки и холодный старт за секунды — для онлайн-инференса с неравномерным трафиком.
Аудио- и видеорешения
Опираясь на широко распределённые периферийные узлы и опыт в медиа, это направление объединяет оборудование, сеть и медиатехнологии для длинного и короткого видео по запросу, развлекательных трансляций, видеозвонков и интерактивных стримов. Обещание — комплексный стек с высоким качеством, низкой стоимостью и стабильной доставкой.
Облачный рендеринг и метавселенные
Профессиональное графическое ПО с открытым кодом работает на периферийных вычислениях, а платформа автоматически разворачивает облачный рендеринг для приложений метавселенных, которым нужно удалённо считать ассеты или кадры.
Приватное развёртывание для компаний
Для организаций, которые не могут отдавать данные в общее облако, предусмотрен выделенный GPU-кластер с полностью управляемой эксплуатацией: стек обслуживания моделей остаётся в контролируемой компании среде, а повседневная эксплуатация — на стороне провайдера.
С чего начать
- Создайте аккаунт на официальном сайте по номеру телефона или имени учётной записи.
- Пройдите верификацию — личная или корпоративная проверка обязательна до включения вычислений и API.
- Пополните баланс на странице обзора аккаунта; поддерживаются Alipay, WeChat Pay и банковский перевод для юрлиц.
- Выпустите API-ключ в разделе управления ключами, если планируете вызывать API, и не храните его во фронтенд-коде или публичных репозиториях.
- Вызовите модель: откройте каталог, выберите карточку и запустите онлайн-тест с нужными параметрами. Для интеграции направьте OpenAI-совместимый клиент на конечную точку платформы, указав ключ и имя модели; код на Python обычно переносится без изменений.
- Запустите GPU: создайте контейнерные инстансы или serverless-развёртывания в консоли, выбрав спецификацию, образ или модель и правила масштабирования.
Где подходит
- Запуск продуктов генеративного ИИ: чат, работа с текстом, генерация изображений и видео без собственного инференс-кластера.
- Видео и трансляции: транскодирование и доставка для видео по запросу, развлекательных и интерактивных стримов.
- Пакетный рендеринг: кино, архитектурная визуализация, сцены метавселенных.
- Эластичные мощности: пики трафика или разовые задачи обучения с оплатой по факту.
- Беспилотники и научные расчёты: задачи с требованием низкой задержки, широкой полосы или массового параллелизма.
Ограничения и что проверить
- Цифры вроде 99,9 % стабильности, холодного старта за секунды и мгновенного переключения моделей — заявления поставщика; независимых замеров здесь не проводилось, поэтому перед выбором протестируйте на своём трафике.
- Оплата сочетает предоплату и оплату по факту, верификация обязательна. Точные цены, бесплатные квоты и скидки уточняются в консоли и у отдела продаж; в статье тарифы не приводятся.
- Каталог моделей меняется. Доступность DeepSeek-R1-0528 и других моделей проверяйте в каталоге на момент использования.
- Аудио- и видеорешения и приватное развёртывание — проекты для бизнеса с коммерческими переговорами, а не мгновенный self-service.
- API-ключи чувствительны: утечка приводит к реальным расходам, поэтому разделяйте ключи по проектам и регулярно меняйте.
Частые вопросы
Чем это отличается от GPU обычного публичного облака? Обычное публичное облако продаёт в основном инстансы из своих дата-центров. PPIO агрегирует разнородные периферийные и региональные мощности и предоставляет их через единый API и слой планирования: в одной консоли доступны GPU по факту, serverless-развёртывания и OpenAI-совместимые API. Такой набор подходит командам, которым сегодня нужен управляемый API, а завтра, возможно, собственный стек инференса.
Насколько трудоёмка миграция проекта, который уже использует OpenAI SDK? Обычно меняются три настройки: базовый URL, ключ и имя модели. Бизнес-логика остаётся прежней. Перед переключением трафика прогоните регрессию на стенде, включая потоковый вывод и вызов инструментов.
Нужен ли GPU-инстанс для небольшого эксперимента? Нет. Сначала протестируйте в каталоге моделей, затем вызывайте API по факту — это дешевле постоянно включённого инстанса. Переходите на GPU или serverless, когда понадобятся собственные модели, особые зависимости или предсказуемая задержка.
Может ли компания держать данные в своей среде? Да, через выделенный GPU-кластер с полностью управляемым приватным развёртыванием. Размер кластера, сетевая изоляция и сроки согласуются с отделом продаж.

Частые вопросы
Чем это отличается от GPU обычного публичного облака?
Публичное облако продаёт свои инстансы. PPIO агрегирует разнородные периферийные и региональные мощности и даёт их через единый API и планировщик: GPU по факту, serverless и OpenAI-совместимые API в одной консоли.
Насколько трудоёмка миграция проекта с OpenAI SDK?
Меняются базовый URL, ключ и имя модели; бизнес-логика остаётся. Перед переключением трафика прогоните регрессию со стримингом и вызовом инструментов.
Нужен ли GPU-инстанс для небольшого эксперимента?
Нет. Сначала каталог моделей и вызовы API по факту — дешевле постоянного инстанса. GPU или serverless нужны для своих моделей и предсказуемой задержки.
Может ли компания держать данные у себя?
Да, через выделенный GPU-кластер с полностью управляемым приватным развёртыванием; размер, изоляция сети и сроки согласуются с отделом продаж.



