

万象有声 เป็นแพลตฟอร์มสร้างคอนเทนต์เสียงด้วย AI ครบวงจรสำหรับอุตสาหกรรมเสียง พัฒนาโดยทีมงานหลักจาก “懒人听书” เดิม รองรับการผลิตคุณภาพสูงที่นักพากย์真人 ทำงานร่วมกับ AI และการผลิตจำนวนมากแบบ AI หลายเสียงอัตโนมัติ ช่วยลดระยะเวลาโปรเจกต์ขนาดใหญ่จากหลายสิบวันเหลือเพียงไม่กี่วัน
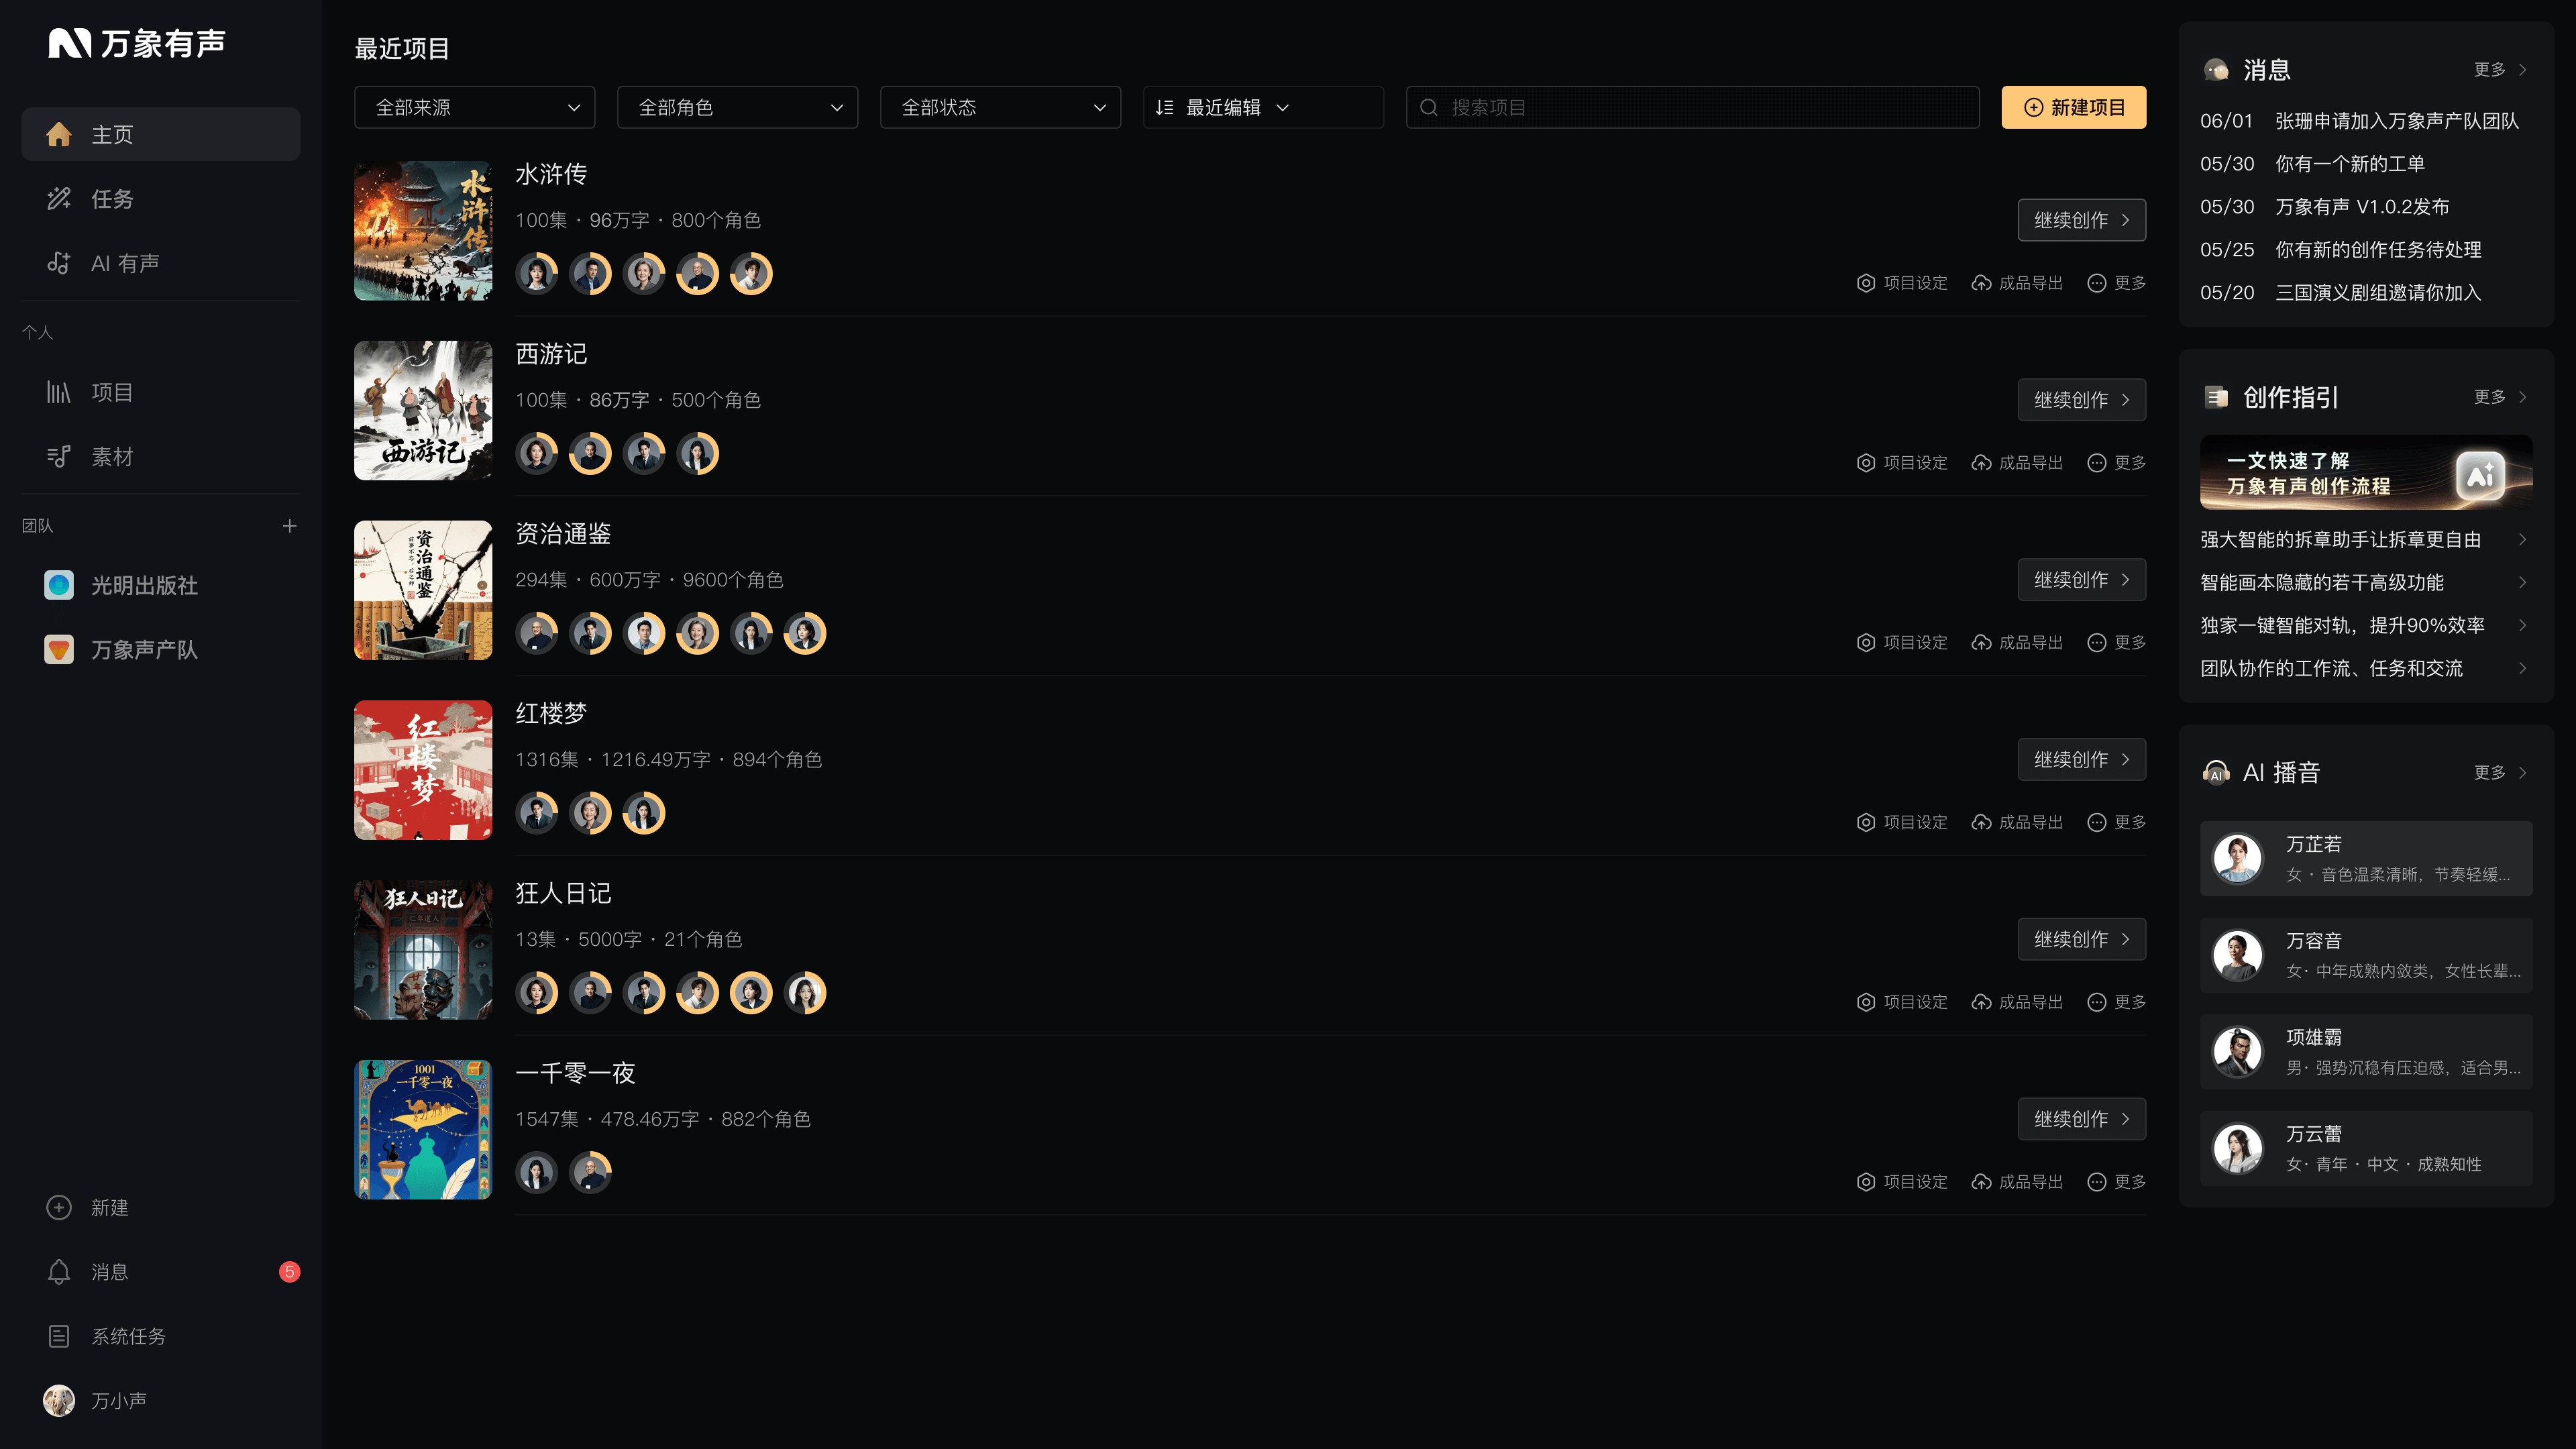
万象有声: แพลตฟอร์มสร้างคอนเทนต์เสียงด้วย AI ครบวงจร
万象有声 (Audimind) เป็นแพลตฟอร์มสร้างคอนเทนต์เสียงด้วย AI ครบวงจรสำหรับอุตสาหกรรมเสียง พัฒนาโดยทีมงานหลักจาก “懒人听书” เดิม เชื่อมต่อกระบวนการทั้งหมดตั้งแต่การแบ่งบท จัดทำสตอรีบอร์ด พากย์เสียง เอฟเฟกต์เสียง หลังการผลิต ตรวจสอบรับฟัง จนถึงการส่งออกผลงาน พร้อมด้วย “เอนจินสองระบบ” ที่รองรับทั้งการผลิตคุณภาพสูงและการผลิตจำนวนมาก
万象有声 คืออะไร?
万象有声 เป็นเครื่องมือสร้างคอนเทนต์เสียงระดับ SaaS ที่มีแนวคิด “ทำให้ทุกเรื่องราวกลายเป็นเสียงได้อย่างง่ายดาย” ข้อมูลจากทางการระบุว่าทีมงานมาจากทีมผู้บริหารหลักของ “懒人听书” เดิม ประกอบด้วยผู้ก่อตั้ง/CEO, VP ฝ่ายผลิตภัณฑ์, VP ฝ่ายเทคนิค และผู้อำนวยการฝ่ายผลิตเนื้อหา มีประสบการณ์ในอุตสาหกรรมเสียงมากกว่าสิบปี
หัวใจของแพลตฟอร์มคือ “เอนจินสองระบบ”:
- โหมดการผลิตคุณภาพสูง: นักพากย์真人 (CV) ทำงานร่วมกับ AI เหมาะกับละครเสียง หนังสือเสียงหลายผู้พากย์ และเนื้อหาที่ต้องการการแสดงสูง
- โหมดการผลิตจำนวนมากอัตโนมัติเต็มรูปแบบ: AI พากย์หลายเสียงสร้างอัตโนมัติ เหมาะกับหนังสือเสียงจำนวนมากและการแปลง IP นิยายออนไลน์เป็นเสียง
ทางการระบุว่าการออกแบบนี้ช่วยลดระยะเวลาโครงการขนาดใหญ่จากหลายสิบวันเหลือเพียงไม่กี่วัน
ฟีเจอร์หลัก
การแบ่งบทอัจฉริยะ
ระบบจดจำโครงสร้างข้อความอัตโนมัติ แบ่งบทอย่างชาญฉลาด รองรับการแบ่งใหม่ตามจำนวนคำและตั้งชื่อบท เพื่อจัดระเบียบเนื้อหายาวให้เป็นระบบ
เครื่องมือแก้ไขสตอรีบอร์ดอัจฉริยะ
จดจำบทบรรยายและบทสนทนาของตัวละครอัตโนมัติ สร้างสตอรีบอร์ดพากย์แบบภาพ ระบบยังจดจำตัวละครและสร้างประวัติตัวละครอัตโนมัติ ใส่แท็กอารมณ์ให้บทพูด และระบุการออกเสียงสำหรับอักษรยากและอักษรหลายเสียง ช่วยให้นักพากย์เข้าถึงบทบาทได้เร็วขึ้น
การพากย์ด้วย AI
- คลังเสียง AI สำเร็จรูปจำนวนมาก: เสียง AI มากกว่าพันเสียง หลากหลายเพศ อายุ และสไตล์
- การโคลนเสียง: สร้างเสียงเฉพาะด้วยตัวอย่างเสียง
- การปรับแต่งเสียง: สร้างเสียง AI ตามสไตล์ อายุ และเพศที่กำหนดผ่านคำอธิบายข้อความ
- AI แนะนำเสียงที่เหมาะสมที่สุดเป็นชุดตามโปรไฟล์ตัวละคร
เอฟเฟกต์เสียงและดนตรีด้วย AI
เพียงพิมพ์คำอธิบายเป็นข้อความ ระบบจะสร้างเสียงเอฟเฟกต์อย่างชาญฉลาด เช่น ตัวอย่างจากทางการ “บ่ายฤดูร้อน มีเสียงฟ้าร้องดังมาจากที่ไกล” สร้างเสียงเอฟเฟกต์ได้สูงสุด 20 วินาที ฟีเจอร์สร้างดนตรีประกอบจะเปิดตัวเร็ว ๆ นี้
เวิร์กสเตชันอัดและตัดต่อในตัวเดียว
ดูบทไปด้วย อัดไปด้วย ตัดต่อไปด้วย เส้นเวลาแสดงรูปคลื่นด้านล่างรองรับการตัดต่อละเอียด รองรับการตัดต่อหลายแทร็ก ลดเสียงรบกวน เฟดเข้า-ออก และเอฟเฟกต์ตามฉาก เช่น เสียงโทรศัพท์หรือเสียงก้อง
การซิงก์เสียงอัจฉริยะ
อัปโหลดเสียงดิบยาวที่บันทึกจากซอฟต์แวร์มืออาชีพ ระบบจะจดจำเสียงพูด ตัดแบ่ง และจับคู่เข้ากับบทพูดแต่ละประโยคในสตอรีบอร์ดอย่างแม่นยำ ทางการระบุว่าการซิงก์และตรวจรับฟังลดจากหลายชั่วโมงเหลือเพียงไม่กี่นาที และเพิ่มประสิทธิภาพงานหลังการผลิตได้ 90%
การตรวจรับฟังอัจฉริยะ
AI เปรียบเทียบเนื้อหาเสียงกับต้นฉบับทีละตัวอักษร ทำเครื่องหมายปัญหา “อ่านขาด อ่านเกิน” และตรวจทานเสียงพากย์กับบทสตอรีบอร์ดอัตโนมัติ
การจัดการผลงานและการส่งออก
จัดการผลงานครบวงจรในที่เดียว รองรับการส่งออกจำนวนมากผ่าน API และเชื่อมต่อระบบ ERP
การทำงานร่วมกันเป็นทีม
รองรับการสลับหลายทีม มอบหมายงาน แจ้งเตือนข้อความ และจัดการสิทธิ์สมาชิก เหมาะกับการทำงานร่วมกันของทีมผลิตขนาดใหญ่
ความปลอดภัยด้านลิขสิทธิ์
มีระบบบล็อกเนื้อหาละเอียดอ่อนและบันทึกหลักฐานบนบล็อกเชน ช่วยลดความเสี่ยงละเมิดลิขสิทธิ์ แพลตฟอร์มถือใบอนุญาตประกอบกิจการผลิตและจำหน่ายรายการวิทยุโทรทัศน์ เลขที่ (粤)字第07504号
ขั้นตอนการใช้งาน
- สมัครและเข้าสู่ระบบ: เข้าชมเว็บไซต์ทางการ https://www.audimind.com/ เพื่อสมัครบัญชี แพ็กเกจฟรีแจกเวลาใช้ AI พากย์เสียงวันละ 30 นาที
- สร้างโปรเจกต์ใหม่: คลิก “สร้างโปรเจกต์ใหม่” นำเข้าบทความหรือสร้างโปรเจกต์เปล่า ตั้งชื่อโปรเจกต์และข้อมูลพื้นฐาน
- แบ่งบทอัจฉริยะ: ใช้ตัวช่วยแบ่งบทเพื่อจดจำโครงสร้างข้อความอัตโนมัติ แบ่งเนื้อหายาวเป็นบทและตอน
- เข้าสู่การแก้ไขสตอรีบอร์ด: ระบบจดจำบทบรรยายและบทสนทนาตัวละครอัตโนมัติ สร้างสตอรีบอร์ดพากย์ภาพ ปรับตัวละครและบทพูดเองได้
- กำหนดเสียงพากย์: เลือกเสียงจากคลัง AI หรือใช้การโคลนเสียง/ปรับแต่งเสียงเพื่อสร้างเสียงเฉพาะ
- สร้าง/บันทึกเสียงพากย์: โหมด AI สร้างเสียงอัตโนมัติ ส่วนโหมด真人 ดูบทไปด้วยบันทึกไปด้วย อัดและตัดต่อครบในตัวเดียวเพื่อเก็บเสียงดิบ
- ซิงก์เสียงอัจฉริยะ: อัปโหลดเสียงดิบแล้วใช้ระบบซิงก์อัตโนมัติในคลิกเดียว จัดตำแหน่งเสียงกับบทพูดในระดับมิลลิวินาที
- เพิ่มเอฟเฟกต์เสียงและดนตรี: สร้างเสียงเอฟเฟกต์ด้วย AI เพิ่มเสียงบรรยากาศตามฉาก (ดนตรีประกอบจะเปิดตัวเร็ว ๆ นี้)
- ทีมตรวจรับฟัง: เชิญสมาชิกทีมตรวจรับฟังผ่านคลาวด์ ให้ความเห็นออนไลน์
- ส่งออกผลงาน: เมื่อตรวจสอบเรียบร้อยแล้ว ส่งออกไฟล์เสียงผลงาน รองรับหลายรูปแบบและเชื่อมต่อ API แบบเป็นชุด
สถานการณ์การใช้งาน
- การผลิตหนังสือเสียง: แปลงนวนิยายยาว วรรณกรรมคลาสสิก (เช่น 《红楼梦》《水浒传》) เป็นหนังสือเสียงอย่างรวดเร็ว รองรับทั้งการเล่าเดี่ยวและละครเสียงหลายผู้พากย์
- ละครเสียง/หนังสือเสียงหลายผู้พากย์: AI พากย์หลายตัวละครทำงานร่วมกับนักพากย์真人 รองรับโปรเจกต์ขนาดใหญ่ที่มีตัวละครหลายพันตัว
- แปลง IP นิยายออนไลน์เป็นเสียง: ครอบคลุม IP ระดับกลาง-เล็กจำนวนมาก ลดต้นทุนการผลิตต่อเรื่อง
- คอร์สความรู้และคอร์สเรียน: ให้เสียงบรรยายทุ้มน่าฟังสำหรับการอธิบายความรู้และการอบรม รองรับการผลิตคอร์สเสียงยาว
- เสียงพากย์วิดีโอสั้นและสื่อส่วนตัว: ใช้ฟีเจอร์สร้างเสียงสั้นเพื่อผลิตเสียงพากย์คุณภาพสูงอย่างรวดเร็ว
- งานประชาสัมพันธ์และโฆษณาองค์กร: ปรับแต่งเสียงให้เข้ากับบุคลิกแบรนด์
จุดเด่น
- ครบวงจรในที่เดียว: แบ่งบท สตอรีบอร์ด พากย์เสียง เอฟเฟกต์เสียง หลังการผลิต ตรวจรับฟัง ส่งออก อยู่ในแพลตฟอร์มเดียว ไม่ต้องสลับเครื่องมือหลายตัว
- เพิ่มประสิทธิภาพ: ทางการระบุว่าระบบซิงก์อัจฉริยะเพิ่มประสิทธิภาพงานหลังการผลิต 90% และลดระยะเวลาโปรเจกต์จาก 30 วันเหลือ 5–7 วัน
- ได้เปรียบด้านต้นทุน: ในโหมดผลิตจำนวนมากด้วย AI ล้วน ต้นทุนการผลิตต่อชั่วโมงลดลงประมาณ 70%
- จัดการตัวละครขนาดใหญ่: รองรับตัวละครหลายพันตัว เช่น โปรเจกต์ที่ซับซ้อน 《资治通鉴》 ที่มี 9,600 ตัวละคร
- เทคโนโลยี AI ขั้นสูง: พจนานุกรมการออกเสียงระดับล้านรายการช่วยแก้ปัญหาอักษรยาก โมเดลอารมณ์และจังหวะทำเสียง AI ให้สมจริง เทคโนโลยีวาดใหม่อัจฉริยะลดต้นทุนประมวลผล 90%
- ระบบเสียงหลากหลาย: คลังเสียงสำเร็จรูปจำนวนมาก + การโคลนเสียง + การปรับแต่งเสียง
ข้อจำกัดและสิ่งที่ควรทราบ
จากข้อมูลสาธารณะ 万象有声 ยังมีจุดที่ควรระวัง:
- แพ็กเกจฟรีให้เวลาใช้ AI พากย์เสียงเพียงวันละ 30 นาที สำหรับส่วนเกินโปรดดูหลักเกณฑ์จากเว็บไซต์ทางการ
- เสียงเอฟเฟกต์จาก AI ยาวสูงสุด 20 วินาที ความต้องการเสียงที่ยาวหรือซับซ้อนกว่านี้อาจถูกจำกัด
- ฟีเจอร์ดนตรีประกอบกำลังจะเปิดตัว อาจยังใช้ไม่ได้ในตอนนี้
- ความพร้อมใช้งานของฟีเจอร์ ราคา และเงื่อนไขสิทธิ์เชิงพาณิชย์อาจเปลี่ยนตามเวอร์ชัน โปรดอ้างอิงข้อมูลล่าสุดจากเว็บไซต์ทางการ
คำแนะนำในการตรวจสอบราคา
บทความนี้ไม่ระบุราคาเจาะจง เนื่องจากราคา แพ็กเกจ และโควตาฟรีเป็นข้อมูลที่เปลี่ยนแปลงได้ ควรเข้าเว็บไซต์ทางการ https://www.audimind.com/ เพื่อดูราคาล่าสุด เงื่อนไขแพ็กเกจฟรี และข้อกำหนดบริการ API
ทางเลือกอื่น
ข้อมูลสาธารณะไม่ได้ระบุคู่แข่งประเภทเดียวกันที่เฉพาะเจาะจงของ 万象有声 ทางการเน้นว่า “เอนจินสองระบบ” และการครบวงจรคือจุดต่าง หากต้องการเปรียบเทียบเครื่องมืออื่น แนะนำให้ประเมินตามความต้องการที่ต่างกัน เช่น หนังสือเสียง ละครเสียง เสียงพากย์วิดีโอสั้น โดยดูจำนวนเสียง การจัดการตัวละคร ประสิทธิภาพการซิงก์ การทำงานเป็นทีม และการส่งออกเป็นชุด
คำถามที่พบบ่อย (FAQ)
万象有声 คืออะไร?
万象有声 เป็นแพลตฟอร์มสร้างคอนเทนต์เสียงด้วย AI ครบวงจรสำหรับอุตสาหกรรมเสียง พัฒนาโดยทีมงานหลักจาก “懒人听书” เดิม ครอบคลุมตั้งแต่การแบ่งบท สตอรีบอร์ด พากย์เสียง เอฟเฟกต์เสียง หลังการผลิต ตรวจรับฟัง จนถึงการส่งออก
万象有声 รองรับการพากย์เสียง真人 และ AI ผสมกันหรือไม่?
รองรับ “เอนจินสองระบบ” รองรับทั้งการผลิตคุณภาพสูงที่นักพากย์真人 ทำงานร่วมกับ AI และการผลิตจำนวนมากแบบ AI หลายเสียงอัตโนมัติ เวิร์กสเตชันอัดและตัดต่อในตัวเดียวกับระบบซิงก์อัจฉริยะช่วยให้การบันทึก真人 และงานหลังการผลิตด้วย AI ผสานกันอย่างมีประสิทธิภาพ
แพ็กเกจฟรีของ 万象有声 ใช้ได้นานเท่าใด?
แพ็กเกจฟรีแจกเวลาใช้ AI พากย์เสียงวันละ 30 นาที หากเกินต้องดูหลักเกณฑ์การคิดค่าบริการหรือโควตาจากทางการ โดยยึดตามข้อมูลจากเว็บไซต์ทางการ
万象有声 รองรับโปรเจกต์ขนาดใหญ่ที่มีตัวละครได้กี่ตัว?
ทางการระบุว่ารองรับโปรเจกต์ซับซ้อนที่มีตัวละครหลายพันตัว และยกตัวอย่าง 《资治通鉴》 ที่มี 9,600 ตัวละคร ระบบจัดสรรและจัดการบทพูดอย่างเป็นระบบ
ระบบ AI สร้างเอฟเฟกต์เสียงของ 万象有声 สร้างได้ยาวแค่ไหน?
เสียงเอฟเฟกต์ที่สร้างจากคำอธิบายข้อความยาวสูงสุด 20 วินาที ฟีเจอร์ดนตรีประกอบกำลังจะเปิดตัว
บทสรุป
万象有声 (Audimind) พัฒนาโดยทีมงานหลักจาก 懒人听书 เดิม วางตำแหน่งเป็นแพลตฟอร์มสร้างคอนเทนต์เสียงรุ่นใหม่ ด้วยระบบครบวงจร “เอนจินสองระบบ” และคลังเสียง AI หลากหลาย ช่วยให้ครีเอเตอร์รายบุคคลและหน่วยงานมืออาชีพแปลงข้อความเป็นผลงานเสียงคุณภาพสูงได้มีประสิทธิภาพยิ่งขึ้น หากต้องการข้อมูลเพิ่มเติม แนะนำให้เข้าเว็บไซต์ทางการเพื่อทดลองใช้งาน
คำถามที่พบบ่อย
万象有声 คืออะไร?
万象有声 เป็นแพลตฟอร์มสร้างคอนเทนต์เสียงด้วย AI ครบวงจรสำหรับอุตสาหกรรมเสียง พัฒนาโดยทีมงานหลักจาก “懒人听书” เดิม ครอบคลุมตั้งแต่การแบ่งบท สตอรีบอร์ด พากย์เสียง เอฟเฟกต์เสียง หลังการผลิต ตรวจรับฟัง จนถึงการส่งออก
万象有声 รองรับการพากย์เสียง真人 และ AI ผสมกันหรือไม่?
รองรับ “เอนจินสองระบบ” รองรับทั้งการผลิตคุณภาพสูงที่นักพากย์真人 ทำงานร่วมกับ AI และการผลิตจำนวนมากแบบ AI หลายเสียงอัตโนมัติ เวิร์กสเตชันอัดและตัดต่อในตัวเดียวกับระบบซิงก์อัจฉริยะช่วยให้การบันทึก真人 และงานหลังการผลิตด้วย AI ผสานกันอย่างมีประสิทธิภาพ
แพ็กเกจฟรีของ 万象有声 ใช้ได้นานเท่าใด?
แพ็กเกจฟรีแจกเวลาใช้ AI พากย์เสียงวันละ 30 นาที หากเกินต้องดูหลักเกณฑ์การคิดค่าบริการหรือโควตาจากทางการ โดยยึดตามข้อมูลจากเว็บไซต์ทางการ
万象有声 รองรับโปรเจกต์ขนาดใหญ่ที่มีตัวละครได้กี่ตัว?
ทางการระบุว่ารองรับโปรเจกต์ซับซ้อนที่มีตัวละครหลายพันตัว และยกตัวอย่าง 《资治通鉴》 ที่มี 9,600 ตัวละคร ระบบจัดสรรและจัดการบทพูดอย่างเป็นระบบ
ระบบ AI สร้างเอฟเฟกต์เสียงของ 万象有声 สร้างได้ยาวแค่ไหน?
เสียงเอฟเฟกต์ที่สร้างจากคำอธิบายข้อความยาวสูงสุด 20 วินาที ฟีเจอร์ดนตรีประกอบกำลังจะเปิดตัว



