OhYesAI 是一个让用户通过上传音频或输入自然语言生成原创歌曲,并自动完成分镜规划、音画卡点与视频渲染,一键生成最长 5 分钟电影级 MV 的 AI 音乐 MV 创作平台。
产品定位
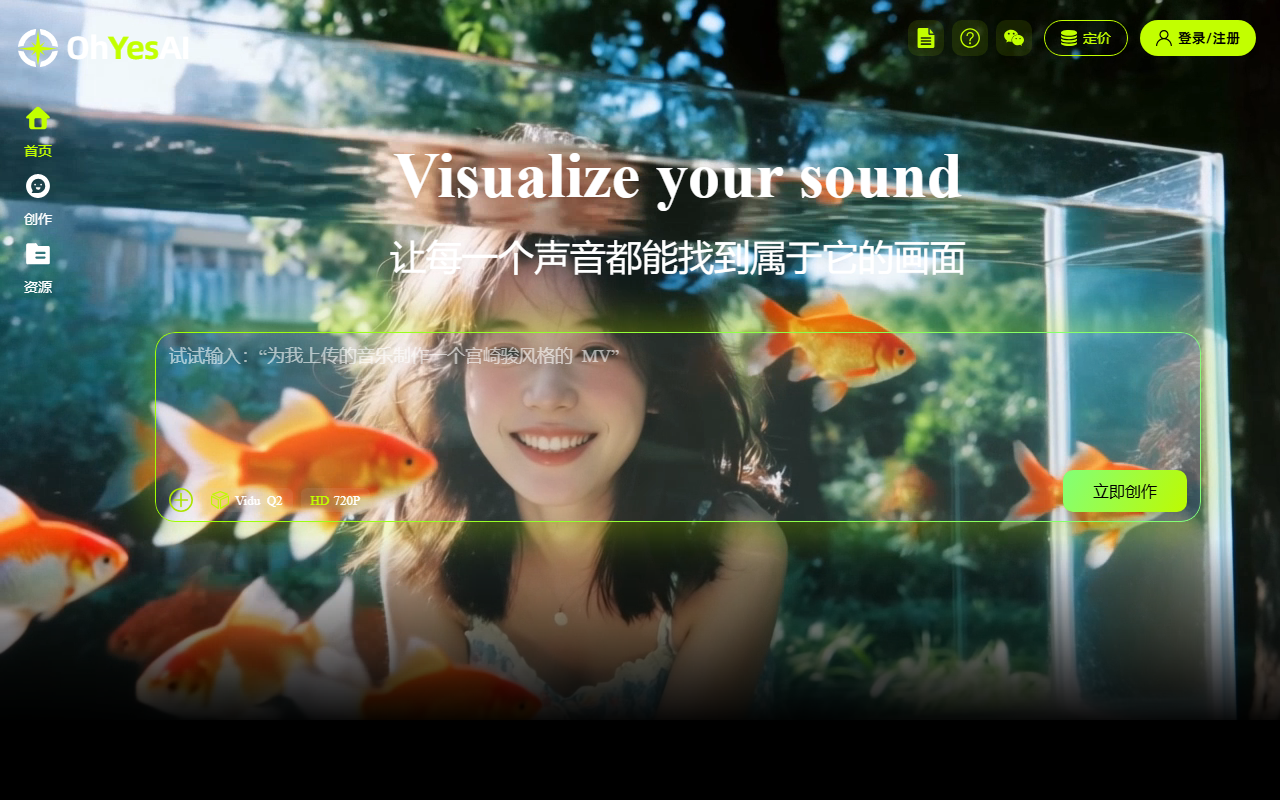
OhYesAI 是专注于 AI 音乐 MV 创作的音视一体化智能体平台,致力于让每一个声音找到属于它的画面。对于独立音乐人、自媒体创作者或普通用户而言,不需要任何剪辑或乐理基础,即可通过对话式交互精准控制视觉风格、角色形象与分镜细节,实现从零到成片的无门槛创作。
核心功能
OhYesAI 平台提供了一系列强大的音视创作能力:
- AI 原创音乐生成:输入主题、情绪与风格描述,AI 自动生成完整歌曲与歌词,支持流行、摇滚、电子、R&B 等多流派,可一键衔接到 MV 创作流程。
- 音频驱动 MV 生成:支持上传 MP3/WAV/M4A 等格式音频,AI 自动解析节奏、情绪与歌词,生成与音乐节拍高度契合的高清视觉画面。
- 多模型自由切换:接入 Vidu Q2、Kling V3 Omni Pro、Seedance 2.0 等主流视频生成模型,用户可按画质与速度需求随时切换,甚至针对单镜头独立更换模型。
- 智能分镜规划与编辑:系统自动拆解音乐节奏生成带时间戳的分镜脚本,支持单镜头替换、重绘、时长调整与提示词精修,实现完全可控的精细化创作。
- 参考图角色固定:支持上传 1-6 张人物、服装、场景或道具参考图,确保 MV 中主角形象与视觉风格在多镜头间保持一致。
- 毫秒级音画同步:独家算法精准解析 BPM 与音频波形,画面转场、镜头律动与鼓点节拍自动对齐,误差控制在毫秒级。
- 歌词字幕与智能口型:自动生成并嵌入歌词字幕,支持免费时间轴校准;含人物正面镜头时可开启智能口型同步,让人物口型与歌词精准匹配。
- 对话式协同创作:全程自然语言交互,既能通过文字生成音乐与画面,也能直接下达“把第 8 个分镜移到第 9 位”等剪辑指令。
- 5 分钟完整叙事能力:突破短视频限制,支持生成最长 5 分钟的高清 MV 成片,能够完整讲述一首歌曲的视觉故事。
使用步骤
- 访问平台:访问 OhYesAI 官网 https://ohyesai.com/ ,注册或登录账号。
- 选定视频模型与画布:在会话界面左下角切换生成模型(Vidu Q2、Kling V3 Omni Pro、Seedance 2.0 等),在对话框发送指令设定画面比例(16:9 横屏或 9:16 竖屏)。
- 准备音乐素材:选择“本地上传”导入 MP3/WAV/M4A 音频(最长 6 分钟),或在对话框输入需求让 AI 生成原创歌曲,从中挑选一版进入 MV 制作。
- 上传主体参考图(可选):上传 1-6 张图片固定人物、服装、场景或道具,确保单张图片仅有一人且面部清晰;无图也可直接通过文字描述生成。
- 确立视觉风格:在对话框发送风格提示词,如“动漫风格”、“写实风格”或“唯美梦幻”,让 AI 明确画面基调。
- 确认主体与场景设计:系统根据音乐、参考图与提示词渲染视觉参考图,可放大查看并编辑不满意的部分,满意后发送“确认并继续”。
- 审阅并修改分镜脚本:系统按音乐节奏与歌词自动生成带时间戳的分镜描述(此步骤不消耗积分),直接在对话框提修改要求或点击分镜框编辑,确认后发送“确认并生成”。
- 逐镜审阅与精修:分镜视频生成后,可在对话框快速下指令调整,或点击“编辑分镜”弹窗进行提示词改写、更换参考图、甚至单独切换更强大的模型重绘单镜头。
- 添加字幕与口型同步:导出前开启“歌词字幕”自动嵌入歌词,若时间轴未对齐可让 AI 免费重新校准;含人物正面唱歌镜头时可开启“智能口型同步”。
- 一键成片与下载:渲染完成后点击右上角“下载”保存视频,所有作品可在侧边栏【资源】版块查看并分享给好友。
适用场景
- 独立音乐宣发与 Demo 预热:独立音乐人、原创歌手可为新歌快速制作高质量预热 MV 或视觉化专辑封面。
- 短视频与自媒体批量生产:抖音、B 站、小红书等平台的创作者可将音乐、卡点视频、小说推文有声内容一键转化为匹配节奏的视觉画面。
- 品牌广告与营销宣传片:品牌方可将产品宣传文案或主题音乐转化为电影级视觉短片,用于电商详情页、社交媒体广告投放或发布会暖场视频。
- 教育与知识科普可视化:教育机构、科普博主可将儿歌、历史故事、科学原理讲解音频转化为动画 MV 或卡通风格短片。
- 游戏与虚拟偶像内容:游戏厂商可为角色主题曲、版本更新 PV 制作专属 MV;虚拟偶像运营团队也可快速生成对口型、卡节拍的表演视频。
- 直播与舞台背景:主播、DJ、线下演出团队可将实时音频或 Set 列表转化为动态视觉背景,替代传统 VJ 操作,实现音画同步的沉浸式舞台效果。
优点
OhYesAI 提供了一键化全流程生成,上传音频或 AI 生成歌曲后,系统自动完成从分镜规划、音画同步到高清渲染的全流程,无需手动剪辑即可直接出片。依托独家音画同步算法,确保画面转场、镜头律动与鼓点节拍高度吻合,实现专业级卡点效果。此外,精细化分镜可控编辑支持单镜头替换、重绘、提示词精修与时长调整,避免废片产生,创作完全可控。系统自动生成带时间戳的分镜脚本且不消耗积分,为用户降低了试错成本。
局限
根据公开事实表,OhYesAI 依托自研算法与接入的第三方主流视频生成模型(如 Vidu Q2、Kling V3 Omni Pro、Seedance 2.0 等)共同完成创作全流程,不同模型在画质、生成速度、成本上存在差异,用户可根据自身需求权衡切换。关于“类似于OhYesAI的工具”的同类竞品具体信息,公开事实表暂未提供详细的替代方案名称。
价格核验提示
现有公开资料仅明确审阅分镜脚本步骤不消耗积分,未覆盖平台完整资费规则。相关动态信息请读者务必前往 OhYesAI 官网(https://ohyesai.com/ )进行复核,以获取最准确的资费标准。
官网及一手资料
- 产品官网:https://ohyesai.com/
常见问题
OhYesAI 支持多长的音频或视频生成?
OhYesAI 支持本地上传最长 6 分钟的音频,并突破短视频限制,支持生成最长 5 分钟的高清 MV 成片,能够完整讲述一首歌曲的视觉故事。
使用 OhYesAI 创作需要视频剪辑基础吗?
不需要任何剪辑或乐理基础。OhYesAI 支持对话式协同创作,用户全程通过自然语言交互,既能生成音乐与画面,也能精准执行具体的剪辑指令,实现从零到成片的无门槛创作。
OhYesAI 支持哪些视频生成模型?
平台接入了 Vidu Q2、Kling V3 Omni Pro、Seedance 2.0 等行业顶尖视频生成模型,用户可按画质、速度与成本需求随时切换,甚至针对单镜头独立更换模型。
如何确保 MV 中的人物形象在多个镜头中保持一致?
OhYesAI 支持参考图角色固定功能。用户可上传 1-6 张人物、服装、场景或道具参考图(确保单张图片仅有一人且面部清晰),系统将配合 AI 智能规划,确保主角形象在多镜头间保持高度统一。