

数眼智能AI提供三类可以直接调用的数据接口:传入URL返回结构化Markdown或JSON的网页解析、覆盖多领域数据源的联网搜索、以及把PDF和扫描件转成层级化文本的文档OCR。它同时提供模型广场做多模型聚合调用,并已上架Dify、Coze等平台。新用户有500次免费调用额度,接口为标准化REST,支持私有化部署。厂商宣称平均响应低于1秒、价格约为同行三分之一,这些指标属于官方口径,实际情况需自行压测验证。
数眼智能AI:给大模型补上网页解析、联网搜索与文档OCR的数据管线
做Agent的人迟早会撞上同一堵墙:模型本身够聪明,但它看不见你要它看的那一页。要么知识停在训练截止日,要么HTML里塞满广告和导航栏,要么关键资料躺在一份扫描版PDF里。数眼智能AI切的就是这一段——它不做模型,卖的是把外部世界整理成模型能吃的形状这条管线。判断它值不值得接入,关键看三件事:解析出来的是不是干净的结构化数据,搜索能不能回到可核验的来源,以及在你需要的并发下响应还能不能稳住。
按官方定位,数眼智能AI是“大模型时代的智能数据基建服务商”,技术路线写的是“视觉+代码”双模态:一边用计算机视觉理解页面渲染后的样子,一边用代码逻辑抽取结构,两条路互相校验。这个组合针对的是传统爬虫的两个软肋——前端动态渲染的页面抓不到,以及复杂布局下选择器一改就崩。厂商称其自研系统覆盖300多个领域、数亿级结构化数据源,并会过滤广告干扰。
产品线可以分成三层:底层是网页解析、联网搜索、文档OCR三类数据接口;中间是模型广场,做多模型聚合调用、智能体对话、深度研究和MCP工作流集成;外围还有数据集服务和BI数据分析平台。对多数团队来说,真正会用到的往往只是最底层的两三个接口,其余部分属于同一家供应商的延伸能力,按需评估即可。
核心能力拆解
网页解析:把渲染后的页面还原成模型能读的文本
传入目标URL,接口返回结构化的Markdown或JSON。它的价值不在于“能抓”,而在于抓完之后不用你再写清洗规则:正文、标题层级、表格尽量保留,广告与导航被剔除。对RAG流水线来说,这一步决定了切片质量和召回质量——脏数据进去,检索出来的东西再相似也没用。官方说明支持动态渲染页面与复杂布局,这也是视觉解析相对纯DOM解析的意义所在。
联网搜索:给Agent一层可追溯到来源的检索
搜索接口面向大模型设计,返回的不只是链接列表,而是经过相关性评分和结构化处理的内容片段。官方称数据源覆盖新闻、百科、学术、媒体平台等,依托近百亿级网页与自建站点档案库做实时更新。做深度研究类应用时,这套能力的差别体现在“参考网页数”上——厂商称其深度研究模式参考网页数是普通搜索的7倍,这意味着更长的上下文和更多的交叉验证机会。
文档OCR:PDF与扫描件的层级化输出
上传PDF或扫描件,OCR引擎提取文字、表格、公式,输出带层级结构的Markdown与JSON。难点从来不是识别单个字,而是还原文档的组织关系:哪一行是标题、哪张表跨了几页、公式里哪个符号是上下标。层级化输出对下游很关键,因为知识库需要靠标题层级切块,丢了层级就只能按固定字数硬切。
模型广场与MCP:把模型调用和数据注入放进同一层
模型广场做的是多模型聚合:一个入口对接多家大模型,统一计费与返回格式,开发者不用自己维护多套部署。MCP集成则让网页搜索和内容解析以标准化接口注入AI工作流,对已经在用MCP协议的团队来说,这比重写一套工具调用逻辑省事得多。两类能力叠在一起的实际意义是:数据侧和模型侧可以在同一处配置,减少跨服务拼接的出错面。
怎么接入
- 到官网注册账号并获取API Key。官方说明新用户有500次免费调用额度,足够把三类接口各跑通一遍再决定是否付费。
- 先用网页解析接口验证你最在意的那些页面。挑10到20个真实目标URL(包含动态渲染、复杂表格、长文分页的情况),看返回的Markdown是否保留了你要的结构,别只看官方示例页。
- 接文档OCR时准备一批边界样本:双栏排版、跨页表格、含公式的扫描件。层级结构错乱通常出现在这类样本上,早发现比上线后发现便宜。
- 如果已经在用Dify或Coze,可以直接在智能体工作流里挂载,不必自己写服务端;要自己集成则按标准REST调用,返回格式选Markdown便于人工抽查,选JSON便于程序解析。
- 对政务、金融等强合规场景,官方支持高并发私有化部署,但具体交付形态、部署周期与费用来源未披露,需要走商务沟通确认。
定价与额度
- 新用户注册后有500次免费调用额度,这是唯一公开的明确数字,适合做小规模验证,不足以支撑生产流量。
- 计费方式为按token精确计费,厂商称价格约为同行的三分之一,且只对成功调用收费。只对成功调用收费这一条在解析类服务里值得关注,因为网页解析的失败率天然高于普通文本接口。
- 各接口的具体单价、阶梯折扣、私有化部署报价、超出额度后的结算方式,来源均未披露,需要在控制台或商务渠道确认。
适合谁用
- 在Dify、Coze等平台上搭建Agent的开发者:需要给智能体补上实时网页读取和搜索能力,又不想自己维护爬虫与代理池。
- 做RAG知识库的团队:内部资料大量以PDF、扫描件形式存在,需要先把非结构化文档变成可切块的层级文本。
- 内容聚合与电商比价类应用:需要持续抓取并清洗全网商品与资讯,且对广告噪音敏感。
- 金融、政务等强合规行业的技术团队:需要私有化部署与数据不出域,同时保留联网检索能力。
限制与注意事项
- 性能数字全部来自厂商口径。“平均响应小于1秒”“比行业快40%”“错误率低于0.01%”“价格仅为同行三分之一”均无第三方基准,也没有说明测试集与页面类型,选型时应按自己的目标站点实测。
- 定价透明度有限。除500次免费额度外,各接口单价、并发上限、限流策略、失败重试是否计费均未在公开资料中说明。
- 数据合规细节未披露。网页解析与搜索涉及第三方内容抓取,版权边界、robots遵循策略、抓取内容的存储期限与使用范围,需要向官方书面确认,尤其是要做内容再分发的场景。
- 多语种解析效果未说明。官方强调“精准处理复杂中文场景”,这对中文站点是优势,但如果你的目标页面以其他语言为主,效果需要单独验证。
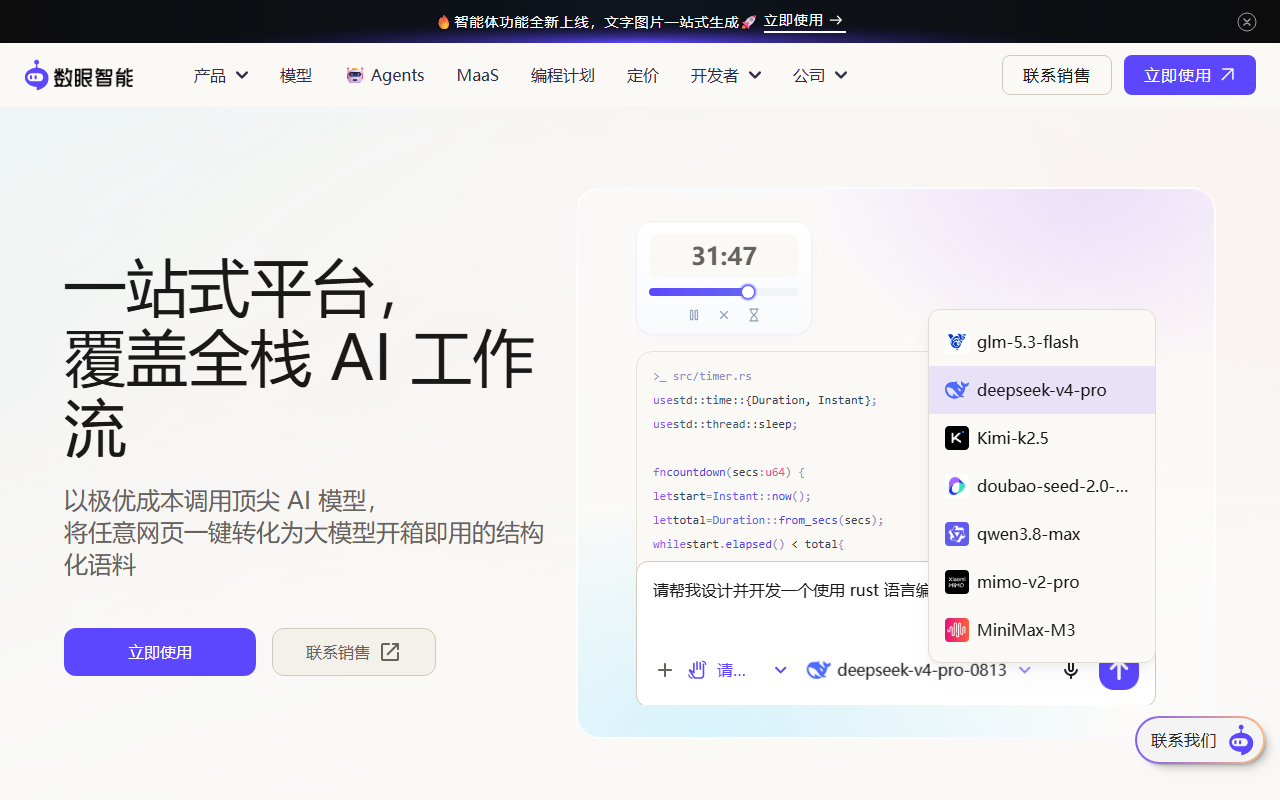
- 本次可确认的媒体素材只有一张官网截图,公开页未提供产品界面细节图,因此本文不插图;界面与实际返回样例请以官方控制台为准。
常见问题
数眼智能AI是模型本身吗?
不是。它是数据接口与模型聚合层,自己不训练大模型,卖的是网页解析、联网搜索、文档OCR三类数据能力,以及一个可以调用多家模型的模型广场。你仍然需要自己选定底层模型。
和直接写爬虫相比优势在哪?
主要差在维护成本。自建爬虫要处理动态渲染、反爬、选择器失效和正文清洗,页面改版一次就可能全线崩。托管接口把这些工作转移到服务方,代价是单价和可控性——你对抽取规则的控制会变弱,遇到特殊页面时调整空间有限。
能直接接到Dify或Coze里吗?
官方称已上架这两个平台,可以在智能体工作流中配置使用。具体插件名与配置步骤以平台内的实际列表为准,本文不代为确认。
免费额度用完之后怎么办?
官方未公开超出额度后的结算规则与单价。稳妥做法是先用500次额度跑完验证,再向官方询价并确认是否只对成功调用计费,避免按调用次数估算成本时出现偏差。
常见问题
数眼智能AI是模型本身吗?
不是。它是数据接口与模型聚合层,自己不训练大模型,卖的是网页解析、联网搜索、文档OCR三类数据能力,以及一个可以调用多家模型的模型广场。你仍然需要自己选定底层模型。
和直接写爬虫相比优势在哪?
主要差在维护成本。自建爬虫要处理动态渲染、反爬、选择器失效和正文清洗,页面改版一次就可能全线崩。托管接口把这些工作转移到服务方,代价是单价和可控性——你对抽取规则的控制会变弱,遇到特殊页面时调整空间有限。
能直接接到Dify或Coze里吗?
官方称已上架这两个平台,可以在智能体工作流中配置使用。具体插件名与配置步骤以平台内的实际列表为准,本文不代为确认。
免费额度用完之后怎么办?
官方未公开超出额度后的结算规则与单价。稳妥做法是先用500次额度跑完验证,再向官方询价并确认是否只对成功调用计费,避免按调用次数估算成本时出现偏差。



