

小马算力 适合需要同时使用多个大模型、不想自建GPU服务器、希望用统一接口简化接入流程的个人开发者、小型团队、企业用户与研究人员。
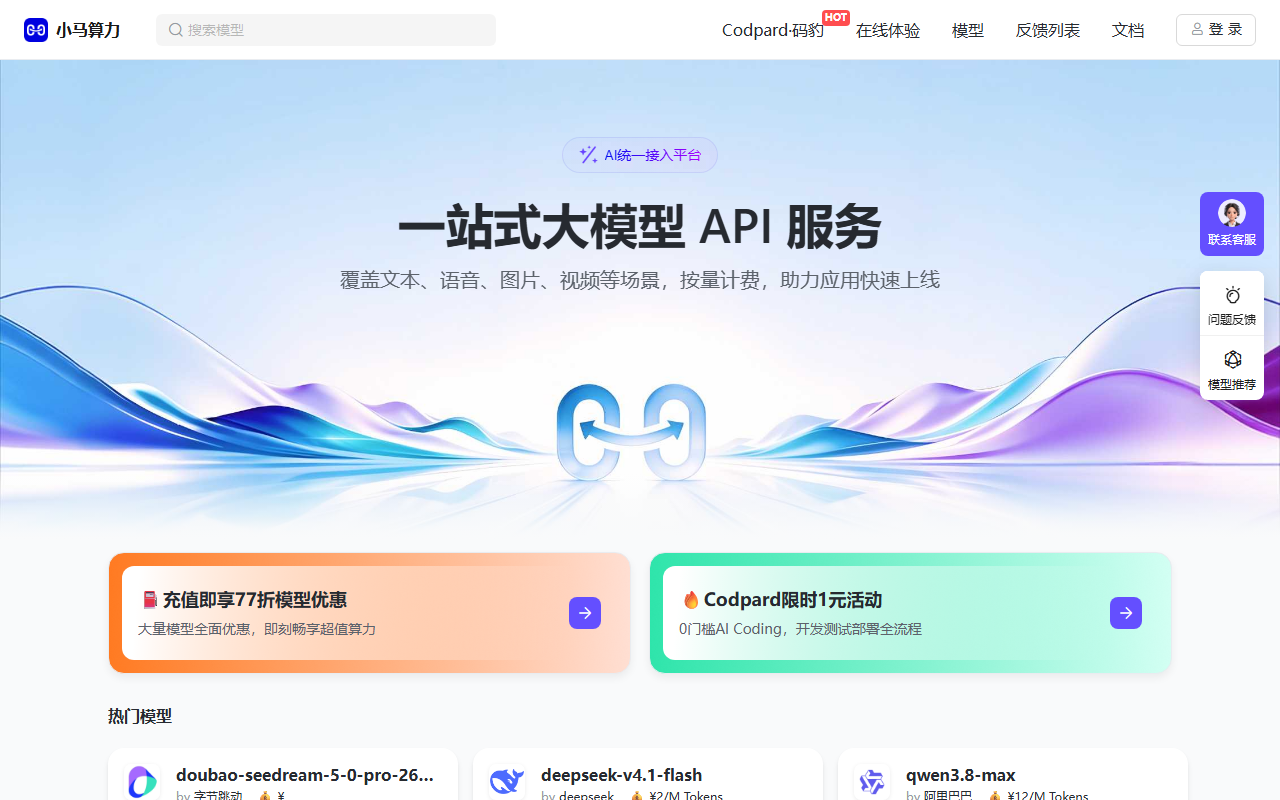
小马算力:为大模型调用提供统一接口的API聚合平台
小马算力 是一款为个人开发者和小型团队设计的AI模型API聚合平台。它的定位可以类比为一个调度层:把 DeepSeek、Kimi、Qwen、GLM 等多种主流大模型集成到同一个接口下,让使用者不必在多个平台之间反复切换。对开发者而言,真正消耗精力的往往不是"调一次模型",而是多模型并用时的接入、鉴权、计费与维护成本。这个平台把这些收拢到一处,同时提供 1024K 的超长上下文支持,用来处理长文档、多轮对话和复杂的Agent任务,并且不需要自建GPU服务器。
主要功能
全模型接入 集成 DeepSeek、Kimi、Qwen、GLM 等主流大模型,用户无需跨平台切换,可在同一平台自由调用不同模型。对需要同时使用多个模型的应用来说,这消除了重复接入的麻烦。
超长上下文支持 提供 1024K 的上下文处理能力,可用于长文档、多轮对话以及复杂的Agent任务。上下文长度直接决定了一次能塞进多少材料,是处理长文类任务的前置条件。
一键调用API 零配置、免部署,接入即用。开发者不需要处理服务部署与运行环境配置,拿到密钥后即可发起调用。
无需GPU服务器 通过调用预训练模型的API即可使用,不必自建GPU服务器,硬件成本因此省下。对个人开发者和小型团队来说,这往往是最关键的取舍点。
成本优化 提供透明的定价机制,便于在性能与成本之间做取舍。调用不同模型的单位成本差异明显,定价清晰有助于控制整体开销。
使用步骤
- 注册登录:访问产品官网,通过页面右上角的登录入口完成注册。
- 查看模型:进入模型页面查看支持的模型列表,可用筛选功能查找特定模型的详情。
- 充值:在"用户信息"中选择充值。目前支持微信支付,最小充值金额为10元,用于支持后续的模型调用。
- 创建API Key:在模型页面选择需要配置的模型,即可为该模型创建API Key。
- 调用接口:用创建好的API Key 通过平台接口调用所需模型,开始开发工作。
- 管理用量:按项目估算调用量,并结合不同模型的定价选择合适的模型,避免不必要的消耗。
适用人群
- 个人开发者:希望快速接入多种大模型,简化开发流程并降低开发成本
- 小型团队:需要高效利用有限资源,快速搭建和部署基于大模型的应用
- 创意工作者:如文案撰写者、内容创作者,需要借助AI提高创作效率和质量
- 企业用户:希望在业务中集成AI能力,但不想投入大量资源自建模型和基础设施
- 研究人员:需要灵活调用不同模型进行研究和实验,探索AI的新应用场景
- 学生和教育工作者:用于学习和教学,探索AI在教育领域的应用
限制与注意
- 模型能力与参数以平台实际提供的版本为准,不同模型在效果、速度与上下文限制上存在差异。
- 聚合接口不改变模型本身的输出质量,重要任务的准确性仍需自行评估与验证。
- 调用按量计费,长上下文与高频调用会显著增加开销,需按实际用量估算。
- API Key 属于凭证,应妥善保管,避免泄露或提交到公开代码仓库。
- 需要联网并依赖平台的可用性,服务调整或故障会影响调用链路。
- 充值与支付方式、价格与优惠以平台实际页面为准,请在使用前确认当前规则。
常见问题
小马算力能解决什么问题?
小马算力把 DeepSeek、Kimi、Qwen、GLM 等主流大模型集成到同一个接口下,避免跨平台切换与重复接入的繁琐流程。同时提供 1024K 超长上下文支持,可处理长文档、多轮对话和复杂Agent任务,且无需自建GPU服务器,降低硬件成本。
如何在小马算力上调用模型?
基本流程是:注册登录,在模型页面查看支持的模型,通过用户信息完成充值,在模型页面选择所需模型创建API Key,然后用该密钥通过平台接口发起调用。充值目前支持微信支付,最小充值金额为10元。
使用这类API聚合平台需要注意什么?
需要注意几点:不同模型在效果、速度和上下文限制上存在差异,聚合接口不改变模型本身的输出质量;调用按量计费,长上下文与高频调用会显著增加开销;API Key 属于凭证,应避免泄露或提交到公开仓库;此外需要联网并依赖平台可用性,价格与规则以平台实际页面为准。



