

數眼智能AI提供三類可直接呼叫的資料介面:傳入 URL 回傳結構化 Markdown 或 JSON 的網頁解析、涵蓋多領域資料來源的聯網搜尋,以及把 PDF 與掃描檔轉成階層化文字的文件 OCR。它同時提供模型廣場做多模型聚合呼叫,並已上架 Dify、Coze 等平台。新用戶有 500 次免費呼叫額度,介面為標準化 REST,支援私有化部署。廠商宣稱平均回應低於 1 秒、價格約為同業三分之一,這些屬於官方說法,實際情況需自行壓測驗證。
數眼智能AI:為大模型補上網頁解析、聯網搜尋與文件OCR的資料管線
做 Agent 的人遲早會撞上同一道牆:模型本身夠聰明,但它看不見你要它看的那一頁。要嘛知識停在訓練截止日,要嘛 HTML 裡塞滿廣告與導覽列,要嘛關鍵資料躺在一份掃描版 PDF 裡。數眼智能AI 切的就是這一段——它不做模型,賣的是把外部世界整理成模型能吃的形狀這條管線。判斷它值不值得接入,關鍵看三件事:解析出來的是不是乾淨的結構化資料、搜尋能不能回到可核驗的來源,以及在你需要的併發下延遲還能不能穩住。
依官方定位,數眼智能AI 是「大模型時代的智慧資料基建服務商」,技術路線寫的是「視覺+程式碼」雙模態:一邊用電腦視覺理解頁面渲染後的樣子,一邊用程式邏輯抽取結構,兩條路互相校驗。這個組合針對的是傳統爬蟲的兩個軟肋——前端動態渲染的頁面抓不到,以及複雜版面下選擇器一改就崩。廠商稱其自研系統涵蓋 300 多個領域、數億級結構化資料來源,並會過濾廣告干擾。
產品線可以分成三層:底層是網頁解析、聯網搜尋、文件 OCR 三類資料介面;中間是模型廣場,做多模型聚合呼叫、智慧體對話、深度研究與 MCP 工作流整合;外圍還有資料集服務與 BI 資料分析平台。對多數團隊來說,真正會用到的往往只是最底層的兩三個介面,其餘部分屬於同一家供應商的延伸能力,按需評估即可。
核心能力拆解
網頁解析:把渲染後的頁面還原成模型能讀的文字
傳入目標 URL,介面回傳結構化的 Markdown 或 JSON。它的價值不在於「能抓」,而在於抓完之後不用你再寫清洗規則:正文、標題階層、表格盡量保留,廣告與導覽被剔除。對 RAG 管線來說,這一步決定了切片品質與召回品質——髒資料進去,檢索出來的東西再相似也沒用。官方說明支援動態渲染頁面與複雜版面,這也是視覺解析相對於純 DOM 解析的意義所在。
聯網搜尋:給 Agent 一層可追溯來源的檢索
搜尋介面面向大模型設計,回傳的不只是連結清單,而是經過相關性評分與結構化處理的內容片段。官方稱資料來源涵蓋新聞、百科、學術、媒體平台等,依託近百億級網頁與自建站點檔案庫做即時更新。做深度研究類應用時,這套能力的差別體現在「參考網頁數」上——廠商稱其深度研究模式參考網頁數是普通搜尋的 7 倍,這意味著更長的上下文與更多的交叉驗證機會。
文件 OCR:PDF 與掃描檔的階層化輸出
上傳 PDF 或掃描檔,OCR 引擎擷取文字、表格、公式,輸出帶階層結構的 Markdown 與 JSON。難點從來不是辨識單個字,而是還原文件的組織關係:哪一行是標題、哪張表跨了幾頁、公式裡哪個符號是上下標。階層化輸出對下游很關鍵,因為知識庫需要靠標題階層切塊,丟了階層就只能按固定字數硬切。
模型廣場與 MCP:把模型呼叫與資料注入放在同一層
模型廣場做的是多模型聚合:一個入口對接多家大模型,統一計費與回傳格式,開發者不用自己維護多套部署。MCP 整合則讓網頁搜尋與內容解析以標準化介面注入 AI 工作流,對已經在用 MCP 協定的團隊來說,這比重寫一套工具呼叫邏輯省事得多。兩類能力疊在一起的實際意義是:資料側與模型側可以在同一處設定,減少跨服務拼接的出錯面。
怎麼接入
- 到官網註冊帳號並取得 API Key。官方說明新用戶有 500 次免費呼叫額度,足夠把三類介面各跑通一遍再決定是否付費。
- 先用網頁解析介面驗證你最在意的那些頁面。挑 10 到 20 個真實目標 URL(包含動態渲染、複雜表格、長文分頁的情況),看回傳的 Markdown 是否保留了你要的結構,別只看官方示例頁。
- 接文件 OCR 時準備一批邊界樣本:雙欄排版、跨頁表格、含公式的掃描檔。階層結構錯亂通常出現在這類樣本上,早發現比上線後發現便宜。
- 如果已經在用 Dify 或 Coze,可以直接在智慧體工作流裡掛載,不必自己寫伺服器端;要自己整合則按標準 REST 呼叫,回傳格式選 Markdown 便於人工抽查,選 JSON 便於程式解析。
- 對政務、金融等強合規場景,官方支援高併發私有化部署,但具體交付形態、部署週期與費用來源未揭露,需要走商務溝通確認。
定價與額度
- 新用戶註冊後有 500 次免費呼叫額度,這是唯一公開的明確數字,適合做小規模驗證,不足以支撐生產流量。
- 計費方式為按 token 精確計費,廠商稱價格約為同業的三分之一,且只對成功呼叫收費。只對成功呼叫收費這一條在解析類服務裡值得關注,因為網頁解析的失敗率天然高於一般文字介面。
- 各介面的具體單價、階梯折扣、私有化部署報價、超出額度後的結算方式,來源均未揭露,需要在控制台或商務管道確認。
適合誰用
- 在 Dify、Coze 等平台上搭建 Agent 的開發者:需要給智慧體補上即時網頁讀取與搜尋能力,又不想自己維護爬蟲與代理池。
- 做 RAG 知識庫的團隊:內部資料大量以 PDF、掃描檔形式存在,需要先把非結構化文件變成可切塊的階層文字。
- 內容聚合與電商比價類應用:需要持續抓取並清洗全網商品與資訊,且對廣告噪音敏感。
- 金融、政務等強合規行業的技術團隊:需要私有化部署與資料不出域,同時保留聯網檢索能力。
限制與注意事項
- 效能數字全部來自廠商說法。「平均回應小於 1 秒」「比同業快 40%」「錯誤率低於 0.01%」「價格僅為同業三分之一」均無第三方基準,也沒有說明測試集與頁面類型,選型時應按自己的目標站點實測。
- 定價透明度有限。除 500 次免費額度外,各介面單價、併發上限、限流策略、失敗重試是否計費均未在公開資料中說明。
- 資料合規細節未揭露。網頁解析與搜尋涉及第三方內容抓取,版權邊界、robots 遵循策略、抓取內容的儲存期限與使用範圍,需要向官方書面確認,尤其是要做內容再散佈的場景。
- 多語系解析效果未說明。官方強調「精準處理複雜中文場景」,這對中文站點是優勢,但如果你的目標頁面以其他語言為主,效果需要單獨驗證。
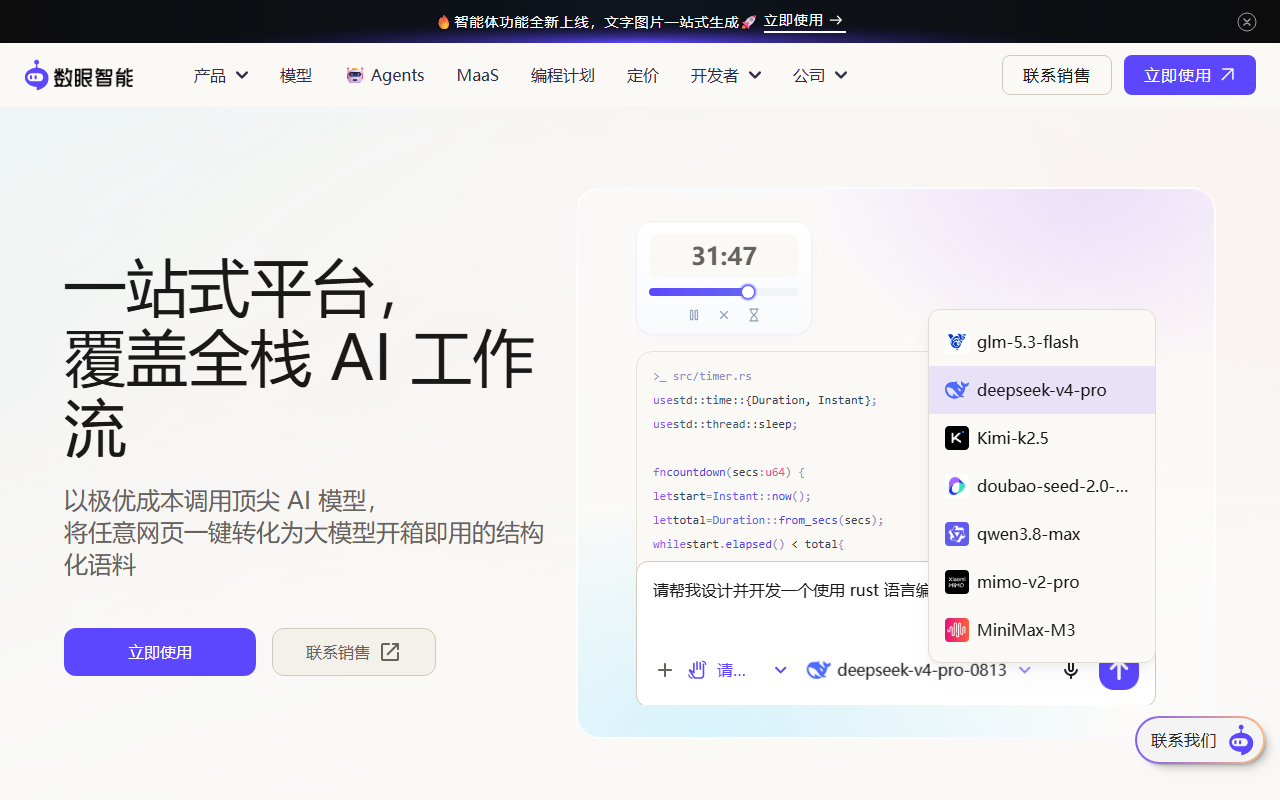
- 本次可確認的媒體素材只有一張官網截圖,公開頁未提供產品介面細節圖,因此本文不插圖;介面與實際回傳樣例請以官方控制台為準。
常見問題
數眼智能AI 是模型本身嗎?
不是。它是資料介面與模型聚合層,自己不訓練大模型,賣的是網頁解析、聯網搜尋、文件 OCR 三類資料能力,以及一個可以呼叫多家模型的模型廣場。你仍然需要自己選定底層模型。
和直接寫爬蟲相比優勢在哪?
主要差在維護成本。自建爬蟲要處理動態渲染、反爬、選擇器失效與正文清洗,頁面改版一次就可能全線崩。託管介面把這些工作轉移到服務方,代價是單價與可控性——你對抽取規則的控制會變弱,遇到特殊頁面時調整空間有限。
能直接接到 Dify 或 Coze 裡嗎?
官方稱已上架這兩個平台,可以在智慧體工作流中設定使用。具體外掛名稱與設定步驟以平台內的實際清單為準,本文不代為確認。
免費額度用完之後怎麼辦?
官方未公開超出額度後的結算規則與單價。穩妥做法是先用 500 次額度跑完驗證,再向官方詢價並確認是否只對成功呼叫計費,避免按呼叫次數估算成本時出現偏差。
常見問題
數眼智能AI 是模型本身嗎?
不是。它是資料介面與模型聚合層,自己不訓練大模型,賣的是網頁解析、聯網搜尋、文件 OCR 三類資料能力,以及一個可以呼叫多家模型的模型廣場。你仍然需要自己選定底層模型。
和直接寫爬蟲相比優勢在哪?
主要差在維護成本。自建爬蟲要處理動態渲染、反爬、選擇器失效與正文清洗,頁面改版一次就可能全線崩。託管介面把這些工作轉移到服務方,代價是單價與可控性——你對抽取規則的控制會變弱,遇到特殊頁面時調整空間有限。
能直接接到 Dify 或 Coze 裡嗎?
官方稱已上架這兩個平台,可以在智慧體工作流中設定使用。具體外掛名稱與設定步驟以平台內的實際清單為準,本文不代為確認。
免費額度用完之後怎麼辦?
官方未公開超出額度後的結算規則與單價。穩妥做法是先用 500 次額度跑完驗證,再向官方詢價並確認是否只對成功呼叫計費,避免按呼叫次數估算成本時出現偏差。



