Seedance eignet sich für Teams und Kreative, die in Werbung, Film, E-Commerce, Gaming oder Bildung viele kurze Videos erzeugen, dabei Bild und Ton synchron ausgeben und die Figurkonsistenz über mehrere Einstellungen hinweg wahren müssen.
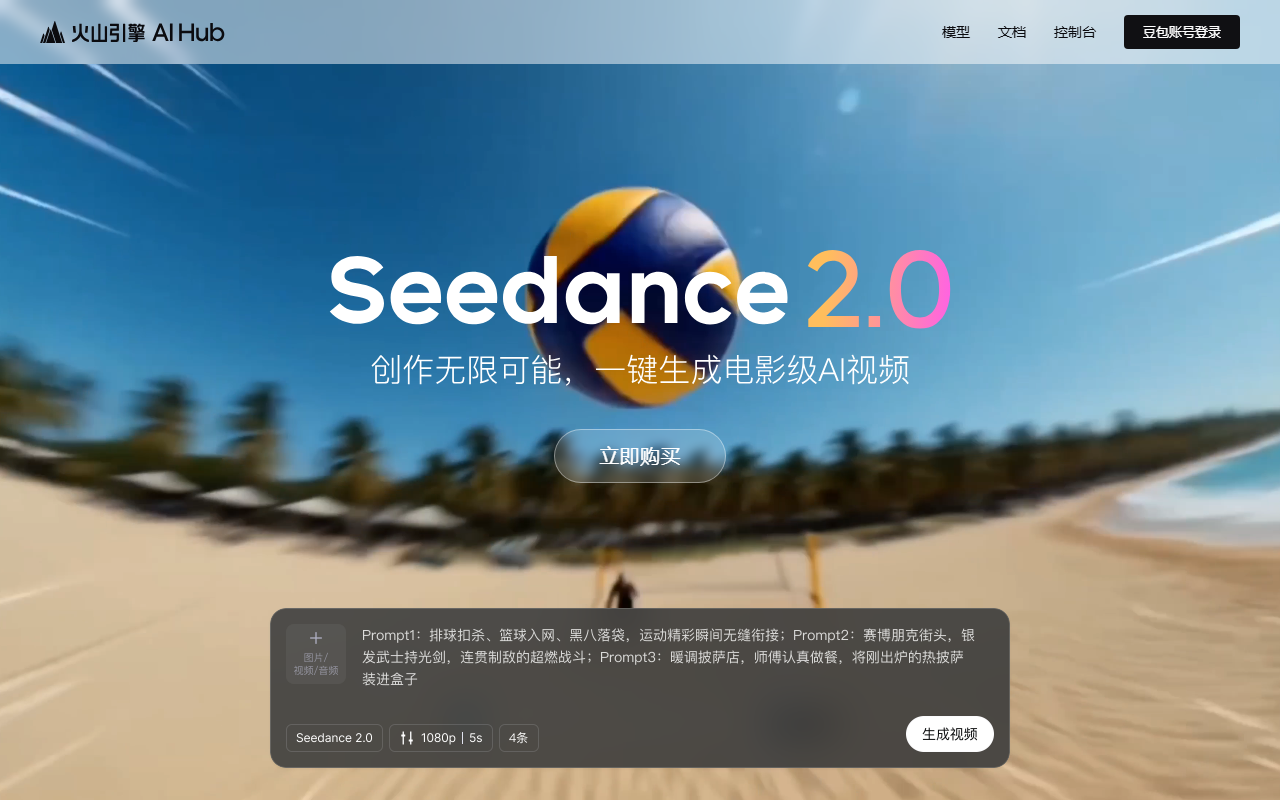
Seedance: Multimodales KI-Videomodell mit synchroner Bild- und Tonspur
Seedance ist ein multimodales KI-Videomodell mit einer einheitlichen multimodalen Architektur für die gemeinsame Erzeugung von Bild und Ton. Der größte Unterschied zu gängigen Videoerzeugungswerkzeugen liegt darin, dass Text, Bild, Audio und Video als Eingabemodalitäten nativ unterstützt werden und Bild wie Ton in einem einzigen Generierungslauf synchron entstehen. Der zweistufige Weg, zuerst stummes Bild zu erzeugen und danach Ton zu ergänzen, entfällt damit. Musik, Soundeffekte und lippenabgestimmter Dialog entstehen in einem Durchlauf, wodurch die typischen Lippensprünge und Soundeffekt-Fehler des zweistufigen Verfahrens vermieden werden. Das Modell richtet sich vor allem an Hochfrequenz-Szenarien der Content-Produktion in Werbung, Film, E-Commerce, Gaming und Bildung.
Hauptfunktionen
Multimodale Mischeingabe
Text, neun Bilder, drei Videos und drei Audiodateien lassen sich gleichzeitig eingeben, und mit der "@Mention"-Syntax lässt sich für jedes Material präzise festlegen, was es steuern soll. Mehrere Materialien werden also nicht bloß nebeneinandergelegt, sondern einzeln zugewiesen.
Native Ton- und Bildgenerierung
Auf Basis eines Dual-Branch-Diffusion-Transformers laufen Bild und Ton parallel in derselben Generierungspipeline. Musik, Soundeffekte und lippenabgestimmter Dialog in mehreren Sprachen werden automatisch ausgegeben. Die Abstimmung von Dialog und Mundbewegung ist mit einer Generierung abgeschlossen, ein separater Synchronisationsschritt entfällt.
Intelligente Verlängerung und Bearbeitung
Clips lassen sich in Schritten von fünf Sekunden nahtlos verlängern, wobei Figuren, Beleuchtung und Szenekontext konsistent bleiben. Mehrteilige Erzählstrukturen und Kameraführung werden unterstützt. Gerade diese Konsistenz entscheidet, ob das Endergebnis durchgängig funktioniert.
Konsistenz von Figuren und Physik
Über mehrere Einstellungen hinweg bleiben Gesicht und Körperhaltung einer Figur konsistent, zusätzlich simuliert Physik-Penalty-Training die Regeln von Schwerkraft, Flüssigkeiten und Kollisionen. Genau diese beiden Punkte brechen in mehrteiligen Erzählstrukturen am häufigsten aus.
Ausgabe in mehreren Auflösungen
480p, 720p, 1080p sowie direkte Ausgabe in 2K und 4K werden unterstützt, die Videolänge deckt Standardclips von 4 bis 15 Sekunden ab und reicht bis maximal 60 Sekunden.
Ausrichtung auf industrielle Szenarien
Das Modell richtet sich vor allem an Hochfrequenz-Szenarien der Content-Produktion in Werbung, Film, E-Commerce, Gaming und Bildung und liefert Unternehmen sowie Kreativen eine Videogenerierungslösung.
Verwendung
- Einstieg und Anmeldung: Über den Einstieg die Anmeldung des Kontos abschließen.
- Ressourcenpaket wählen: Passendes Ressourcenpaket kaufen. Ressourcenpakete werden nach Tokenumfang berechnet, gelten für Privat- und Geschäftskunden gemeinsam 90 Tage und werden anteilig zum Token-Einzelpreis verrechnet. Nach vollständiger Nutzung erfolgt automatisch die Umstellung auf nutzungsabhängige Abrechnung.
- Referenzmaterial hochladen: Im Erstellungsbereich den Text-Prompt eingeben, Bild-, Video- oder Audio-Referenzen hochladen und mit der "@"-Syntax markieren, welches Material welche Steuerung übernimmt.
- Erzeugungsparameter einstellen: Auflösung (480p bis 1080p) und Länge (4 bis 15 Sekunden) wählen, die Erzeugung starten und die Modellausgabe abwarten.
- Nachbearbeitung und Export: Mit den integrierten Bearbeitungswerkzeugen verlängern, Übergänge setzen und Ton- sowie Bilddetails justieren und anschließend exportieren. Für Serienproduktion lässt sich der Ablauf über eine API anbinden.
Wichtige Informationen und Anforderungen
- Modellversion: Seedance 2.0
- Regeln für Ressourcenpakete: 90 Tage gültig für Privat- und Geschäftskunden gemeinsam, anteilige Verrechnung zum Token-Einzelpreis, danach automatische Umstellung auf nutzungsabhängige Abrechnung
- Anbindung: Konsolenbasierte visuelle Bedienung, API-Aufrufe und Zusammenarbeit über den gesamten Ablauf werden unterstützt
- Einstiegshürde: Privat- und Geschäftskunden können Ressourcenpakete direkt erwerben und benötigen keinen eigenen Rechencluster
- Ausgabespezifikation: Auflösung wählbar zwischen 480p / 720p / 1080p, Videolänge von 4 bis 15 Sekunden, direkte Ausgabe bis 2K/4K
Ressourcenpakete
Die Staffelung erfolgt nach Tokenumfang, die Pakete gelten für Privat- und Geschäftskunden gemeinsam 90 Tage. Alle unterstützen die Ausgabe in 480p / 720p / 1080p und eine Längeneinstellung von 4 bis 15 Sekunden und werden anteilig zum Token-Einzelpreis verrechnet. Je nach Auflösung und Eingabemodus liegt das maximale Verrechnungsverhältnis bei etwa 1:1,8.
- Leicht-Paket: 196 Yuan, 7 Millionen Token, etwa 28 Videos in 480p
- Komplett-Paket: 280 Yuan, 10 Millionen Token, etwa 40 Videos in 480p
- Effizienz-Paket: 364 Yuan, 13 Millionen Token, etwa 52 Videos in 480p
Die Angaben entsprechen den in den Materialien dokumentierten Preisen und Umfängen. Die konkreten Stufen und Preise richten sich nach der tatsächlichen Kaufseite.
Kernvorteile
- Bild und Ton in einem Lauf: Bild und Ton entstehen synchron in einer Inferenz, wodurch Lippensprünge und Soundeffekt-Fehler entfallen
- Kontrollpräzision auf industriellem Niveau: Bis zu 15 Referenzquellen werden gleichzeitig ausgewertet, Figuren, Kameraführung, Bewegung und Stil lassen sich wie bei einer Regie anweisen
- Hohe Verfügbarkeit der Ergebnisse: Der Anteil direkt verwendbarer Ergebnisse bestimmt unmittelbar den Umfang manueller Nacharbeit
- Rückkopplung über Daten: Auf Basis umfangreicher Praxis mit Kurzvideos und der Rückmeldung aus den Daten wächst das Verständnis für visuell stark verbreitete Inhalte fortlaufend
- Flexible Kostenstruktur: Nutzungsabhängige Cloud-Rechenleistung und gestufte Ressourcenpakete ermöglichen den Einstieg auch für mittelgroße Unternehmen ohne große Investitionen
Unterschiede zu vergleichbaren Werkzeugen
Vergleichbare Videoerzeugungswerkzeuge sind in der Referenzkontrolle nicht generell schwächer und nutzen jeweils eigene Steuerverfahren, etwa multimodale Steuerung, Bewegungspinsel oder Szenensteuerung. Der eigentliche Unterschied liegt in zwei Punkten.
Erstens, ob Ton nativ erzeugt wird. Einige Werkzeuge geben stummes Video aus, eine Nachsynchronisation ist dann nötig und die Anpassung von Ton und Bild erfolgt von Hand. Seedance nimmt den Ton in dieselbe Generierungspipeline auf.
Zweitens, die Ausgabelänge und die Physiksimulation. Bei vergleichbaren Werkzeugen liegen Standardclips üblicherweise zwischen 10 und 30 Sekunden und müssen mehrfach zusammengesetzt und verlängert werden. Seedance verlängert in Schritten von fünf Sekunden bei erhaltenem Kontext bis maximal 60 Sekunden. Bei der Physiksimulation beschränken sich einige Werkzeuge auf grundlegende Bewegungs- und Verformungseffekte, während Seedance Physik-Penalty-Training für Schwerkraft, Flüssigkeiten und Kollisionen ergänzt.
Beim Verstehen chinesischer Semantik und der Lippenbewegung schneiden Modelle, die auf chinesische Kurzvideoszenarien abgestimmt sind, meist gut ab. Die Kostenschwelle hängt davon ab, wie Gratisanteil, Abonnement und Ressourcenpakete kombiniert sind.
Einsatzszenarien
- Massenproduktion von Kurzvideos und Social-Media-Inhalten: Marketingteams erzeugen auf Basis einer Markenmaterialbibliothek mehrere Varianten von 15-sekündigen Werbefilmen aus Textbeschreibungen und Referenzvideos
- Visuelles E-Commerce-Marketing: Mit der Funktion zur Erzeugung von Video aus Bildern und der Figurkonsistenz über Einstellungen hinweg werden statische Produktbilder zu kurzen Clips, in denen eine Person das Produkt in Bewegung zeigt, während Gesichtszüge und Szenenstil einheitlich bleiben
- Mehrsprachige Lokalisierung: Mit mehrsprachiger Lippensynchronisation werden Mundbewegung und Synchronstimme desselben Videomaterials ausgetauscht und an verschiedene regionale Märkte angepasst
- Filmvorschau und Storyboards: Aus Textanweisungen und Referenzvideos zur Kameraführung entstehen Storyboard-Entwürfe, mit denen die Bildsprache vor dem Dreh geprüft wird
Grenzen und Hinweise
- KI-generierte Inhalte garantieren keine Richtigkeit von Fakten und Details; Bilder mit Markenlogos, Produktoptik oder Datendarstellungen sind von Hand zu prüfen.
- Die synchrone Erzeugung von Ton und Bild reduziert den Synchronisationsaufwand, der erzeugte Sprachinhalt ist jedoch daraufhin zu prüfen, ob er der tatsächlichen Aussage des Geschäfts entspricht.
- Die Obergrenze beim Material (neun Bilder, drei Videos, drei Audiodateien) begrenzt die Menge komplexer Szenen pro Eingabe; darüber hinaus gehendes Material ist auf mehrere Durchgänge aufzuteilen.
- Die Umrechnung "etwa 28 Videos in 480p" beruht auf einer bestimmten Auflösung und einem bestimmten Eingabemodus; höhere Auflösungen oder komplexe Eingaben verbrauchen mehr Token.
- Preise, Umfänge und Paketregeln können sich ändern; maßgeblich ist die tatsächliche Kaufseite.
- Die kommerzielle Nutzung richtet sich nach den Nutzungsbedingungen der Plattform; bei der Eingabe fremder Materialien ist eine entsprechende Berechtigung sicherzustellen.
Häufig gestellte Fragen
Worin unterscheidet sich Seedance von gängigen Videoerzeugungswerkzeugen?
Der entscheidende Unterschied ist, ob Ton nativ erzeugt wird. Seedance unterstützt Text, Bild, Audio und Video als native Eingabemodalitäten und gibt Bild und Ton in einer Generierung synchron aus, sodass Musik, Soundeffekte und lippenabgestimmter Dialog in mehreren Sprachen automatisch entstehen. Werkzeuge, die stummes Video ausgeben, benötigen dagegen eine Nachsynchronisation, bei der die Anpassung von Ton und Bild von Hand erfolgt.
Welche Eingabearten und Ausgabespezifikationen unterstützt Seedance?
Als Eingabe lassen sich Text, neun Bilder, drei Videos und drei Audiodateien gleichzeitig angeben, wobei die '@Mention'-Syntax festlegt, welches Material was steuert. Als Auflösung stehen 480p, 720p und 1080p zur Auswahl, zusätzlich wird direkte Ausgabe in 2K und 4K unterstützt. Die Videolänge umfasst Standardclips von 4 bis 15 Sekunden, die sich in Schritten von fünf Sekunden nahtlos verlängern lassen, bis maximal 60 Sekunden.
Worauf ist bei der Erzeugung von Videos mit Seedance zu achten?
KI-generierte Inhalte garantieren keine Richtigkeit von Fakten und Details, Bilder mit Markenlogos, Produktoptik oder Datendarstellungen sind von Hand zu prüfen. Erzeugter Sprachinhalt ist daraufhin zu prüfen, ob er der tatsächlichen Aussage entspricht. Referenzmaterial ist auf neun Bilder, drei Videos und drei Audiodateien begrenzt, komplexe Szenen also auf mehrere Durchgänge aufgeteilt. Die Umrechnung 'etwa 28 Videos in 480p' beruht auf einer bestimmten Auflösung und einem bestimmten Eingabemodus, höhere Auflösungen verbrauchen mehr Token. Preise, Umfänge und Paketregeln richten sich nach der tatsächlichen Kaufseite.