Seedance è adatto a team e creator che devono produrre in blocco video brevi per pubblicità, cinema, e-commerce, gaming o istruzione, con immagine, doppiaggio ed effetti sonori generati insieme e personaggi coerenti tra più inquadrature.
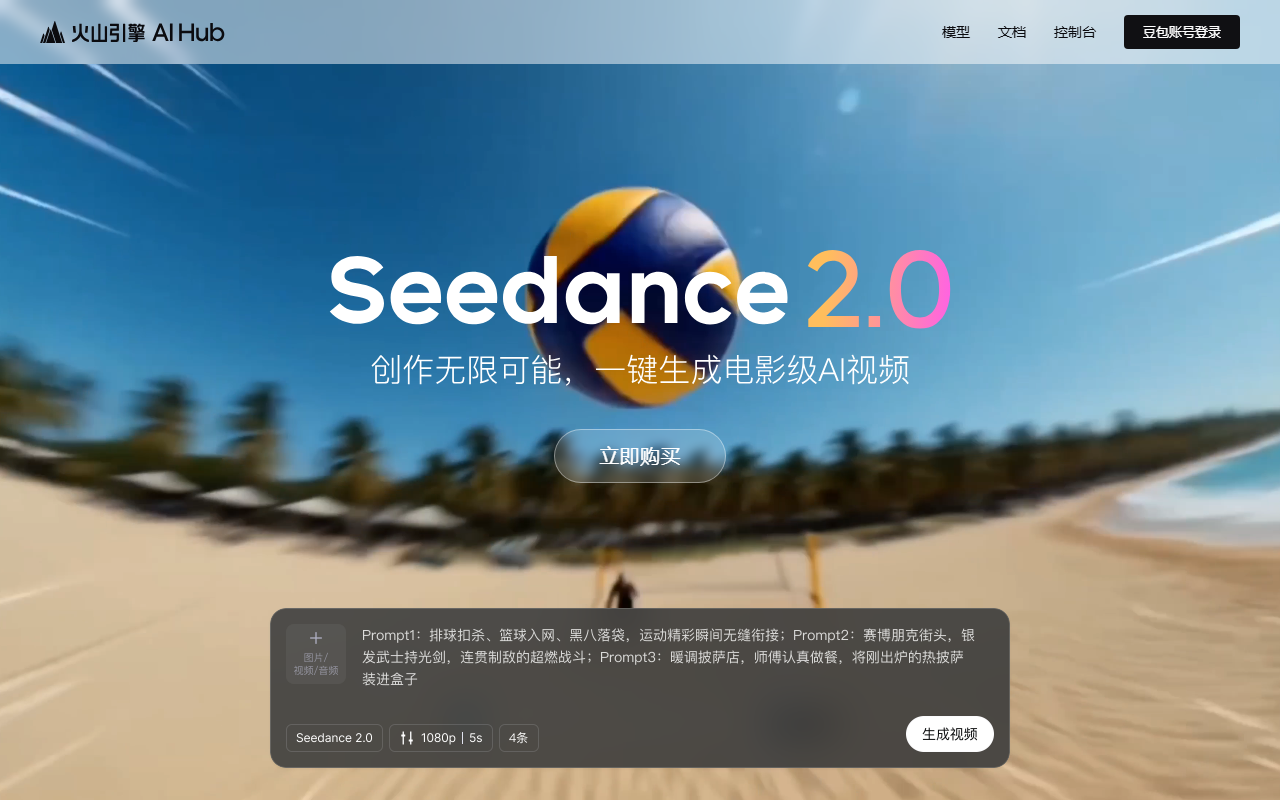
Seedance: modello multimodale di generazione video con generazione sincrona di audio e immagine
Seedance è un modello multimodale di generazione video basato su un'architettura unificata di generazione congiunta di immagine e audio. La differenza principale rispetto agli strumenti comuni di generazione video è che le quattro modalità di input — testo, immagine, audio e video — sono supportate nativamente, e immagine e suono vengono prodotti in modo sincrono all'interno della stessa generazione, invece di ottenere prima un'immagine muta e aggiungere poi l'audio in una fase separata. Questo significa che colonna sonora, effetti sonori e dialogo sincronizzato con il movimento delle labbra possono essere completati in un'unica inferenza, evitando il disallineamento tra le labbra e gli effetti sonori tipico del flusso in due fasi. Il modello è pensato principalmente per scenari di produzione di contenuti ad alta frequenza come pubblicità, cinema, e-commerce, gaming e istruzione.
Funzioni principali
Input multimodale misto Consente di inserire contemporaneamente testo, 9 immagini, 3 video e 3 file audio, con la sintassi «menzione @» per specificare con precisione l'obiettivo di controllo di ogni singolo materiale. In questo modo la combinazione di più materiali non è un semplice «accostamento», ma un'assegnazione distinta di funzioni.
Generazione sincrona nativa di audio e immagine Basato su un trasformatore diffusionale a doppio ramo, immagine e audio scorrono in parallelo all'interno della stessa catena di generazione, producendo automaticamente colonna sonora, effetti sonori e dialogo multilingue sincronizzato con il movimento delle labbra. L'allineamento tra dialogo e movimento delle labbra avviene nella singola generazione, senza un passaggio aggiuntivo di doppiaggio.
Estensione intelligente e montaggio video Estensione continua dei frammenti a passo di 5 secondi, mantenendo la continuità di personaggi, illuminazione e contesto della scena, con supporto alla narrazione su più inquadrature e al controllo del movimento di camera. La continuità durante l'estensione determina se il risultato finale si guarda senza soluzione di continuità.
Vincoli di coerenza del personaggio e della fisica Mantiene volto e corporatura del personaggio coerenti tra le inquadrature e applica un addestramento con penalità fisica per simulare gravità, fluidi e collisioni. Sono proprio questi i due aspetti che crollano più facilmente nella narrazione su più inquadrature.
Output a più risoluzioni Supporta 480p, 720p, 1080p e l'output diretto in 2K/4K; la durata del video copre i frammenti standard da 4 a 15 secondi, con un massimo fino a 60 secondi.
Orientamento a scenari industriali Si rivolge principalmente a scenari di produzione ad alta frequenza come pubblicità, cinema, e-commerce, gaming e istruzione, offrendo alle aziende e ai creator una soluzione di generazione video.
Come si utilizza
- Accedere al punto d'ingresso e effettuare il login: entrare nel punto d'ingresso ufficiale e completare l'accesso all'account.
- Scegliere il pacchetto di risorse: selezionare il pacchetto in base alle esigenze. I pacchetti sono misurati in crediti di token, hanno una validità di 90 giorni in regime condiviso tra privati e aziende, vengono scalati in proporzione al prezzo del token e, una volta esauriti, passano automaticamente alla modalità a consumo.
- Caricare i materiali di riferimento: inserire il prompt testuale nell'interfaccia creativa, caricare immagini, video o audio di riferimento e contrassegnare con «@» l'obiettivo di controllo di ciascun materiale.
- Configurare i parametri di generazione: scegliere la risoluzione (da 480p a 1080p) e la durata (da 4 a 15 secondi), avviare la generazione e attendere l'output del modello.
- Montaggio ed esportazione: utilizzare gli strumenti di editing integrati per estensione, transizioni o rifinitura audio-video, quindi esportare il risultato finale; per esigenze in blocco è possibile collegare il processo produttivo tramite API.
Informazioni chiave e requisiti di utilizzo
- Versione del modello: Seedance 2.0
- Regole dei pacchetti di risorse: validità di 90 giorni in regime condiviso tra privati e aziende, scalaggio proporzionale al prezzo del token e passaggio automatico al pagamento a consumo al termine
- Modalità di integrazione: operatività visuale tramite console, invocazione via API e collaborazione end-to-end nel flusso di lavoro
- Soglia di accesso: sia gli utenti privati sia le aziende possono acquistare direttamente i pacchetti di risorse, senza dover predisporre un cluster di calcolo proprio
- Specifiche di output: risoluzione 480p / 720p / 1080p, durata da 4 a 15 secondi, con output diretto fino a 2K/4K
Fasce di pacchetti di risorse
La quota è espressa in token, la validità è di 90 giorni in regime condiviso tra privati e aziende; sono supportati output a 480p/720p/1080p e durate da 4 a 15 secondi, con scalamento proporzionale al prezzo del token e rapporto massimo di scalamento pari a circa 1:1,8 tra risoluzioni e modalità di input diverse.
- Pacchetto creativo leggero: 196 yuan, quota di 7 milioni di token, circa 28 video a 480p
- Pacchetto completo integrale: 280 yuan, quota di 10 milioni di token, circa 40 video a 480p
- Pacchetto produzione ad alta resa: 364 yuan, quota di 13 milioni di token, circa 52 video a 480p
Questi sono i prezzi e le quote riportati nel materiale di riferimento; fasce e prezzi effettivi vanno verificati sulla pagina di acquisto.
Vantaggi principali
- Generazione nativa e unificata di audio e immagine: immagine e suono vengono prodotti in un'unica inferenza, eliminando il disallineamento delle labbra e gli effetti sonori fuori sincrono
- Precisione di controllo di livello industriale: analizza contemporaneamente i segnali di controllo di 15 materiali di riferimento, permettendo di gestire personaggi, camera, movimento e stile come un regista
- Alta percentuale di output utilizzabile: l'aumento della quota di generazioni utilizzabili si traduce direttamente in meno correzioni manuali in post-produzione
- Ciclo di feedback basato sui dati: grazie all'ampia pratica su contenuti video brevi e al ritorno dei dati, la comprensione dei contenuti visivi ad alta diffusione si accumula costantemente
- Struttura dei costi flessibile: calcolo cloud a consumo e pacchetti a scaglioni permettono a piccole e medie imprese di entrare senza investimenti pesanti
Differenze rispetto agli strumenti analoghi
Gli strumenti di generazione video analoghi non sono necessariamente deboli nella precisione del controllo sui riferimenti: ciascuno adotta il proprio metodo, come il controllo multimodale, il pennello di movimento o il controllo della scena. Il vero punto di divisione sta in due aspetti:
Primo: se l'audio è generato nativamente o no. Alcuni strumenti producono video senza audio e richiedono un doppiaggio successivo, il che significa che l'allineamento tra audio e immagine deve essere fatto a mano; Seedance inserisce l'audio nella stessa catena di generazione.
Secondo: durata dell'output e simulazione fisica. Nella maggior parte degli strumenti simili il frammento standard dura da 10 a 30 secondi e richiede più assemblaggi con estensione; Seedance supporta l'estensione a passo di 5 secondi mantenendo la continuità del contesto, fino a 60 secondi. Sul fronte della simulazione delle leggi fisiche, alcuni strumenti si limitano a simulare movimento e deformazione di base, mentre Seedance aggiunge un addestramento con penalità fisica per gestire gravità, fluidi e collisioni.
Quanto alla comprensione della semantica e dell'articolazione, i modelli ottimizzati per scenari di video brevi in cinese tendono a dare buoni risultati; la soglia di costo dipende invece dalla combinazione tra quota gratuita, abbonamento e pacchetti di risorse.
Casi d'uso
- Produzione in blocco di video brevi per i social media: i team di marketing possono partire dalla libreria di materiali del brand e generare più versioni di uno spot di 15 secondi tramite descrizioni testuali e video di riferimento
- Marketing visivo per l'e-commerce: la generazione video da immagine con coerenza del personaggio tra le inquadrature trasforma le immagini statiche dei prodotti in brevi presentazioni dinamiche con modella, mantenendo uniformi i lineamenti del volto e lo stile della scena
- Contenuti localizzati multilingue: grazie alla sincronizzazione dell'articolazione in più lingue, lo stesso materiale può essere adattato sostituendo movimento delle labbra e doppiaggio per i mercati di regioni diverse
- Pre-visualizzazione cinematografica e storyboard creativi: generare bozze di storyboard a partire da istruzioni testuali e video di riferimento sul movimento di camera, verificando il linguaggio dell'inquadratura prima delle riprese
Limitazioni e avvertenze
- I contenuti generati dall'IA non garantiscono accuratezza di fatti e dettagli: le inquadrature che mostrano marchi, aspetto dei prodotti o dati numerici vanno verificate manualmente.
- La generazione sincrona di audio e immagine riduce il passaggio di doppiaggio, ma il parlato generato deve comunque essere verificato rispetto alle formulazioni reali del business.
- Il limite sulla quantità di materiali (9 immagini, 3 video, 3 audio) limita la scala di input per una scena complessa; ciò che eccede va gestito in lotti.
- La conversione «circa N video a 480p» si riferisce a una specifica risoluzione e modalità di input: risoluzioni più alte o input complessi consumano più quota.
- Prezzi, quote e regole dei pacchetti possono variare: fare riferimento alla pagina di acquisto effettiva.
- L'uso commerciale è soggetto ai termini di servizio della piattaforma e i materiali di terze parti inseriti devono essere provvisti di autorizzazione.
Domande frequenti
Che differenza c'è tra Seedance e gli strumenti comuni di generazione video?
La differenza decisiva è se l'audio viene generato nativamente. Seedance tratta testo, immagine, audio e video come modalità di input native, quindi immagine e suono nascono nella stessa generazione con colonna sonora, effetti sonori e dialogo multilingue sincronizzato con le labbra. Diversi strumenti simili producono invece video muti, e l'allineamento audio-video va rifatto manualmente in post-produzione.
Quali modalità di input e quali specifiche di output supporta Seedance?
Si possono fornire contemporaneamente testo, 9 immagini, 3 video e 3 file audio, indicando con «@» l'obiettivo di controllo di ogni materiale. L'output è disponibile in 480p, 720p e 1080p, fino all'uscita diretta in 2K/4K; la durata va da 4 a 15 secondi per frammento standard, con estensione a passi di 5 secondi fino a un massimo di 60 secondi.
A cosa fare attenzione usando Seedance per generare video?
I contenuti generati dall'IA non garantiscono accuratezza dei fatti: inquadrature con marchi, aspetto dei prodotti o dati numerici vanno verificate a mano, e il parlato va confrontato con le formulazioni reali del business. Il limite di 9 immagini, 3 video e 3 audio vincola l'input nelle scene complesse. La conversione «circa N video a 480p» vale per una specifica risoluzione e modalità di input, mentre prezzi e regole dei pacchetti vanno verificati sulla pagina di acquisto.