朱雀AI検出は、テキスト・画像・動画が AI によって生成されたものかどうかを判定する AI コンテンツ検出アシスタントです。GPT-4、Claude、DeepSeek、Gemini、豆包などの主要モデルに対応し、中国語と英語のテキスト判定が可能で、疑わしい箇所のマーキング付きレポートを返します。結果は補助的な判断材料であり、学術倫理の確認、コンテンツ審査、著作権保護などに向いています。
朱雀AI検出:AI生成のテキスト・画像・動画をまとめて判定する検出アシスタント
朱雀AI検出とは
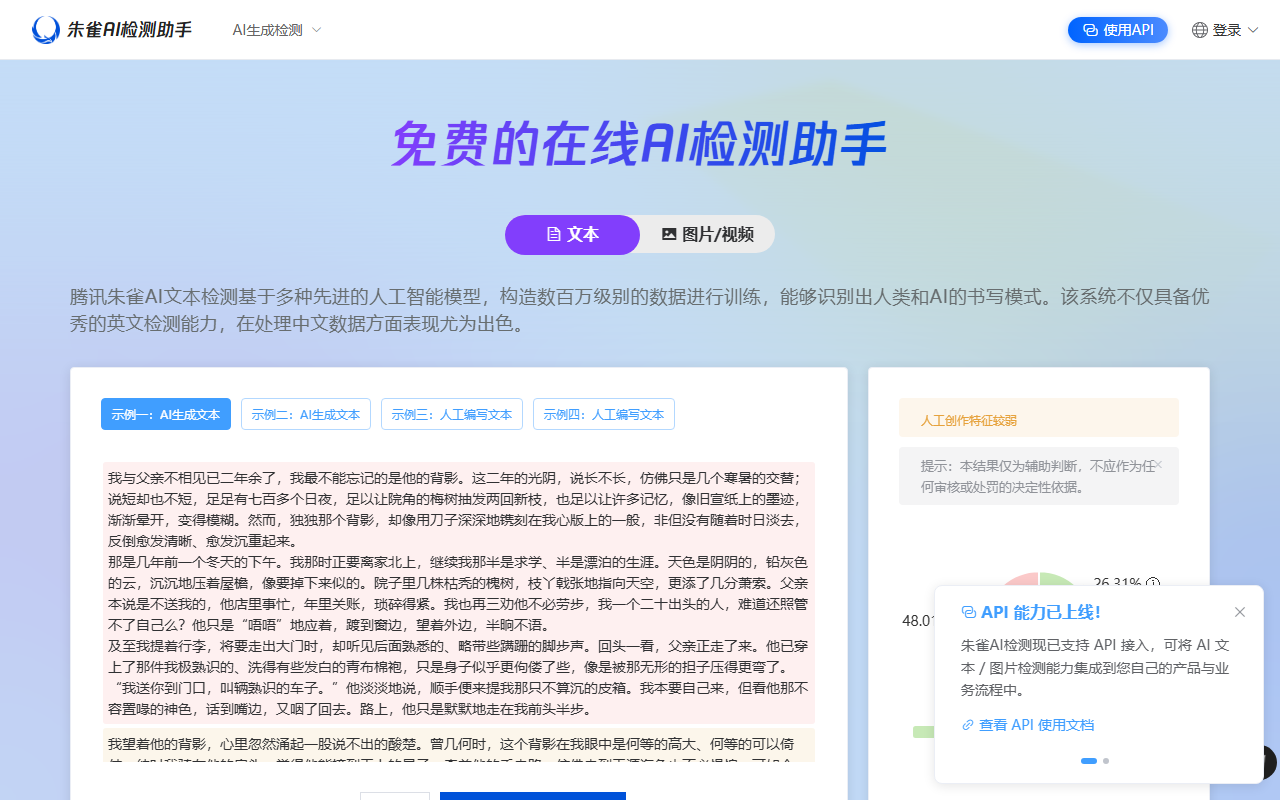
朱雀AI検出は、人工知能が生成したテキスト、画像、動画を識別する総合的な AI コンテンツ検出アシスタントです。学習済みモデルと大規模データに基づき、入力に対して確率的な判定を返すとともに、疑わしい箇所をマーキングして人が次の確認を行えるようにします。
テキストは GPT-4、Claude、DeepSeek、Gemini、豆包といった主要な大規模モデルの生成物に対応し、中国語と英語の両方を扱えます。画像は即夢、Flux、Midjourney、Stable Diffusion など一般的なテキスト-to-画像モデルや GAN の出力をカバーします。動画は混元、Sora、海螺、Veo などのテキスト-to-動画モデルによる素材を認識します。
ここで重要な点があります。検出結果は決定的な判定ではなく、補助的なシグナルだということです。学術倫理の維持、ソーシャルメディアの審査、データ品質管理など「まず一度ふるいにかける」場面には向いていますが、それだけで結論を下すべきではありません。
主な機能
テキスト検出。 AI が書いた記事や論文などのテキストを識別し、疑わしい箇所をマーキングします。確認すべき位置にすぐにたどり着けるため、審査の手間を大きく減らせます。中国語と英語に対応しています。
画像検出。 混元、豆包、即夢、Stable Diffusion などの画像生成モデルが作った画像を、一般的な画像フォーマットで検査し、合成された画像かどうかの判断を助けます。
動画検出。 混元、即夢、Sora などの AI 動画生成モデルによる動画を識別し、MP4、MOV、AVI に対応しています。
幅広い用途に。 同じ検出機能をソーシャルメディアの審査、学術倫理の確認、データ品質管理に使えるため、コンテンツ種別ごとに別のツールを用意する必要はありません。
使い方
- 公式サイト https://matrix.tencent.com/ai-detect/ を開き、検出ページに移動します。
- 検査対象(テキスト、画像、動画)に合わせて検出機能を選びます。
- アップロードボタンを押し、対象ファイルを選択します。対応形式は TXT、DOCX、PNG、JPG、WEBP、MP4、MOV、AVI などです。
- アップロードが終わったら検出を開始し、分析の完了を待ちます。
- 分析レポートで全体の判定結果と、AI 生成の可能性があるとしてマークされた箇所を確認します。
- レポートを保存用にダウンロードし、影響のある結論については人が改めて確認します。
向いている場面
- 学術研究と教育:論文や学生の課題が AI 生成かどうかを調べ、教育機関が学術倫理を守り、学生の実際の執筆力を評価する助けになります。
- コンテンツ制作と出版:公開前に記事や書籍の原稿のオリジナリティを確認します。
- ソーシャルメディアとネットプラットフォーム:プラットフォーム側が AI 生成コンテンツを把握し、偽情報や誤解を招く内容の拡散リスクを下げます。
- 著作権保護と法務コンプライアンス:権利者が無断の AI 生成物を見つけ、知的財産を守る助けになります。
- 報道機関:報道内容の真実性とオリジナリティを確認し、AI 生成の不実な情報の使用を避けます。
制限と注意点
- 結果は確率的な判定であり、両方向に誤判定の可能性があります。処分、掲載拒否、公式な認定の唯一の根拠にはできません。
- 人が大きく書き直したもの、何度も推敲されたもの、人間と AI が混在して作ったものは、検出がかなり難しくなります。
- ファイルをアップロードすると、その内容はオンラインサービスで処理されます。未公開の原稿、プライバシー、企業秘密を含む場合は慎重に判断してください。
- 公開資料には料金や利用枠の記載がありません。実際に利用できる範囲は製品ページの案内に従います。
よくある質問
検出結果をそのまま結論にできますか? できません。学習済みモデルによる確率的な判定で誤判定もあり得るため、公式でも結果を人が確認してから判断することを勧めています。
どのコンテンツ種別に対応していますか? テキスト、画像、動画の 3 種類で、TXT、DOCX、PNG、JPG、WEBP、MP4、MOV、AVI などの形式に対応します。
中国語の判定はできますか? できます。テキスト検出は中国語と英語の両方に対応しています。
どの生成モデルを見分けられますか? テキストは GPT-4、Claude、DeepSeek、Gemini、豆包など主要モデル、画像は即夢、Flux、Midjourney、Stable Diffusion など、動画は混元、Sora、海螺、Veo などのテキスト-to-動画モデルに対応します。
よくある質問
検出結果をそのまま結論にできますか?
できません。学習済みモデルによる確率的な判定で誤判定もあり得るため、公式でも結果を人が確認してから判断することを勧めています。
どのコンテンツ種別に対応していますか?
テキスト、画像、動画の 3 種類で、TXT、DOCX、PNG、JPG、WEBP、MP4、MOV、AVI などの形式に対応します。
中国語の判定はできますか?
できます。テキスト検出は中国語と英語の両方に対応しています。
どの生成モデルを見分けられますか?
テキストは GPT-4、Claude、DeepSeek、Gemini、豆包など主要モデル、画像は即夢、Flux、Midjourney、Stable Diffusion など、動画は混元、Sora、海螺、Veo などのテキスト-to-動画モデルに対応します。