Seedance atende equipes de produção de conteúdo e criadores que precisam gerar vídeos curtos em lote para publicidade, cinema, comércio eletrônico, jogos ou educação, exigindo que imagem e locução ou efeitos sonoros sejam gerados juntos e com consistência de personagens entre vários planos.
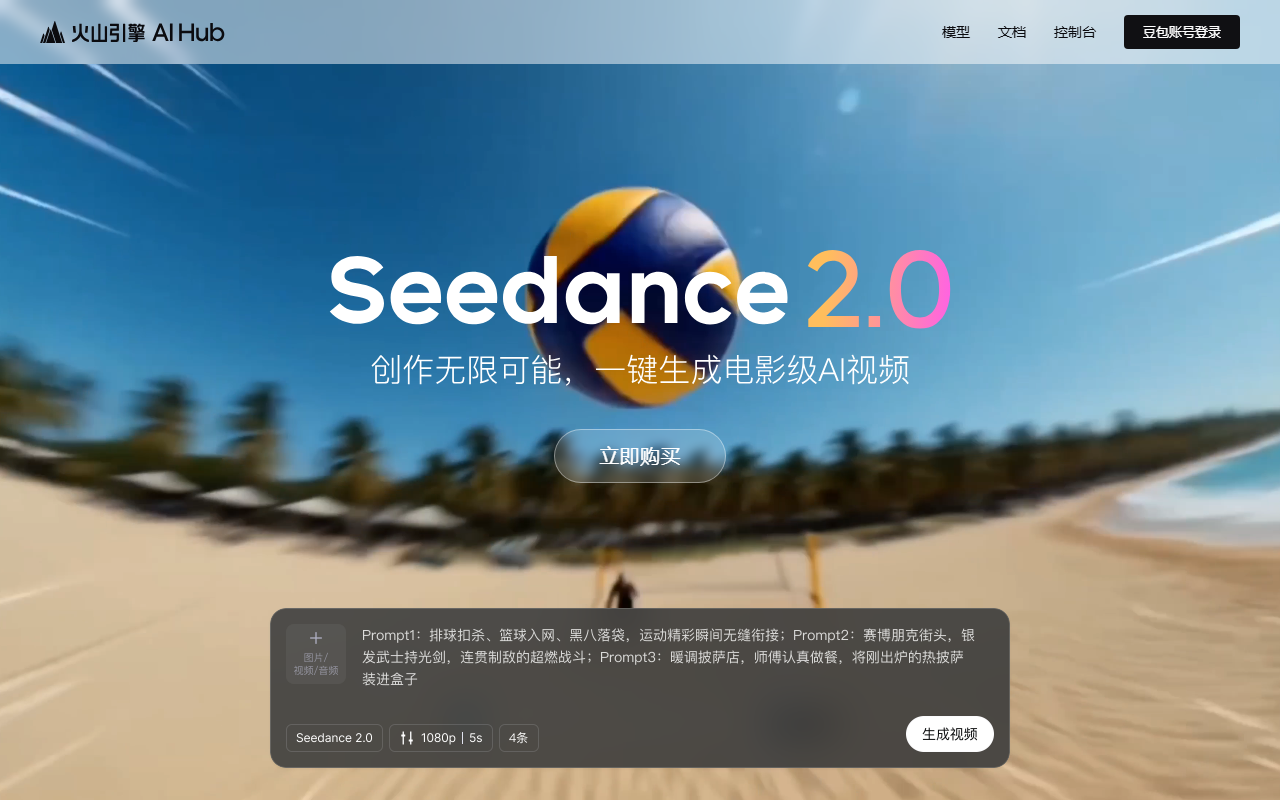
Seedance: um modelo multimodal de geração de vídeo com sincronia nativa entre imagem e áudio
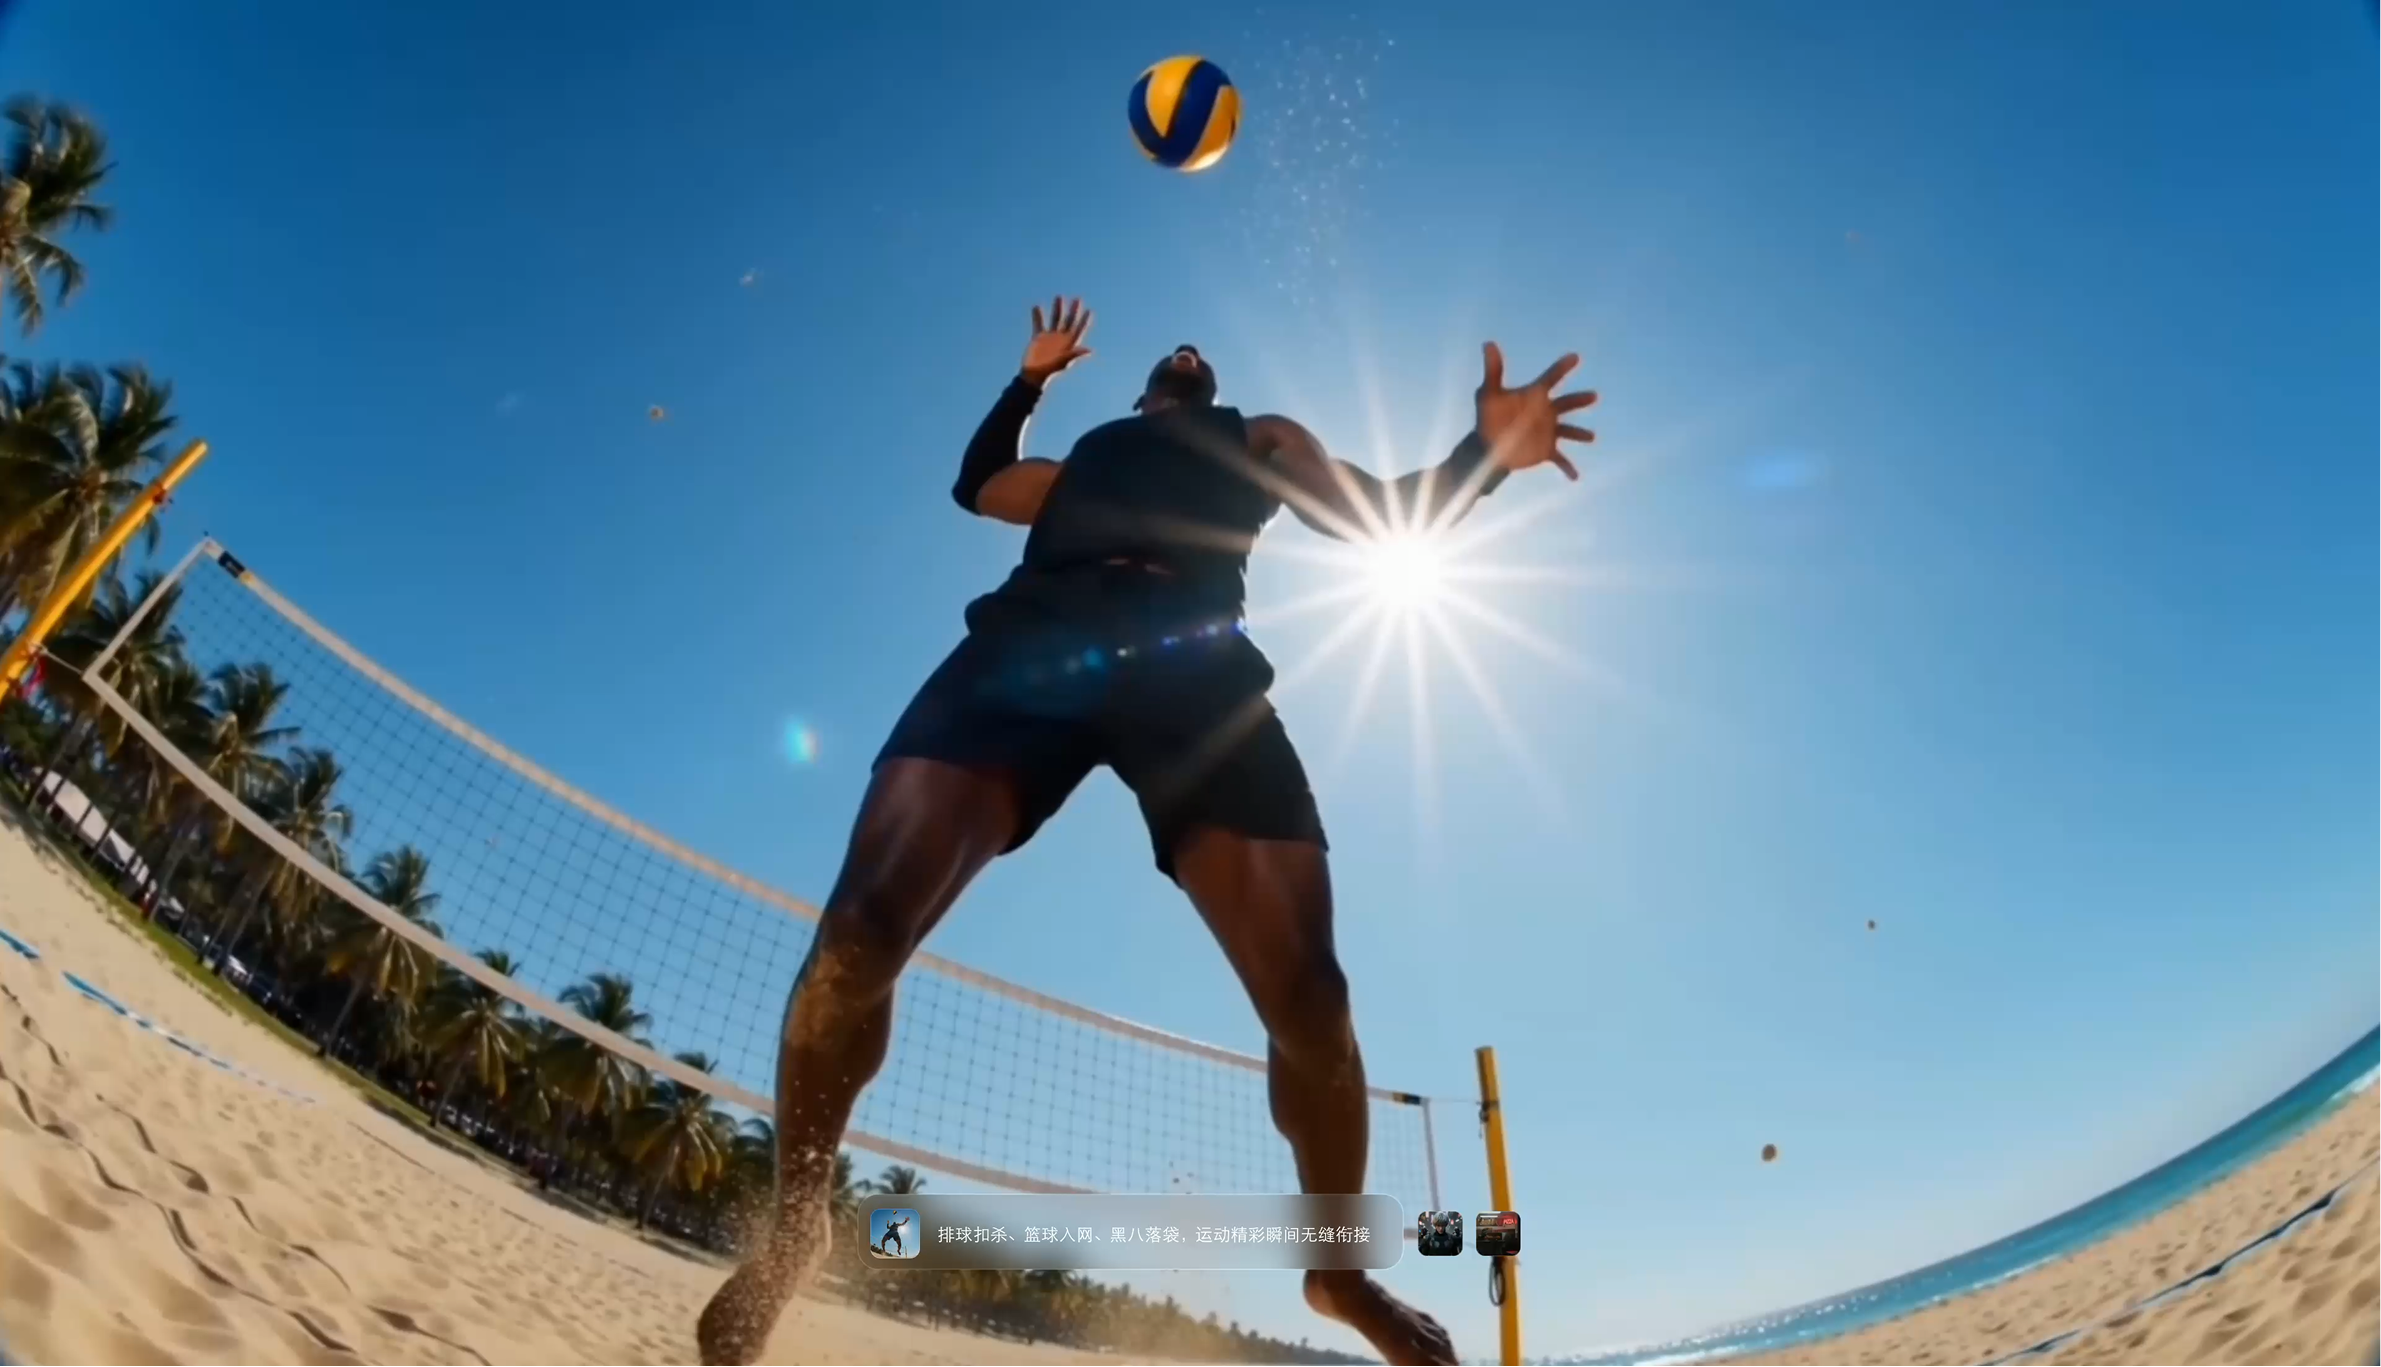
Seedance é um modelo multimodal de geração de vídeo que adota uma arquitetura unificada de geração conjunta de áudio e vídeo. A maior diferença em relação às ferramentas comuns de geração de vídeo é que texto, imagem, áudio e vídeo são modalidades de entrada com suporte nativo, e a imagem e o som são produzidos de forma sincronizada dentro de uma mesma geração, em vez de gerar primeiro um vídeo mudo e depois adicionar o áudio separadamente. Isso significa que trilha sonora, efeitos sonoros e diálogos com sincronia labial podem ser concluídos em uma única inferência, além de evitar o desalinhamento de boca e os efeitos sonoros fora de lugar comuns no fluxo de duas etapas "gerar a imagem primeiro e depois o áudio". Ele é voltado principalmente a cenários de produção de conteúdo de alta frequência, como publicidade, cinema e televisão, comércio eletrônico, jogos e educação.
Principais recursos
Entrada multimodal mista Permite combinar texto, 9 imagens, 3 vídeos e 3 áudios em uma mesma solicitação, e a sintaxe de "@menção" define com precisão o alvo de controle de cada material. Isso significa que combinar vários materiais deixa de ser apenas "juntá-los": cada um pode receber uma finalidade própria.
Geração nativa com sincronia entre imagem e áudio Com base em um transformador de difusão de dois ramos, a imagem e o áudio são processados em paralelo dentro da mesma cadeia de geração, produzindo automaticamente trilha sonora, efeitos sonoros e diálogos multilíngues com sincronia labial. A sincronia entre o diálogo e os lábios acontece em uma única geração e não exige uma etapa adicional de dublagem.
Extensão inteligente e edição de vídeo Os clipes são prolongados sem emenda em unidades de 5 segundos, mantendo a consistência de personagem, iluminação e contexto de cena, além de oferecer narrativa de múltiplos planos e controle de movimento de câmera. A consistência durante a extensão determina diretamente se o resultado final pode ser assistido de forma contínua.
Restrições de consistência de personagem e física Mantém a consistência do rosto e da forma das pessoas entre planos e usa treinamento com penalidade física para simular gravidade, fluidos e colisões. Esses são justamente os dois pontos que mais se quebram em narrativas de múltiplos planos.
Saída em várias resoluções Suporta 480p, 720p, 1080p e saída direta em 2K/4K, com duração de vídeo cobrindo clipes padrão de 4 a 15 segundos e máximo de 60 segundos.
Orientado a cenários industriais Atua principalmente em cenários de produção de conteúdo de alta frequência como publicidade, cinema, comércio eletrônico, jogos e educação, oferecendo uma solução de geração de vídeo para empresas e criadores.
Como usar
- Acesse a entrada e faça login: entre no ponto de acesso oficial e conclua o login da conta.
- Escolha um pacote de recursos: compre o pacote que melhor atende à sua necessidade. Os pacotes são medidos por cota de tokens, são compartilhados entre pessoas físicas e empresas, têm validade de 90 dias, são descontados proporcionalmente ao preço unitário do token e passam automaticamente para pagamento por uso quando a cota acaba.
- Envie os materiais de referência: digite o prompt de texto na interface de criação, envie imagens, vídeos ou áudios de referência e use a sintaxe "@" para marcar o alvo de controle de cada material.
- Configure os parâmetros de geração: escolha a resolução (de 480p a 1080p) e a duração (de 4 a 15 segundos), inicie a geração e aguarde a saída do modelo.
- Pós-produção e exportação: use as ferramentas de edição integradas para prolongar, aplicar transições ou fazer ajustes finos de sincronia entre imagem e áudio e, por fim, exportar o resultado; demandas em lote podem ser integradas à produção por meio da API.
Informações-chave e requisitos de uso
- Versão do modelo: Seedance 2.0
- Regras dos pacotes de recursos: compartilhados entre pessoas físicas e empresas, com validade de 90 dias, desconto proporcional ao preço unitário do token e conversão automática para pagamento por uso ao esgotar
- Formas de acesso: suportam operação visual no console, chamadas de API e colaboração de ponta a ponta
- Barreira de entrada: tanto usuários individuais quanto empresas podem comprar os pacotes de recursos diretamente, sem precisar montar um cluster de computação próprio
- Especificações de saída: resoluções 480p / 720p / 1080p, duração de 4 a 15 segundos e suporte a saída direta em 2K/4K no nível máximo
Pacotes de recursos
São definidos por cota de tokens, são compartilhados entre pessoas físicas e empresas e têm validade de 90 dias. Todos suportam saída multirresolução 480p/720p/1080p e ajuste de duração de 4 a 15 segundos, são descontados proporcionalmente ao preço unitário do token e alcançam uma proporção máxima de desconto de aproximadamente 1:1.8 entre resoluções e modos de entrada.
- Pacote de criação leve: 196 CNY, 7 milhões de tokens, cerca de 28 vídeos em 480p
- Pacote premium completo: 280 CNY, 10 milhões de tokens, cerca de 40 vídeos em 480p
- Pacote de produção em massa eficiente: 364 CNY, 13 milhões de tokens, cerca de 52 vídeos em 480p
Os valores acima correspondem aos preços e cotas registrados no material de origem; os pacotes e preços concretos ficam sujeitos à página de compra efetiva.
Vantagens principais
- Geração nativa integrada de imagem e áudio: imagem e som são produzidos de forma síncrona em uma única inferência, eliminando desalinhamento labial e efeitos sonoros fora de lugar
- Precisão de controle de nível industrial: é possível interpretar simultaneamente os sinais de controle de até 15 materiais de referência, permitindo dirigir personagem, movimento de câmera, ação e estilo como um diretor
- Alta taxa de aproveitamento: o aumento da taxa de geração aproveitável reduz diretamente o volume de correções manuais na pós-produção
- Ciclo de retorno de dados: apoiado em grande volume de conteúdo em vídeo curto e no retorno de dados, a compreensão de conteúdo visual de alta difusão se acumula continuamente
- Estrutura de custos flexível: oferece computação em nuvem sob demanda e pacotes de recursos escalonados, permitindo que pequenas e médias empresas entrem sem investimento pesado
Diferenças em relação a ferramentas semelhantes
As ferramentas semelhantes de geração de vídeo normalmente não são fracas em precisão de controle de referência, e cada uma tem sua própria abordagem — controle multimodal, pincel de movimento, controle de cena, entre outras. A verdadeira linha divisória está em dois pontos:
Primeiro, se o áudio é gerado de forma nativa. Algumas ferramentas entregam vídeo mudo, exigindo dublagem posterior, o que faz com que o alinhamento entre imagem e áudio dependa de trabalho manual; Seedance coloca o áudio dentro da mesma cadeia de geração.
Segundo, a duração da saída e a simulação física. Os clipes padrão da maioria das ferramentas semelhantes duram de 10 a 30 segundos e exigem várias etapas de emenda e prolongamento; Seedance permite prolongar em unidades de 5 segundos mantendo a coerência de contexto, até 60 segundos. Na simulação de leis físicas, há ferramentas que fazem apenas simulação básica de movimento e deformação, enquanto Seedance acrescenta treinamento com penalidade física para tratar gravidade, fluidos e colisões.
Na compreensão da semântica do chinês e da leitura labial, essa classe de modelos otimizada para cenários de vídeo curto em chinês costuma ter bom desempenho; a barreira de custo depende da combinação entre cota gratuita, assinatura ou pacotes de recursos.
Cenários de uso
- Produção em lote para vídeo curto e redes sociais: equipes de marketing podem partir de um acervo de materiais da marca e gerar várias versões de peças de 15 segundos a partir de descrições em texto e vídeos de referência
- Marketing visual para comércio eletrônico: com conversão de imagem em vídeo e consistência de personagem entre planos, imagens estáticas de produtos viram clipes dinâmicos com modelos, mantendo a aparência das pessoas e o estilo da cena unificados
- Produção de conteúdo localizado multilíngue: com a sincronia labial multilíngue, é possível substituir a boca e a voz do mesmo material de vídeo para adaptá-lo a diferentes mercados regionais
- Pré-visualização e storyboard criativo para cinema: gera rascunhos de storyboard a partir de instruções em texto e vídeos de referência de movimento de câmera, validando a linguagem de plano antes das filmagens
Limitações e observações
- O conteúdo gerado por IA não garante precisão de fatos nem de detalhes; cenas com logotipos de marca, aparência de produtos e afirmações de dados exigem verificação humana.
- A geração sincronizada reduz o trabalho de dublagem, mas o conteúdo de voz gerado ainda precisa ser conferido frente à formulação real do negócio.
- O limite de materiais (9 imagens, 3 vídeos, 3 áudios) restringe o volume inserido de uma só vez em cenas complexas; o excedente precisa ser processado em lotes.
- A conversão de "cerca de X vídeos em 480p" parte de uma resolução e um modo de entrada específicos; resoluções mais altas ou entradas complexas consomem mais cota.
- Preços, cotas e regras dos pacotes podem mudar; consulte a página de compra efetiva.
- O uso comercial deve seguir os termos de serviço da plataforma, e os materiais de terceiros enviados devem ter a devida autorização.
Perguntas frequentes
Qual é a diferença entre o Seedance e as ferramentas comuns de geração de vídeo?
A diferença central está em o áudio ser gerado de forma nativa. O Seedance trata texto, imagem, áudio e vídeo como modalidades de entrada com suporte nativo e produz imagem e som sincronizados em uma única geração, com trilha sonora, efeitos sonoros e diálogo multilíngue com sincronia labial automáticos; algumas ferramentas semelhantes entregam vídeo mudo e exigem dublagem posterior, deixando o alinhamento entre imagem e áudio a cargo do trabalho manual.
Quais entradas e especificações de saída o Seedance oferece?
A entrada pode combinar texto, 9 imagens, 3 vídeos e 3 áudios, com a sintaxe @menção para definir o alvo de controle de cada material. A resolução de saída pode ser 480p, 720p ou 1080p, com saída direta em 2K/4K no nível máximo; a duração cobre clipes padrão de 4 a 15 segundos, prolongáveis em unidades de 5 segundos até 60 segundos.
O que observar ao gerar vídeos com o Seedance?
O conteúdo gerado por IA não garante precisão de fatos nem de detalhes, e cenas com logotipos de marca, aparência de produtos ou dados exigem verificação humana; a voz gerada precisa ser conferida frente à formulação real do negócio; o limite de materiais restringe a entrada em cenas complexas; a conversão de número de vídeos parte de uma resolução e um modo de entrada específicos, consumindo mais cota em resoluções altas ou entradas complexas; e preços e regras dos pacotes seguem a página de compra efetiva.